
sklearn 中 make_blobs模块
# 生成用于聚类的各向同性高斯blob
sklearn.datasets.make_blobs(n_samples = 100,n_features = 2,center = 3,cluster_std = 1.0,center_box =( - 10.0,10.0),shuffle = True,random_state = None)
参数
n_samples: int, optional (default=100)
待生成的样本的总数。
n_features: int, optional (default=2)
每个样本的特征数。
centers: int or array of shape [n_centers, n_features], optional (default=3)
要生成的样本中心(类别)数,或者是确定的中心点。
cluster_std: float or sequence of floats, optional (default=1.0)
每个类别的方差,例如我们希望生成2类数据,其中一类比另一类具有更大的方差,可以将cluster_std设置为[1.0,3.0]。
center_box: pair of floats (min, max), optional (default=(-10.0, 10.0))
中心随机生成时每个聚类中心的边界框。
shuffle:布尔值,可选(默认= True)
对样本进行随机播放。
random_state:int,RandomState实例或None,可选(default = None)
如果为int,random_state是随机数生成器使用的种子; 如果RandomState实例,random_state是随机数生成器; 如果为None,则随机数生成器是np.random使用的RandomState实例。
返回
X : array of shape [n_samples, n_features]
生成的样本数据集。
y : array of shape [n_samples]
样本数据集的标签。
例子
例如要生成5类数据(100个样本,每个样本有2个特征),代码如下
from sklearn.datasets import make_blobs

from matplotlib import pyplot

data, label = make_blobs(n_samples=100, n_features=2, centers=5)

# 绘制样本显示

pyplot.scatter(data[:, 0], data[:, 1], c=label)

pyplot.show()
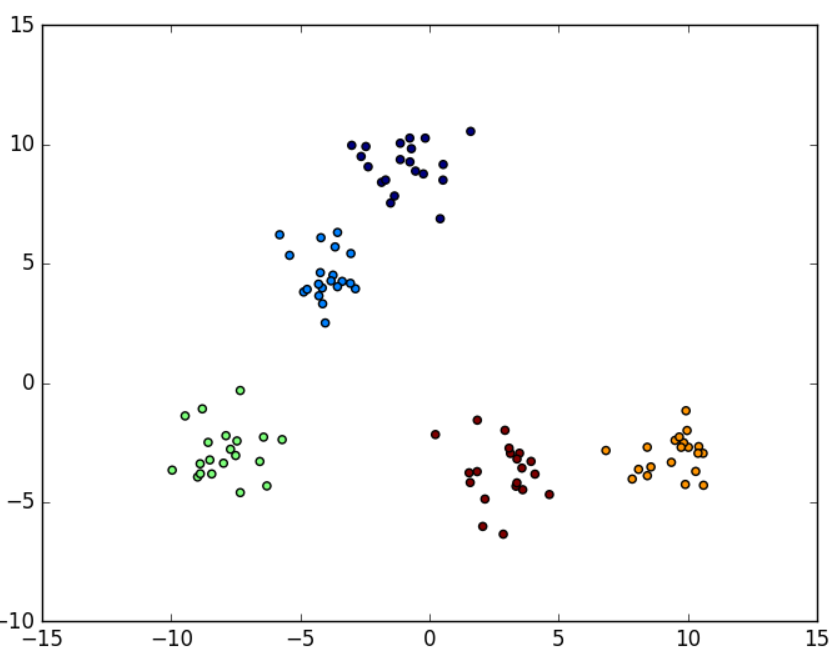
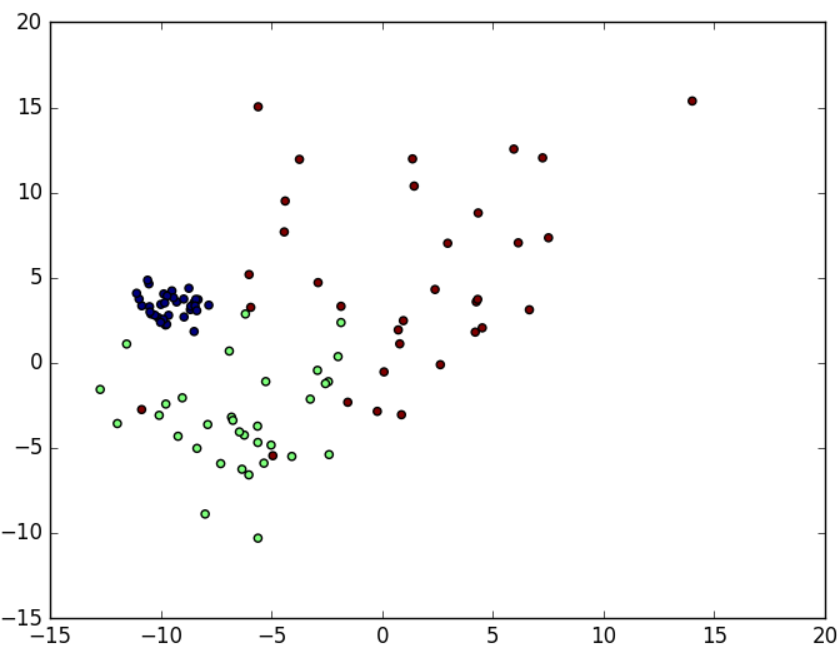
如果希望为每个类别设置不同的方差,需要在上述代码中加入cluster_std参数:
from sklearn.datasets import make_blobs

from matplotlib import pyplot

data, label = make_blobs(n_samples=10, n_features=2, centers=3, cluster_std=[0.8, 2.5, 4.5])

# 绘制样本显示

pyplot.scatter(data[:, 0], data[:, 1], c=label)

pyplot.show()
sklearn 中 make_blobs模块的更多相关文章
- sklearn 中 make_blobs模块使用
sklearn.datasets.make_blobs(n_samples=100, n_features=2, centers=3, cluster_std=1.0, center_box=(-10 ...
- 【集成学习】sklearn中xgboost模块的XGBClassifier函数
# 常规参数 booster gbtree 树模型做为基分类器(默认) gbliner 线性模型做为基分类器 silent silent=0时,不输出中间过程(默认) silent=1时,输出中间过程 ...
- 【集成学习】sklearn中xgboost模块中plot_importance函数(绘图--特征重要性)
直接上代码,简单 # -*- coding: utf-8 -*- """ ################################################ ...
- sklearn中xgboost模块中plot_importance函数(特征重要性)
# -*- coding: utf-8 -*- """ ######################################################### ...
- 【集成学习】sklearn中xgboot模块中fit函数参数详解(fit model for train data)
参数解释,后续补上. # -*- coding: utf-8 -*- """ ############################################## ...
- sklearn中的metrics模块中的Classification metrics
metrics是sklearn用来做模型评估的重要模块,提供了各种评估度量,现在自己整理如下: 一.通用的用法:Common cases: predefined values 1.1 sklearn官 ...
- python中导入sklearn中模块提示ImportError: DLL load failed: 找不到指定的程序。
python版本:3.7 平台:windows 10 集成环境:Anaconda3.7 64位 在jupyter notebook中导入sklearn的相关模块提示ImportError: DLL l ...
- sklearn中的KMeans算法
1.聚类算法又叫做“无监督分类”,其目的是将数据划分成有意义或有用的组(或簇).这种划分可以基于我们的业务需求或建模需求来完成,也可以单纯地帮助我们探索数据的自然结构和分布. 2.KMeans算法将一 ...
- sklearn中的模型评估-构建评估函数
1.介绍 有三种不同的方法来评估一个模型的预测质量: estimator的score方法:sklearn中的estimator都具有一个score方法,它提供了一个缺省的评估法则来解决问题. Scor ...
随机推荐
- flash播放器插件与flash播放器的区别
flash插件是一个网页ActiveX控件,而flash播放器是一个exe的可执行程序.前者用于播放网页中的falsh动画,而后者用于播放本地swf格式文件.
- Win7系统64位环境下使用Apache——安装Apache2.4时报错“Invalid command Order”问题的解决
之前在文章Win7系统64位环境下使用Apache--Apache2.4整合Tomcat与mod_jk提到了安装Apache2.4时有可能报错: Invalid command 'Order', pe ...
- for-in 的坑
for-in 循环的下标为字符串,不是数字 var ar=[13,2,13,14]; function isSort(ar){ for(var i in ar){ console.log(i+':'+ ...
- ubuntu 上查看文件的内容,二进制形式展现
Vim 可以用来查看和编辑二进制文件 vim -b egenea-base.ko 加上-b参数,以二进制打开 然后输入命令 :%!xxd -g 1 切换到十六进制模式显示
- 【解题报告】牡丹江现场赛之ABDIK ZOJ 3819 3820 3822 3827 3829
那天在机房做的同步赛,比现场赛要慢了一小时开始,直播那边已经可以看到榜了,所以上来就知道A和I是水题,当时机房电脑出了点问题,就慢了好几分钟,12分钟才A掉第一题... A.Average Score ...
- 前端工程师面试问题归纳(二、问答类JQ相关)
其他随笔 前端工程师面试问题归纳(一.问答类html/css/js基础) 前端工程师面试问题归纳(三.代码类) 1. jQuery 库中的 $() 是什么? $() 函数是 jQuery() 函数的别 ...
- gulp 集成其他基于流的工具
1. 流.缓冲.vinyl 文件对象 gulp 的流是虚拟文件对象 包含的属性有 base 文件名 path 文件路径 content 缓冲.nodejs 流 2. gulp 集成 browserif ...
- jQuery的ajax跨域实现
今天有人问我跨域ajax请求是否可以发送,之前没接触过此类问题,没答上,后来查了下,以下备忘. 我在本地建了三个站点,并设置了host文件模拟跨子域和跨全域 coolkissbh.com blog.c ...
- 洛谷3778 [APIO2017]商旅
题目:https://www.luogu.org/problemnew/show/P3778 一看就是0/1分数规划.但不能直接套模板,因为有个商品种类的限制. 考虑从a买在b卖,商品种类根本没用,关 ...
- 30G 的redis 如何优化
突然发现我们的redis 已经用了30G了,好吧这是个很尴尬的数字因为我们的缓存机器的内存目前是32G的,内存已经告竭.幸好上上周公司采购了90G的机器,现在已经零时迁移到其中的一台机器上了.(跑题下 ...