
Spark Streamming 基本输入流I(-) :File/Hdfs
Spark Streamming 基本输入流I(-):从文件中进行读取
文件读取1:本地文件读取
这里我只给出实现代码及操作步骤
1、在本地目录下创建目录,这里我们创建目录为~/log/
2、然后手动在~/目录下创建两个文件夹。t1.dat ,t2.dat
t1.dat 格式如下:
hello hadoop
hello spark
hello Java
hellp hbase
hello scala
t2.dat格式如下:
My name is Brent,
how are you
nice to meet you
3、编写spark streamming程序,并将其运行起来。
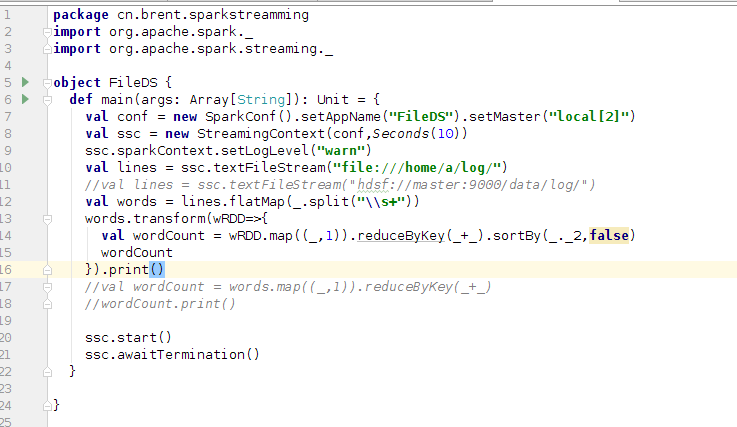
4、使用命令cp ~/t*.dat ./log/ 将t1.dat ,t2.dat移动到~/log目录下,
5、查看spark Streamming程序的运行情况。
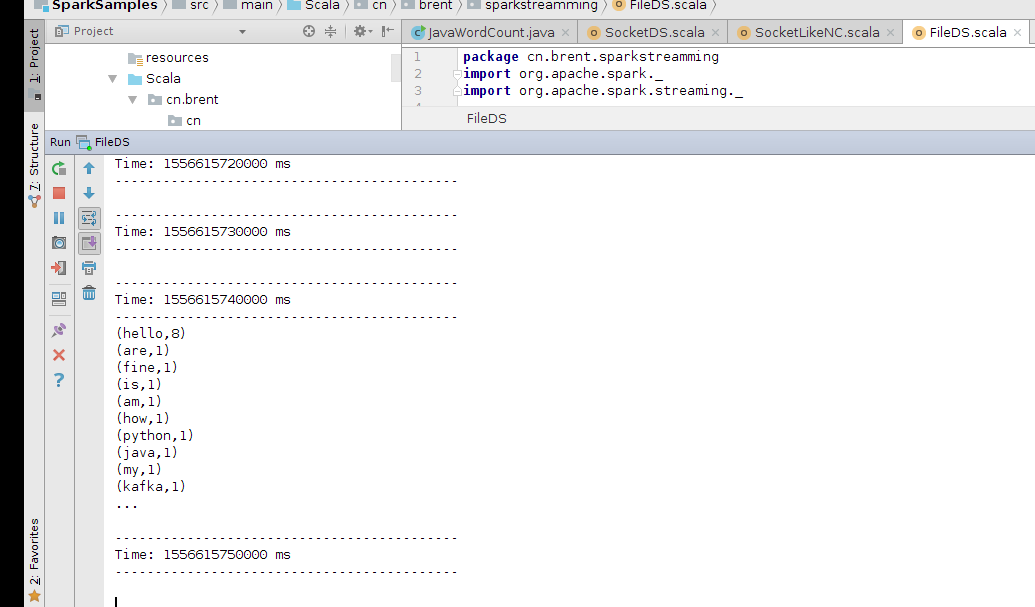
文件读取2:HDFS文件读取
HDFS文件读取和本地是相差无几的,
不同之处如下
程序中修改文件引入路径//val lines = ssc.textFileStream("hdsf://master:9000/data/log/")
本地文件t1.dat 和 t2.dat 需要上传到hdfs://master:9000/data/log下
hdfs dfs -mkdir data/log 创建目录。
hdfs dfs -put t*.dat data/log/
注意点:
文件作为输入流容易出错的一点就是,目录下面的文件一定要是cp进来,而不是mv进来了,因为cp进行的文件时间戳是改变的,而mv进来的时间戳没有改变,spark Streamming就不会进行处理。
Spark Streamming 基本输入流I(-) :File/Hdfs的更多相关文章
- Spark Streamming 基本输入流(二) :Socket
Spark Streamming 可以通过socket 进行数据监听. socket的输入方可以通过nc 或者自己开发nc功能的程序. 1.系统自带的nc su root a yum install ...
- Spark2.x(五十五):在spark structured streaming下sink file(parquet,csv等),正常运行一段时间后:清理掉checkpoint,重新启动app,无法sink记录(file)到hdfs。
场景: 在spark structured streaming读取kafka上的topic,然后将统计结果写入到hdfs,hdfs保存目录按照month,day,hour进行分区: 1)程序放到spa ...
- ParquetDecodingException: Can not read value at 0 in block -1 in file hdfs:...
: jdbc:hive2://master01.hadoop.dtmobile.cn:1> select * from cell_random_grid_tmp2 limit 1; INFO : ...
- kettle在本地执行向远程hdfs执行转换错误"Couldn't open file hdfs"
kettle在本地执行向远程hdfs执行转换时,会出现以下错误: ToHDFS.0 - ERROR (version 7.1.0.0-12, build 1 from 2017-05-16 17.18 ...
- ERROR: Found lingering reference file hdfs
Found lingering reference异常 ERROR: Found lingering reference file hdfs://jiujiang1:9000/hbase/month_ ...
- Spark No FileSystem for scheme file 解决方法
在给代码带包成jar后,放到环境中运行出现如下错误: Exception in thread "main" java.io.IOException: No FileSystem f ...
- 通过Spark SQL关联查询两个HDFS上的文件操作
order_created.txt 订单编号 订单创建时间 -- :: -- :: -- :: -- :: -- :: order_picked.txt 订单编号 订单提取时间 -- :: ...
- MapReduce 踩坑 - hadoop No FileSystem for scheme: file/hdfs
一.场景 hadoop-3.0.2 + hbase-2.0.0 一个mapreduce任务,在IDEA下本地提交到hadoop集群可以正常运行. 现在需要将IDEA本地项目通过maven打成jar包, ...
- Spark设置自定义的InputFormat读取HDFS文件
本文通过MetaWeblog自动发布,原文及更新链接:https://extendswind.top/posts/technical/problem_spark_reading_hdfs_serial ...
随机推荐
- windows 系统C盘暴增
系统: Windows Server 2012R2 问题: C盘200G的空间,暴增剩余3G.但是查看仅有69G的空间占用. 根源:Windows的虚拟文件,驱动器分页. 解决方案: 我的电脑-> ...
- (转)[Shell]tr命令详解
原文:http://blog.csdn.net/sunnyyoona/article/details/52986893 1. 用途 tr,translate的简写,主要用于压缩重复字符,删除文件中的控 ...
- Oracle 基础系列之1.3 用户管理
一.概述 1.当我们使用sysdba创建一个新用户时,该用户是没有任何权限的,甚至连登录数据库的权限都没有,代码如下: 这里使用sysdba创建了一个用户名为'zc'的新用户,接着输入代码进行登录 e ...
- 【计算机网络】HTTP请求和响应格式
HTTP请求格式:<request-line><headers><blank line>[<request-body>]说明:第一行必须是一个请求行(r ...
- ssh免密码登录快速配置方法
环境需求: 两台Linux主机 A (192.168.3.101)和 B(192.168.3.102),如何使用主机 A 免密码登录 主机B ? 配置步骤: 首页登录主机 A ,在主机A上生成自己 ...
- js 用简单案例举模态对话框弹出
<!DOCTYPE html><html lang="en"><head> <meta charset="UTF-8" ...
- IDEA中一个工程多个模块(module)分别提交到不同的git服务器
说明:本文档适用于一个工程多个模块的项目,每个模块对应不同的git服务器地址. 一.将本地项目导入到git服务器 1.打开 File -> Settings,选择 Version C ...
- SQL Server 2008 R2如何开启数据库的远程连接(转)
SQL Server 2008默认是不允许远程连接的,如果想要在本地用SSMS连接远程服务器上的SQL Server 2008,远程连接数据库.需要做两个部分的配置: SQL Server Manag ...
- CocoaPods管理的项目移植到别人电脑后找不到头文件
CocoaPods管理的项目移植到别人电脑后找不到头文件 在TARGETS -> Search Paths -> User Header Search Paths 中 写入 ${SRCRO ...
- mybooklist.cn 书单de故事六月十六日
1.我的30年30本书 刘苏里书单北京万圣书园总经理,以经营人文社科类图书著称.生于1960年,1983年毕业于北京大学国际政治系,1986年毕业于中国政法大学研究生院.