
聚类算法在 D2C 布局中的应用
1.摘要
聚类是统计数据分析的一门技术,在许多领域受到广泛的应用,包括机器学习、数据挖掘、图像分析等等。聚类就是把相似的对象分成不同的组别或者更多的子集,从而让每个子集的成员对象都有相似的一些属性。
所谓聚类算法,其实就是将一对没有标签的数据自动划分成几类的方法。在应用场景上,聚类能帮助我们解决很多计算机中的分类问题,常见的如:颜色类别分类、空间坐标中的密度分类、电商中的人群特征分类。除了分类问题外,它也能帮助我们实现“异常检查”,什么是异常检查?我们可以理解为找噪点,通俗来说就是在一锅粥里面找出那些老鼠屎。
本篇文章主要是给大家介绍聚类算法的实现原理以及聚类算法是如何应用在 D2C 设计稿生成代码中。
2 DBSCAN 聚类算法
DBSCAN - 具有噪声的基于密度的聚类算法。和 K-Means 这种只适合凸样本集的聚类相比,DBSCAN 既可以凸样本集,也适用于非凸样本集。它可以对散乱的样本基于一定的相似性进行分类,即在不确定蔟数目的情况下,根据样本的紧密程度进行蔟的划分。举个例子:
我们需要把“100、101、123、98、200、203、220”这堆数据进行聚类。成蔟最小值为 2的话,
此时如果我们设置的聚类密度阈值为 30。那么“100、101、123、98” 和 “200、203、220”将会分成 2 蔟。
当聚类密度阈值为 10。那么“100、101、98”、“200、203”、分成 2 个蔟,“123”、“220”则属于噪声点(异常数据)
2.1 核心思想
DBSCAN 算法主要是找出样本点中所有的密集区域,我们称这些密集区域为聚类蔟。那么不在密集区域内的样本点,我们称为噪声点。所以 DBSCAN 除了能帮你做分类外,也能找出“一锅粥里面的老鼠屎”。
2.2 算法参数
| 参数 | 说明 |
|---|---|
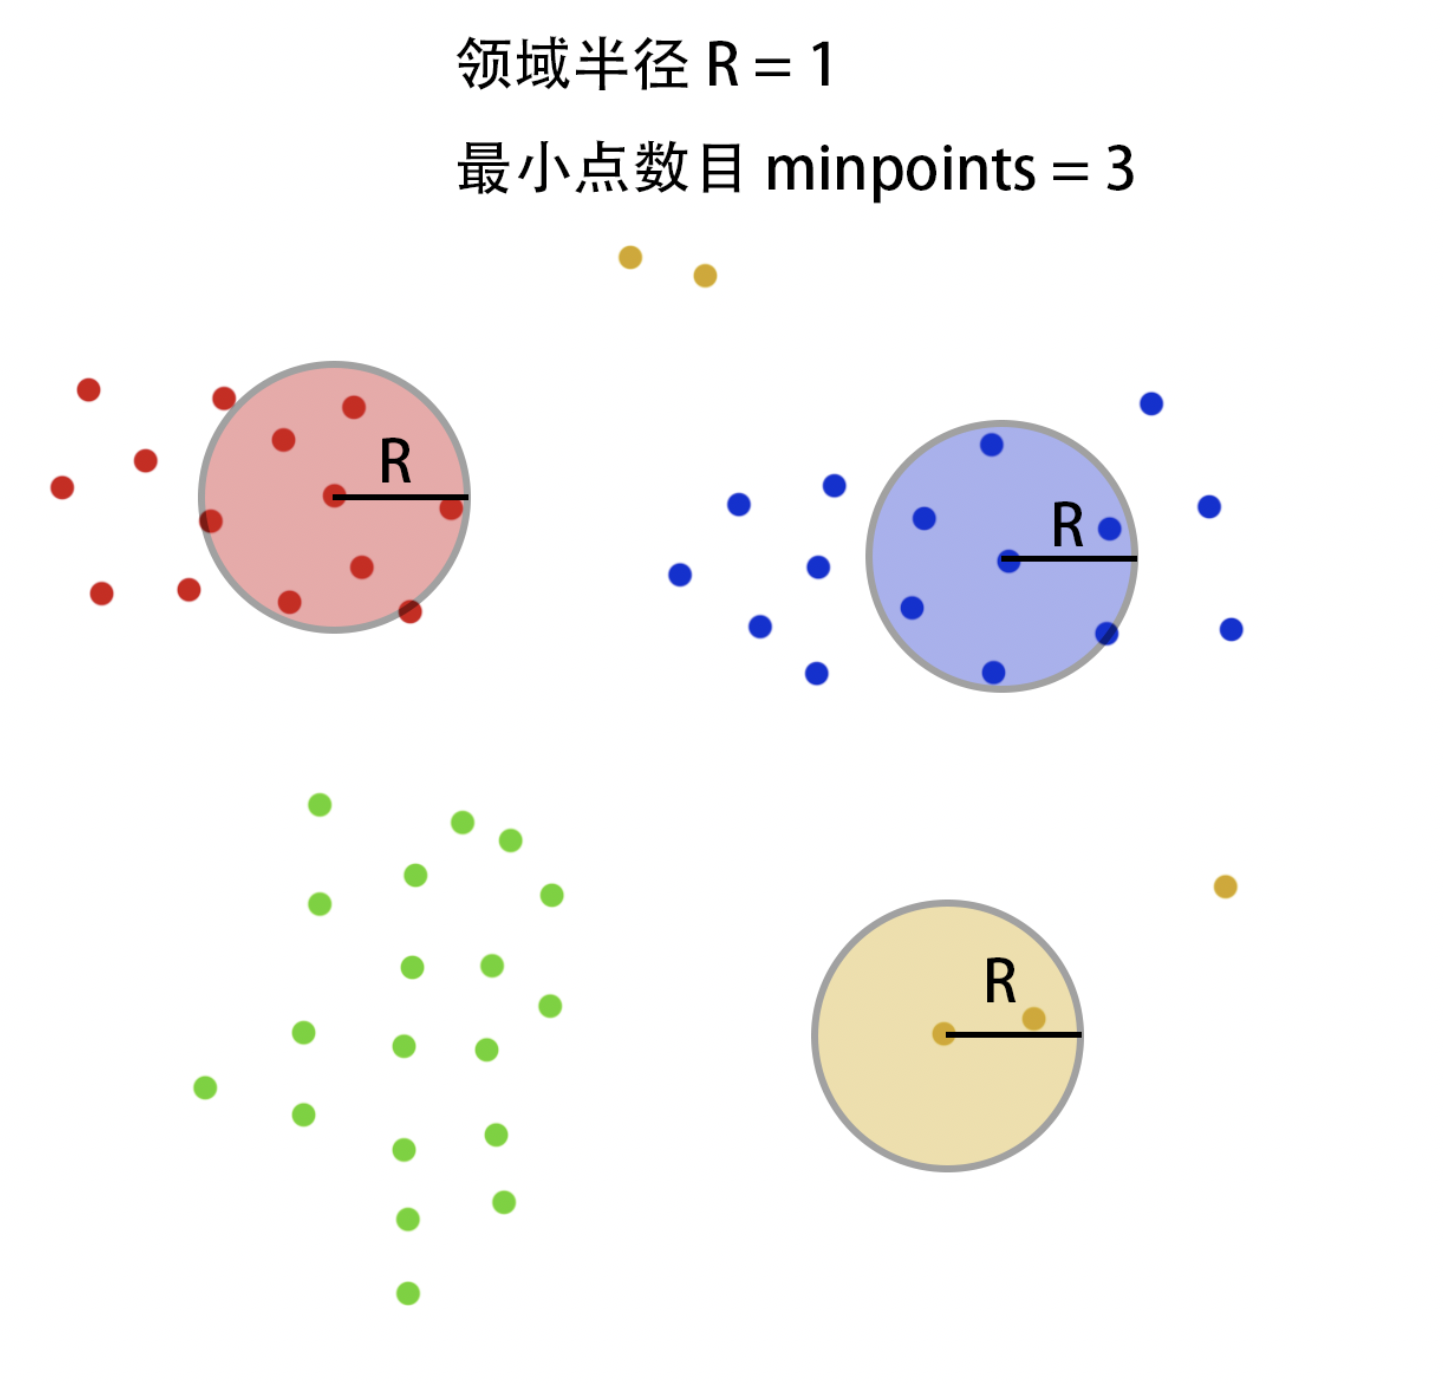
| 邻域半径 Eps: | 指的是每个样本点的搜索半径,在搜索半径内扫描到的其他样本点,我们可以理解为被扫描到的样本点与中心点是相近的 。 |
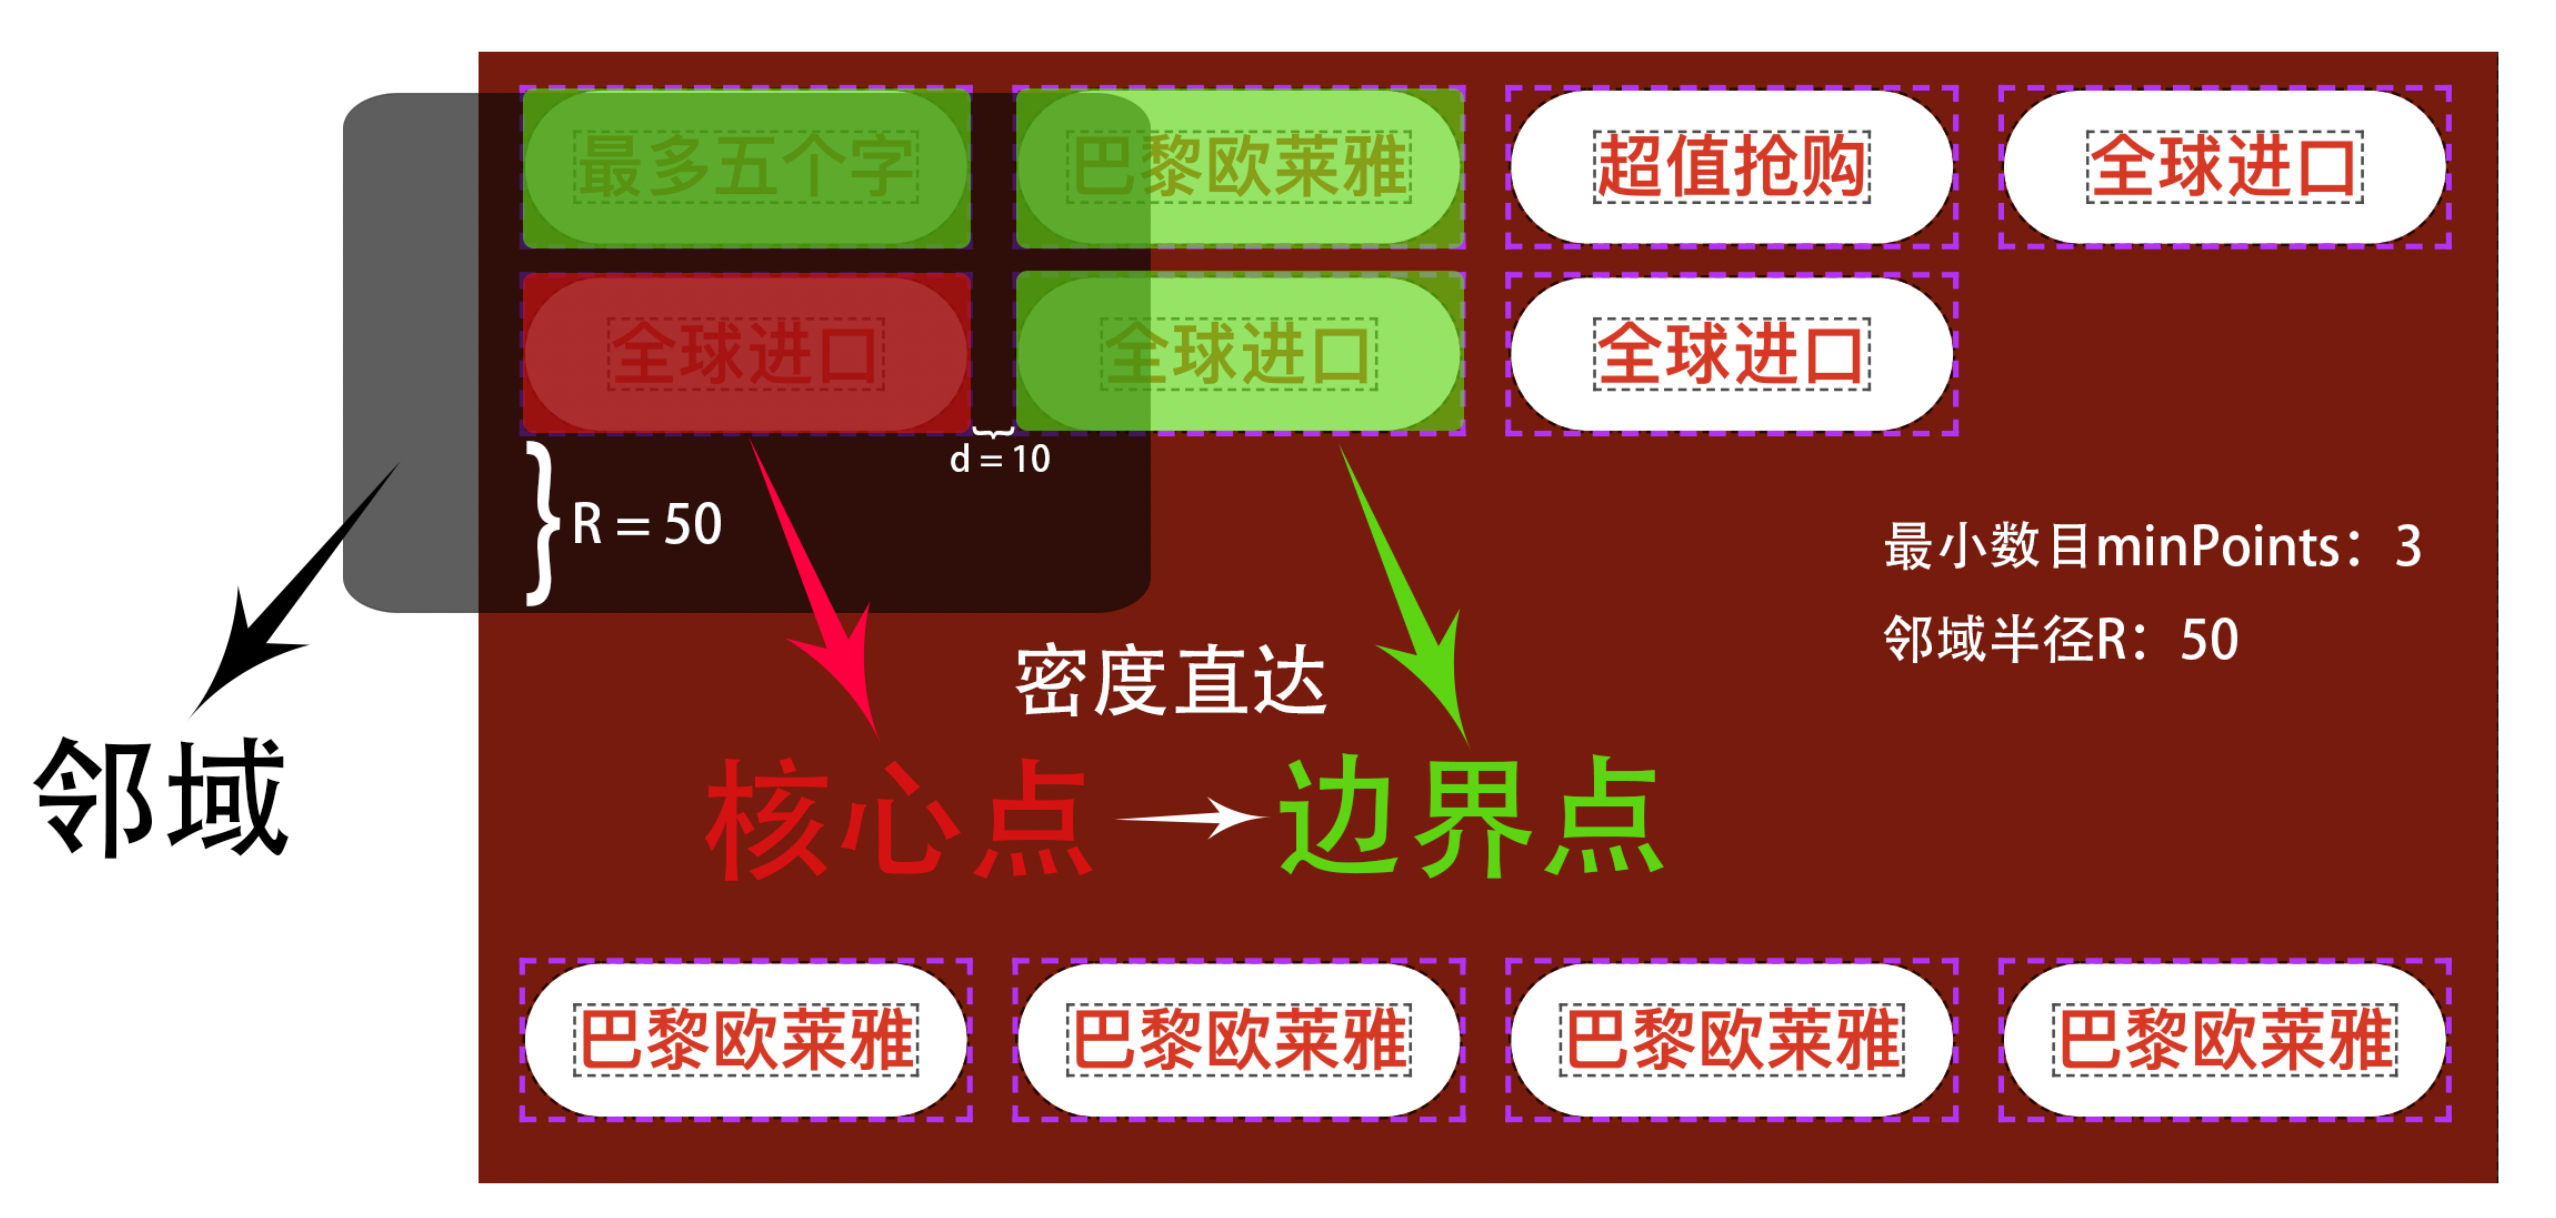
| 最小点数目 minpoints: | 能聚合成簇的最小样本数目,可以理解为每个蔟需要的最少样本数。在上图上,我们可以看到红色、蓝色在半径 R 内均扫描到的样本点>最小点数目 minpoints,而黄色仅扫描的数量比 minpoints 要少。 |
2.3 点的类别
| 类别 | 说明 |
|---|---|
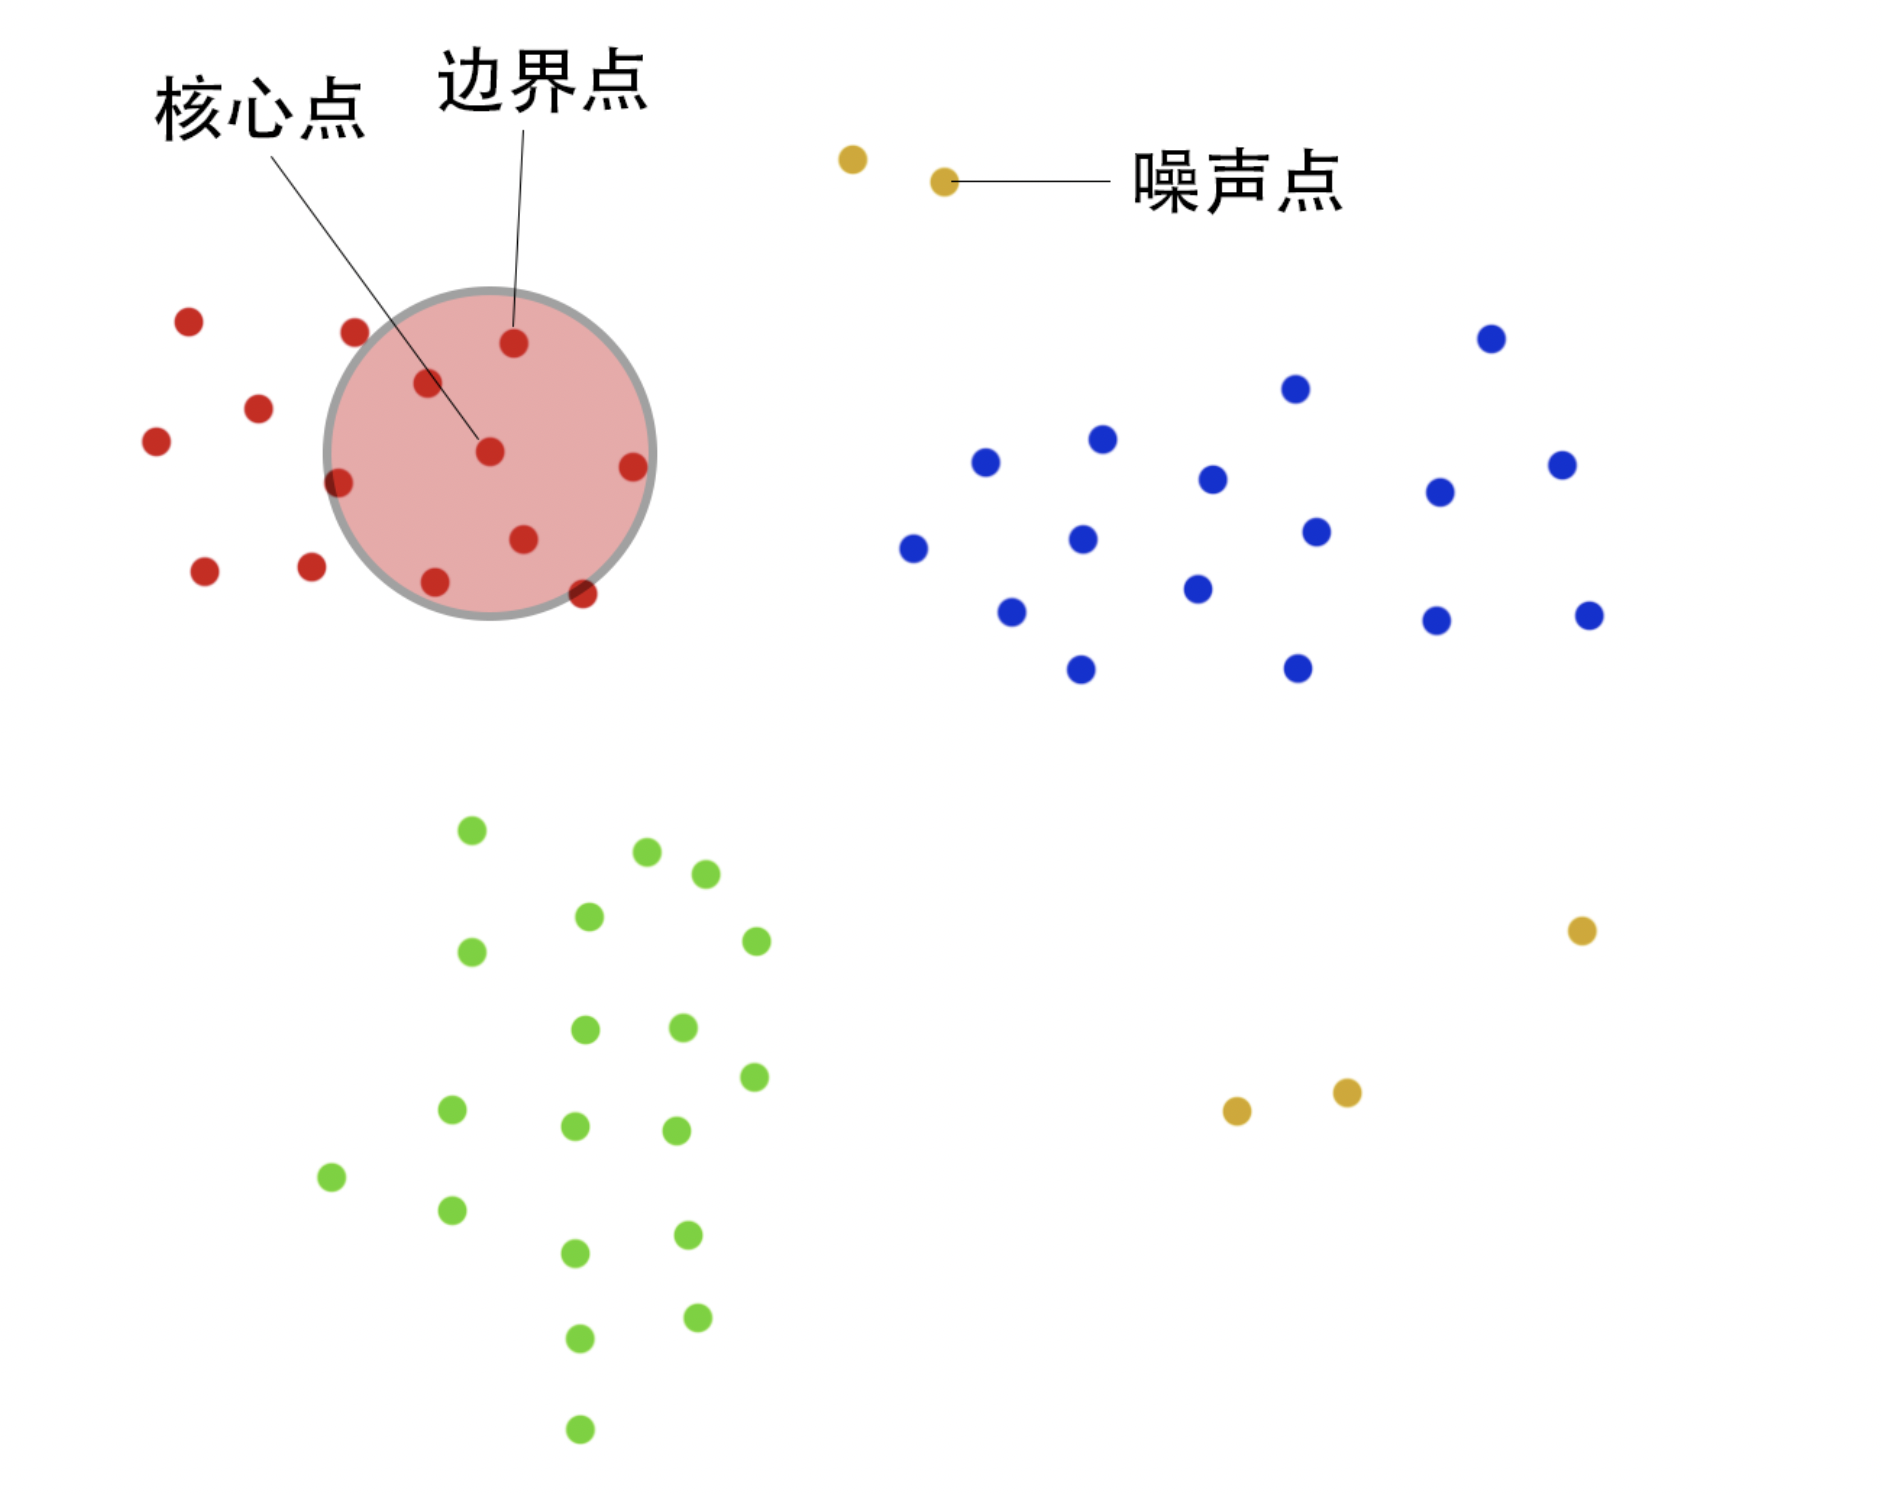
| 核心点 | 邻域半径 Eps 内样本点的数目 >= 最小点数目 minpoints 的点。 |
| 边界点 | 不属于核心点但在某个核心点的邻域内的点。 |
| 噪声点 | 既不是核心点也不是边界点。 |
2.4 点的关系
| 关系 | 说明 |
|---|---|
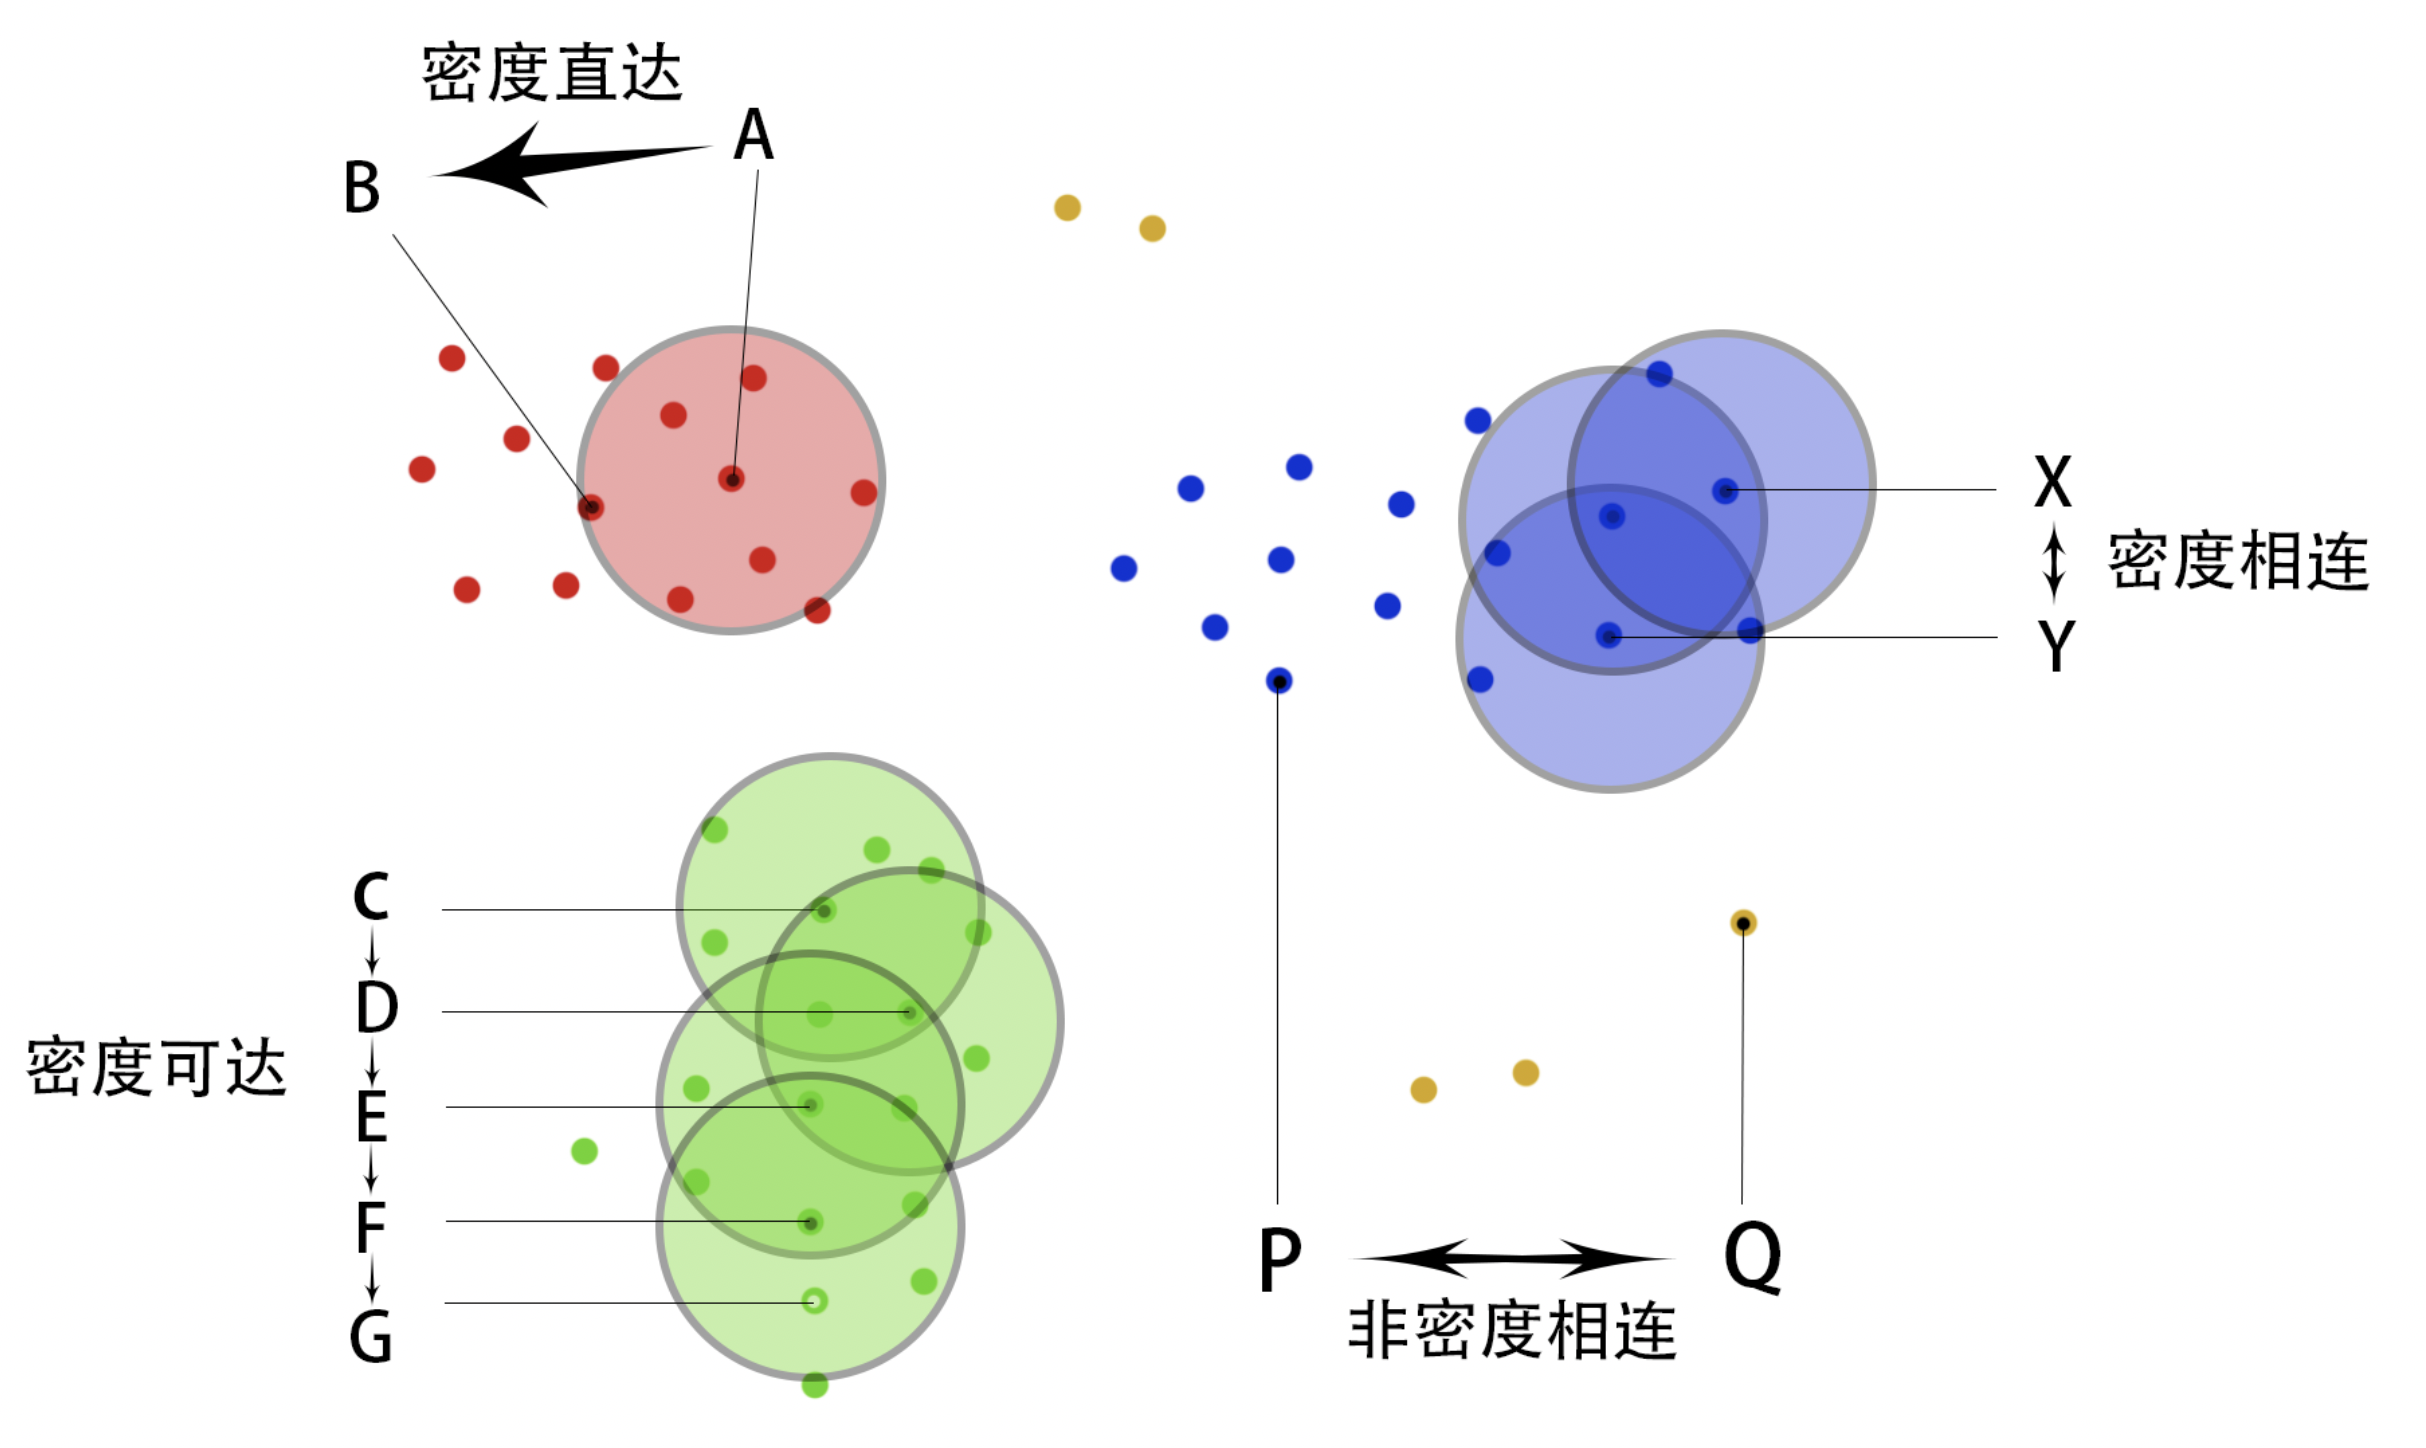
| 密度直达 | A 为核心点,B 在 A 的邻域 Eps 内,那么 A 到 B 密度直达。任何核心点到其邻域 Eps 内的边界点都是密度直达。 |
| 密度可达 | 如果存在核心点 C、D、E、F。C 到 D 密度直达,D 到 F 密度直达,E 到 F 密度直达。那么我们可以称 C 到 F密度可达。而 F(核心点)到 G(边界点)也是密度直达,C 到 G 也是密度可达。 |
| 密度相连 | 如果存在核心点使得样本点 X 跟样本点 Y 都密度可达,那么我们称 X 与 Y 密度相连。 |
| 非密度相连 | 不属于密度相连的话就是非密度相连,非密度相连的两个点属于不同的蔟,或者其中为噪声点。 |
2.5 算法实现步骤
由密度可达关系导出的最大密度相连的样本集合,即为我们最终聚类的一个类别,或者说一个簇。在实现上我们可以分为以下 4 步:
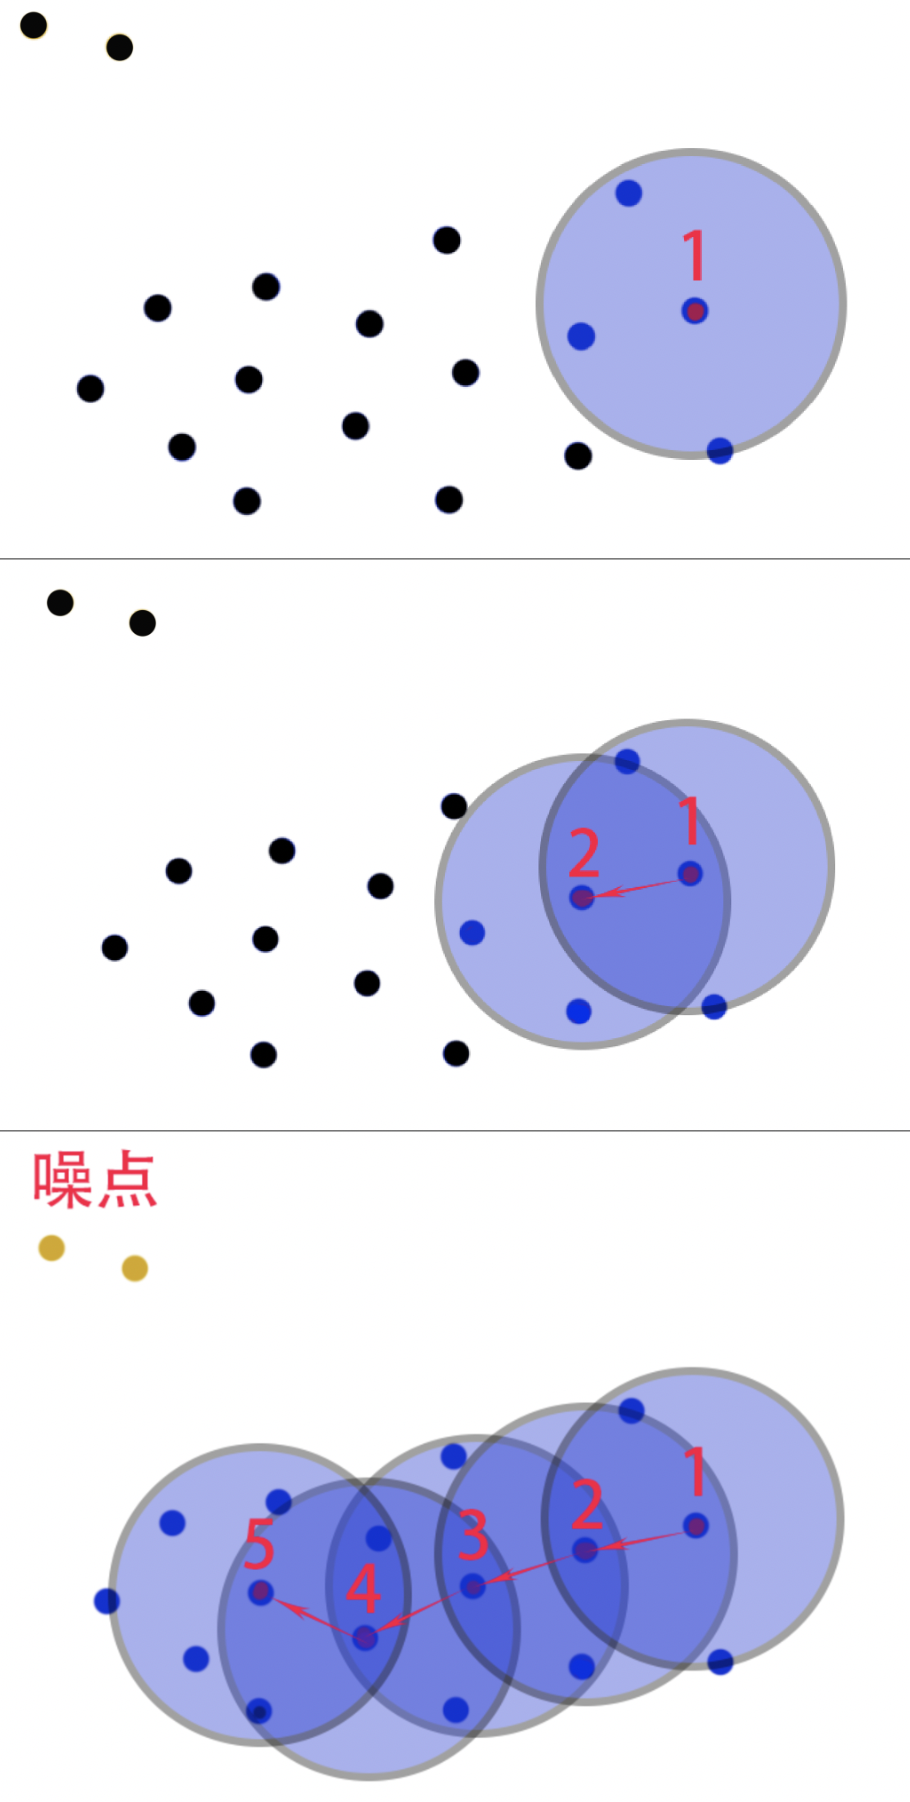
步骤 1:选择任意一个没有类别的核心地点作为初始点;
步骤 2:找出这个核心点能够密度可达的样本集合,也就是找出这个核心点邻域内的所有边界点,这时就可以成为一个聚类蔟;
步骤 3:继续找另外一个没有类别的核心点继续重复步骤 2 的操作;
步骤 4:直到所有的点。
来点比较生动的例子:你可以假设一群人里面有个做传销的人(核心点),要发展下线,需要先找 N 个人(minPoints),于是他就在身边(邻域)去找人发展下线,那么下线(边界点)就会继续找下线,直到身边没人。
3 布局算法与 DBSCAN 的结合
简单介绍完 DBSCAN 的算法概念和算法实现后,我们讲一下聚类算法在 Deco 布局算法中的应用场景。
布局算法核心其实就是成组,如何基于设计稿每个模块的位置信息和大小尺寸来判断是否能组成成组是关键,简单来说,就是如何准确的把一堆节点拿个DIV套住。
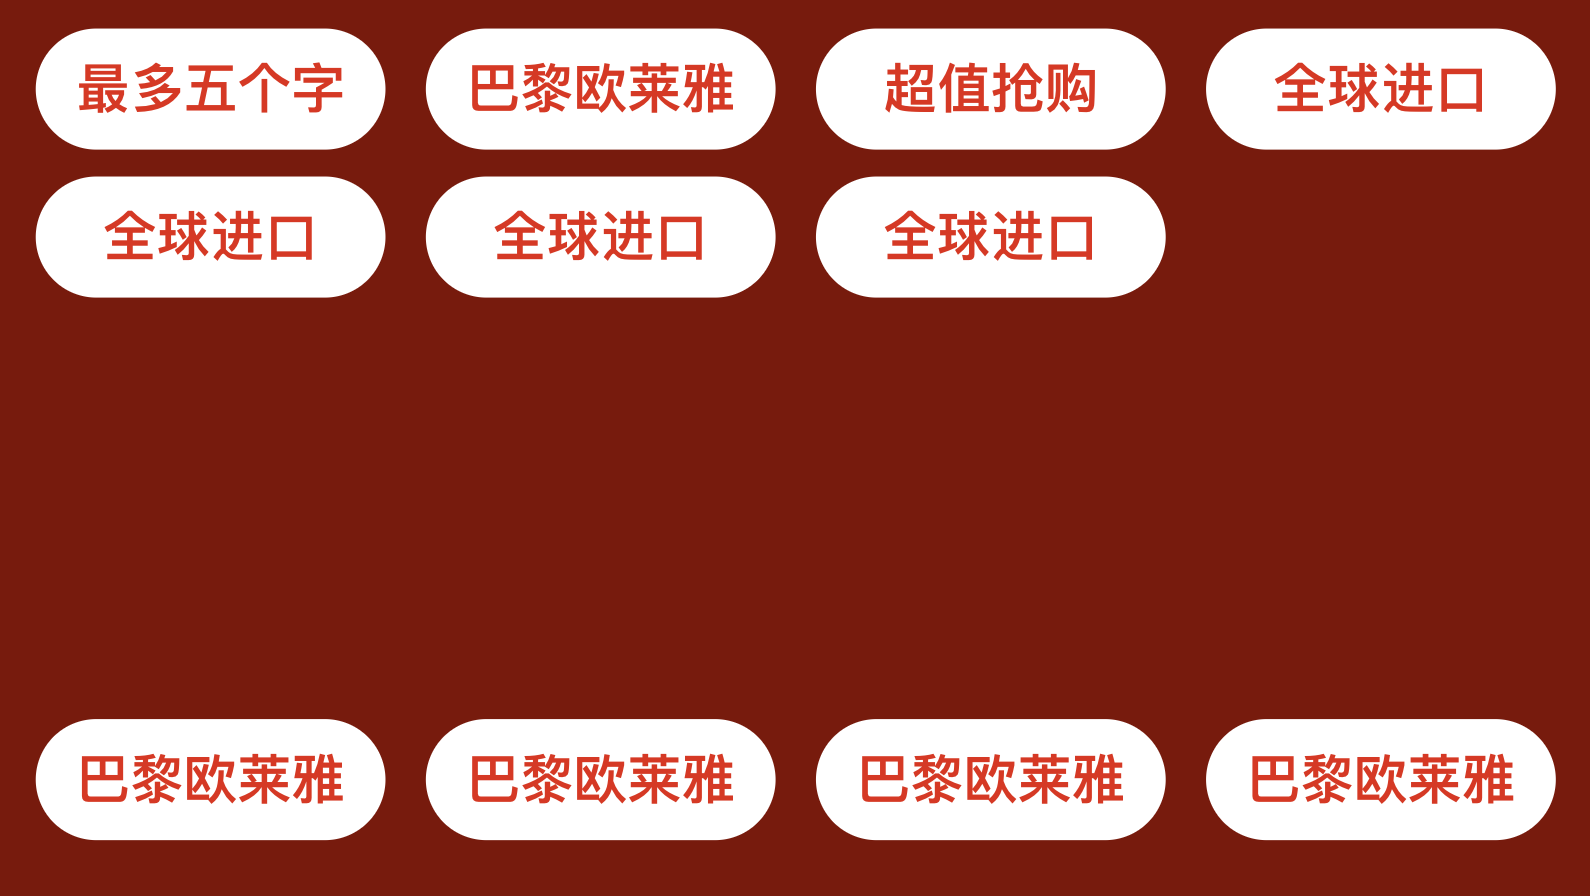
如上图所示,设计稿上存在 11 个白色区块节点的节点,而我们肉眼去看,以每个节点之间的紧密距离关系来作为依据,上半部分和下半部分是分开的。但是这仅限于我们的视觉,那如何让机器的视觉也认为是分开的呢?我们需要刚刚提到的DBSCAN 聚类算法进行蔟的生成,那么我们的目标是让上半部分会形成一个聚类蔟,下半部分也组成一个聚类蔟。
刚刚我们提到 DBSCAN 是点到点之间的欧式距离作为紧密关系的依据,那么在节点上来看的话,我们转变下思路,改为 区块与区块之间的最短距离作为紧密关系的依据。
3.1 点状距离 > 区块距离
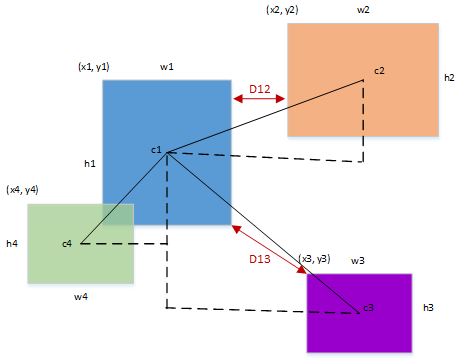
其实获取区块之间的最短距离比较简单,有三种情况:
第一种:两个区块相交,那么距离其实就是 0 了;
第二种:A 区块与 B 区块是在其上/下/左/右的,那么只需要获取两者之间的间距位置即可;
第三种:A 区块与 B 区块是在其左上/左下/右上/右下的,那么采用勾股定理获取下两者相对的顶点之间斜线的距离即可。
改造之后的效果就是下图的样子,我们根据聚类算法的实现,最终就可以把上下 2 个分成 2 个聚类蔟:
3.2 邻域半径推导
DBSCAN 聚类算法除了输入中,有样本数据集、数据对象数目阈值 MinPoints、邻域半径 Eps,那么带布局算法中,邻域半径 Eps到底设多少才是合适的值呢?总不能是个固定值吧。有些模块间距的整体大一点,有些间距小一点,我们在实际布局对区块做聚合的时候需要求出这个动态的邻域半径 Eps。
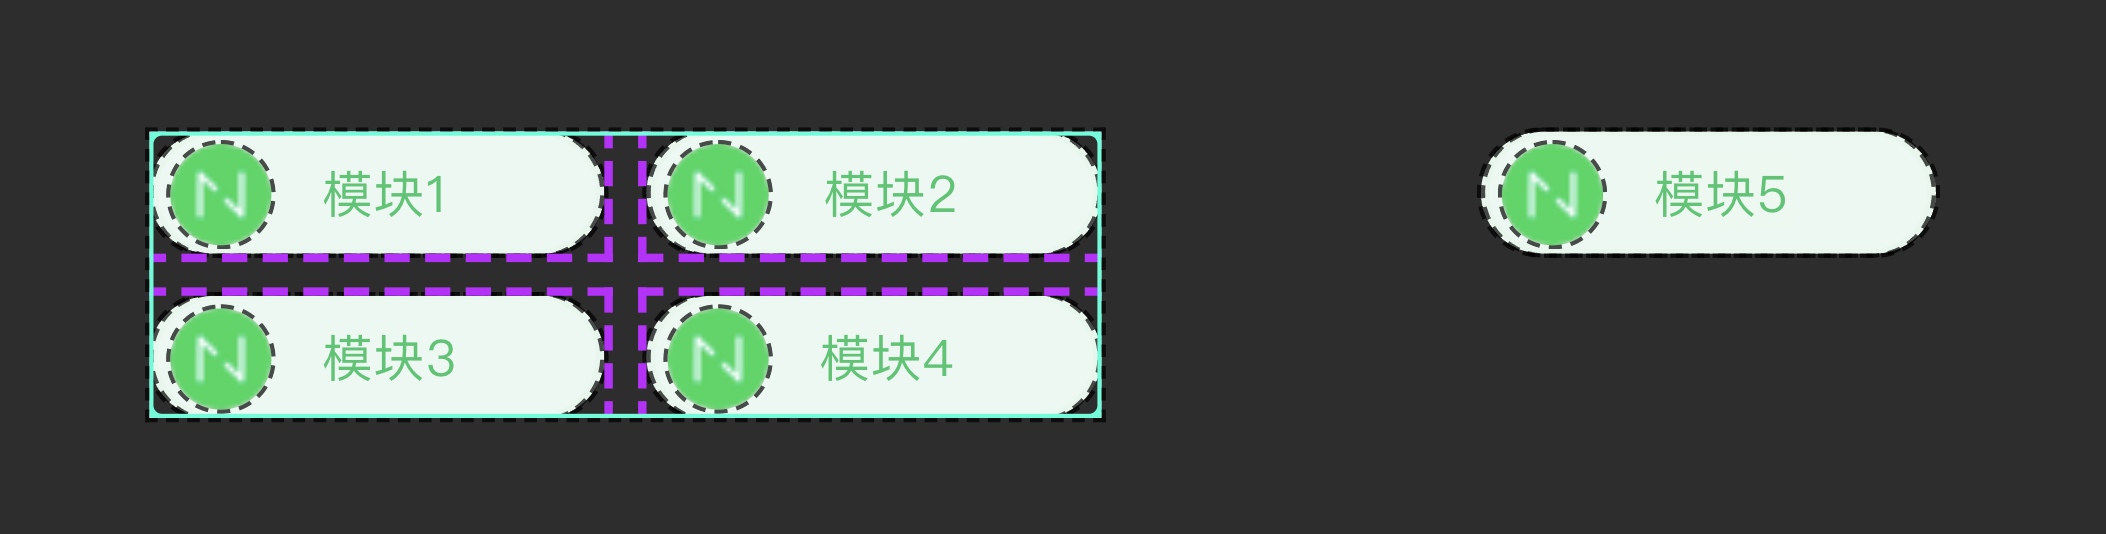
第一步:我们对样本数据集之间的距离先做一个统计,先求出这 5 个区块它们之间的最短距离:
| 模块 1 | 模块 2 | 模块 3 | 模块 4 | 模块 5 | |
|---|---|---|---|---|---|
| 模块 1 | - | 5 | 5 | 7 | 210 |
| 模块 2 | 5 | - | 7 | 5 | 100 |
| 模块 3 | 5 | 7 | - | 5 | 214 |
| 模块 4 | 7 | 5 | 5 | - | 107 |
| 模块 5 | 210 | 100 | 214 | 107 | - |
第二步:然后我们根据距离矩阵表,我们可以得出每个模块与其最相近模块之间的最短距离:
| 模块 | 模块 1 | 模块 2 | 模块 3 | 模块 4 | 模块 5 |
|---|---|---|---|---|---|
| 最短距离 | 5 | 5 | 5 | 5 | 100 |
第三步:在这堆数据中,我们需要提取占比更多,比较有效的数据作为我们的 Eps 值,剔除掉一些干扰项:

我们根据标准差的计算公式,我们取 1 倍标准差作为过滤项,筛选出符合多数样本的数据集,拿[5、5、5、5、100]求它的标准差,我们可以得出,总体标准偏差 38,平均值为 24。
那我们取一倍标准差作为依据,可以得出在一倍标准差的范围内,取数最大值为 24 + 38 = 62,那么我们就可以拿 62 作为我们在这个样本集的邻域半径 Eps。
3.3 算法优化
基于上述的算法改造,其实我们已经完成比较靠谱的在布局上实现模块聚类以及拆分。那么在实际算法的运用上,还会针对邻域半径 Eps 动态生成做一个在布局实际场景的优化:
比如像下面这种布局:水平间距为 5、垂直间距为 10:
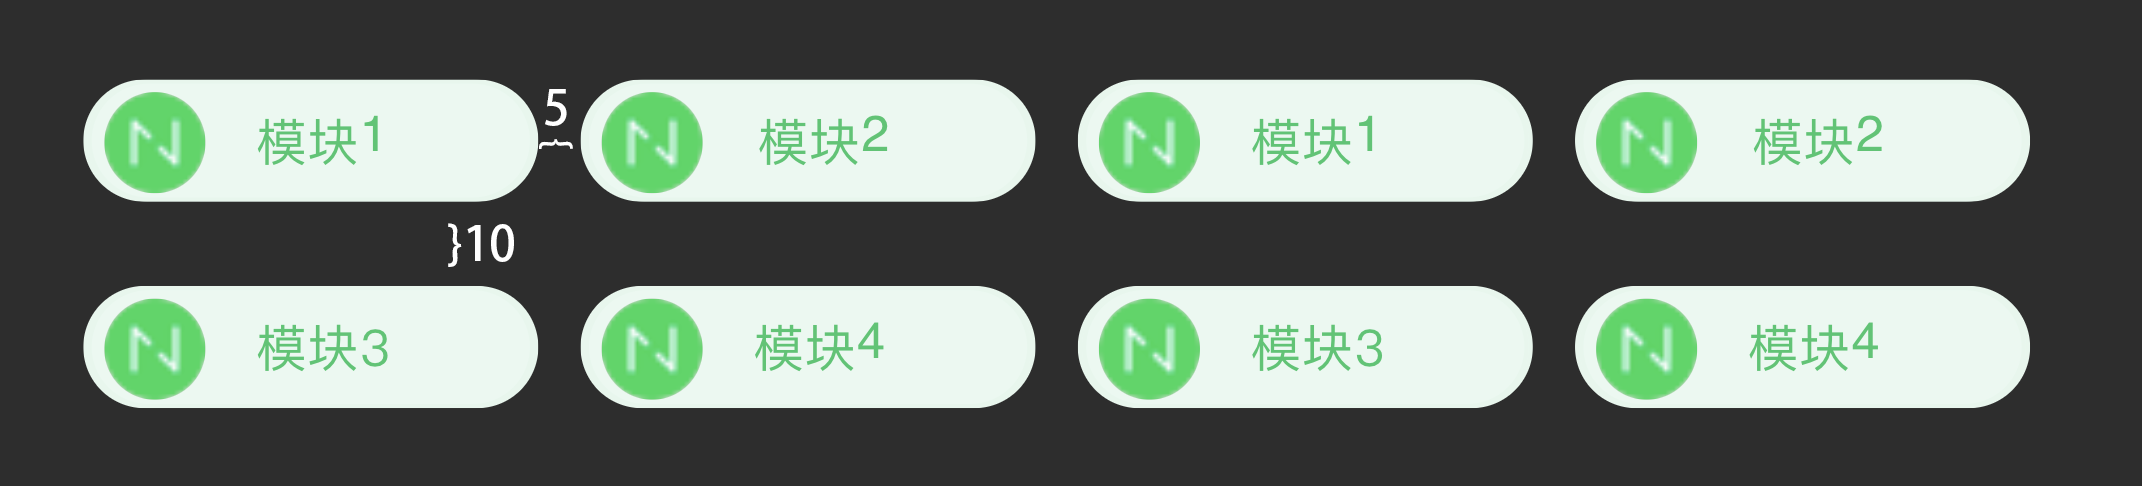
那么如果根据最短距离标准差的形式,那其实 8 个模块它们的最短距离都是 5,最终算出来 Eps 也是 5,那么很有可能就会把上下两行分割开了。
所以我们在实际运用上,在生成标准差样本过程中,根据一定的规则,把水平距离的“10”也考虑进去,并作为标准差的样本进行计算。
4.技术落地
以上技术已经落地在 Deco 智能代码生成项目上,Deco 是我们团队在「前端智能化」方向上的探索,其聚焦设计稿一键生成多端代码这一切入点,实现将 Sketch/Photoshop 等设计稿进行解析并直接生成多端代码(Taro/React/Vue)的能力。Deco 可以使前端工程师不需要花大量精力关注设计稿,大大节约了开发成本,为输出更多的多端页面提供了有力的支持,也为业务降本增效带来了巨大动力。
在过去的一年里,Deco 已在京东的两次大促中成功落地,在个性化活动会场的搭建中,研发效率提升达到了 48%。
感兴趣的同学可以移步 Deco 官网 进行体验。另外也给大家附上Deco体验的保姆级教程。
5.总结
本篇文章主要介绍了 DBSCAN 的实现原理,在介绍中并有给出具体的代码实现,这块大家感兴趣的话网上也有很多具体的代码实现逻辑。目的主要是给大家讲聚类算法的实现思路,以及在聚类算法在 D2C 上布局上的的应用落地。除了 DBSCAN 这种基于密度聚类算法外,其实还有很多算法也可在 D2C 布局算法上等待我们的挖掘。
引用文献:
- [1] [DBSCAN 密度聚类算法] (https://www.cnblogs.com/pinard/p/6208966.html)
- [2] [DBSCAN 聚类算法——机器学习(理论+图解+python 代码)] (https://blog.csdn.net/huacha__/article/details/81094891)
- [3] [DBSCAN 详解] (https://blog.csdn.net/hansome_hong/article/details/107596543)
欢迎关注凹凸实验室博客:aotu.io
或者关注凹凸实验室公众号(AOTULabs),不定时推送文章:
聚类算法在 D2C 布局中的应用的更多相关文章
- k-means和iosdata聚类算法在生活案例中的运用
引言:聚类是将数据分成类或者簇的过程,从而使同簇的对象之间具有很高的相似度,而不同的簇的对象相似度则存在差异.聚类技术是一种迭代重定位技术,在我们的生活中也得到了广泛的运用,比如:零件分组.数据评价. ...
- 聚类算法:K均值、凝聚层次聚类和DBSCAN
聚类分析就仅根据在数据中发现的描述对象及其关系的信息,将数据对象分组(簇).其目标是,组内的对象相互之间是相似的,而不同组中的对象是不同的.组内相似性越大,组间差别越大,聚类就越好. 先介绍下聚类的不 ...
- 常见聚类算法——K均值、凝聚层次聚类和DBSCAN比较
聚类分析就仅根据在数据中发现的描述对象及其关系的信息,将数据对象分组(簇).其目标是,组内的对象相互之间是相似的,而不同组中的对象是不同的.组内相似性越大,组间差别越大,聚类就越好. 先介绍下聚类的不 ...
- 聚类(三)FUZZY C-MEANS 模糊c-均值聚类算法——本质和逻辑回归类似啊
摘自:http://ramsey16.net/%E8%81%9A%E7%B1%BB%EF%BC%88%E4%B8%89%EF%BC%89fuzzy-c-means/ 经典k-均值聚类算法的每一步迭代中 ...
- Matlab中K-means聚类算法的使用(K-均值聚类)
K-means聚类算法采用的是将N*P的矩阵X划分为K个类,使得类内对象之间的距离最大,而类之间的距离最小. 使用方法:Idx=Kmeans(X,K)[Idx,C]=Kmeans(X,K) [Idx, ...
- SPARK在linux中的部署,以及SPARK中聚类算法的使用
眼下,SPARK在大数据处理领域十分流行.尤其是对于大规模数据集上的机器学习算法.SPARK更具有优势.一下初步介绍SPARK在linux中的部署与使用,以及当中聚类算法的实现. 在官网http:// ...
- MATLAB中“fitgmdist”的用法及其GMM聚类算法
MATLAB中“fitgmdist”的用法及其GMM聚类算法 作者:凯鲁嘎吉 - 博客园http://www.cnblogs.com/kailugaji/ 高斯混合模型的基本原理:聚类——GMM,MA ...
- 机器学习中K-means聚类算法原理及C语言实现
本人以前主要focus在传统音频的软件开发,接触到的算法主要是音频信号处理相关的,如各种编解码算法和回声消除算法等.最近切到语音识别上,接触到的算法就变成了各种机器学习算法,如GMM等.K-means ...
- 机器学习:weka中添加自己的分类和聚类算法
不管是实验室研究机器学习算法或是公司研发,都有需要自己改进算法的时候,下面就说说怎么在weka里增加改进的机器学习算法. 一 添加分类算法的流程 1 编写的分类器必须继承 Classifier或是Cl ...
随机推荐
- Django_静态资源配置和ajax(九)
一.静态资源配置 静态资源的相关配置都在项目目录下的 settings.py 文件中进行配置.配置参数如下: # 浏览器访问静态资源时的路径 STATIC_URL = '/static2/' # 存放 ...
- Hive与MapReduce相关排序及自定义UDF函数
原文链接: https://www.toutiao.com/i6770870821809291788/ Hive和mapreduce相关的排序和运行的参数 1.设置每个reduce处理的数据量(单位是 ...
- Keepalived高可用、四层负载均衡
目录 Keepalived高可用 高可用简介 常用的工具 问题 名称解释 VRRP协议 部署keepalived 下载安装 Keepalived配置 保证nginx配置一样 解决keepalived的 ...
- 硬核 - Java 随机数相关 API 的演进与思考(下)
本系列将 Java 17 之前的随机数 API 以及 Java 17 之后的统一 API 都做了比较详细的说明,并且将随机数的特性以及实现思路也做了一些简单的分析,帮助大家明白为何会有这么多的随机数算 ...
- 使用NSSM把任意exe程序注册成Windows服务
1.登录NSSM官网下载最新版本: http://www.nssm.cc/download 2.解压之后可以看到win32和win64位的nssm.exe,根据自己的电脑选择使用 3.拷贝一份nssm ...
- Matlab R2019b安装中的问题
1.licens文件以及dll文件的放置 MATLAB的安装镜像文件放置在D:\MATLAB,我们MATLAB安装在D:\MATLAB2019B,在激活过程中,我们需要破解文件夹中的license_s ...
- HDC2021技术分论坛:组件通信、硬件池化,这些创新技术你get了吗?
作者:ligang 华为分布式硬件技术专家,sunbinxin 华为应用框架技术专家 HarmonyOS是一款全新的分布式操作系统,为开发者提供了元能力框架.事件通知.分布式硬件等分布式技术,使能开发 ...
- DASCTF-Sept-X-浙江工业大学秋季挑战赛-pwn-wp
目录 DASCTF-Sept-X-浙江工业大学秋季挑战赛-pwn-wp 总结 datasystem check分析 漏洞点 利用思路 exp hehepwn 漏洞点 exp hahapwn 漏洞点 e ...
- ASP.NET 内联代码、内联表达式、数据绑定表达式使用方法罗列(形式就是常说的尖括号 百分号 等于号 井号)
今天在做渭南电脑维修网的一个小功能时遇到了一些问题,因此特别列出,以备他日之用. 首先对ASP.NET 内联代码.内联表达式.数据绑定表达式的概念进行罗列,详细概念以及基本的用法我就不在这里罗嗦了,请 ...
- undo和redo的区别
undo和redo的区别: undo一般用于事务的取消与回滚,记录的是数据修改前的值: redo一般用于恢复已确认但未写入数据库的数据,记录的是数据修改后的值.