
爬虫—Selenium爬取JD商品信息
一,抓取分析
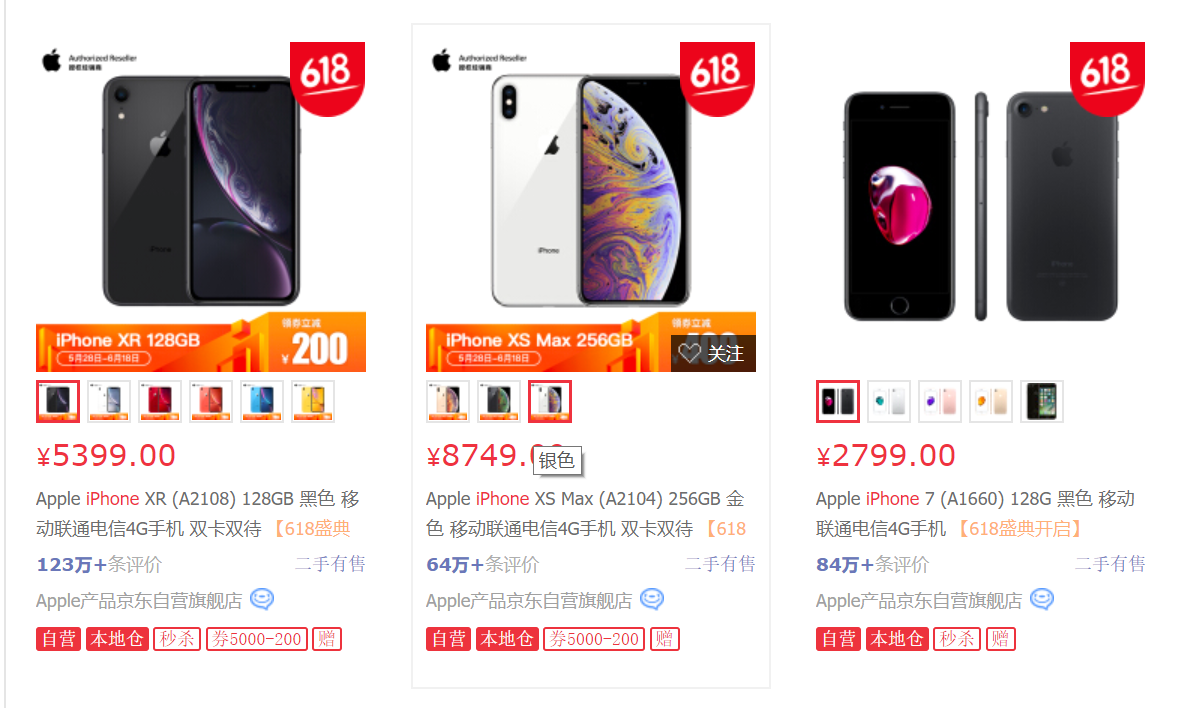
本次目标是爬取京东商品信息,包括商品的图片,名称,价格,评价人数,店铺名称。抓取入口就是京东的搜索页面,这个链接可以通过直接构造参数访问https://search.jd.com/Search?keyword=iPhone,显示的就是第一页的搜索结果。
页面下方有一个分页导航,包括前7页的链接,下一页的链接和跳转任意页面的链接。
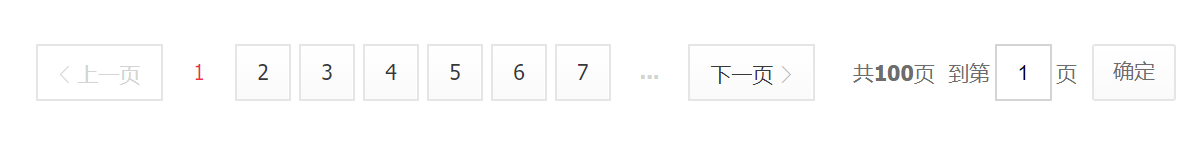
这里的商品显示结果一般都是100页,要获取每一页的内容只需要将页码从1到100遍历即可。所以,我们直接在页面输入框中输入要跳转的页面,点击确定按钮就跳转到对应的页面。
我们在这里不使用直接点击“下一页”,一旦爬取过程中出现异常退出,就无法切换到后续页面了。并且,在爬取过程中也需要记住当前的页码数。当我们利用Selenium加载某一页的商品后,在用相应的解析库解析即可。
二,获取商品列表
我们首先需要构造一个抓取的URL:https://search.jd.com/Search?keyword=iPhone,参数keyword就是要搜索的关键字。只要改变这个参数,就能获取不同商品的列表,这里我们可以将它定义为一个变量。
# _*_ coding=utf-8 _*_

import pymongo

from selenium import webdriver

from selenium.common.exceptions import TimeoutException

from selenium.webdriver.common.by import By

from selenium.webdriver.support import expected_conditions as EC

from selenium.webdriver.support.wait import WebDriverWait

from urllib.parse import quote

# 配置Selenium

browser = webdriver.Chrome(executable_path=r'D:\Google\Chrome\Application\chromedriver')

wait = WebDriverWait(browser, 10)

keyword = 'iPhone'

# 配置MongoDB

MONGO_URL = 'localhost'

MONGO_DB = 'JD'

MONGO_COLLECTION = 'goods'

client = pymongo.MongoClient(MONGO_URL)

db = client[MONGO_DB]

def get_page(page):

    """

    获取页面

    :param page: 页码

    :return:

    """

    print('正在爬取第', page, '页')

    try:

        url = 'https://search.jd.com/Search?keyword=' + quote(keyword)

        browser.get(url)

        if page >= 1:

            # 页码搜索框加载成功

            search_page = wait.until(

                EC.presence_of_element_located(

                    (By.XPATH, '//div[@id="J_searchWrap"]//div[@id="J_bottomPage"]//span[2]/input'))

            )

            # 页码确认按钮加载成功

            submit = wait.until(

                EC.element_to_be_clickable((By.XPATH, '//div[@id="J_searchWrap"]//div[@id="J_bottomPage"]//span[2]/a')))

            print('button')

            search_page.clear()

            search_page.send_keys(page)

            submit.click()

        # 当前页码显示标识加载成功,对比我们传入的page,结果一致就返回True,证明是跳转到了传入的page页面

        wait.until(

            EC.text_to_be_present_in_element(

                (By.XPATH, '//div[@id="J_searchWrap"]//div[@id="J_bottomPage"]/span//a[@class="curr"]'), str(page))

        )

        # 商品列表加载成功

        wait.until(

            EC.presence_of_element_located((By.XPATH, '//div[@id="J_searchWrap"]//div[@id="J_goodsList"]/ul//li'))

        )

        print('Goods show successfully')

        get_goods()

    except TimeoutException:

        get_page(page)

def get_goods():

    """

    获取商品数据

    :return:

    """

    items = browser.find_elements_by_xpath('//div[@id="J_searchWrap"]//div[@id="J_goodsList"]/ul//li')

    for item in items:

        goods = {

            'img': item.find_element_by_xpath('//div[@class="p-img"]/a/img').get_attribute('src'),

            'price': item.find_element_by_xpath('//div[@class="p-price"]/strong').text,

            'commit': item.find_element_by_xpath('//div[@class="p-commit"]/strong').text,

            'title': item.find_element_by_xpath('//div[@class="p-name p-name-type-2"]/a').text,

            'shop': item.find_element_by_xpath('//div[@class="p-shop"]/span/a').text,

        }

        print(goods)

        save_to_mongo(goods)

def save_to_mongo(result):

    """

    保存到MongoDB

    :param result: 抓取到的结果:单个商品信息

    :return:

    """

    try:

        if db[MONGO_COLLECTION].insert(result):

            print('储存到MongoDB成功!')

    except Exception:

        print('存储到MongoDB失败!')

if __name__ == '__main__':

    for i in range(1, 10):

        get_page(i)
爬虫—Selenium爬取JD商品信息的更多相关文章
- selenium模块使用详解、打码平台使用、xpath使用、使用selenium爬取京东商品信息、scrapy框架介绍与安装
今日内容概要 selenium的使用 打码平台使用 xpath使用 爬取京东商品信息 scrapy 介绍和安装 内容详细 1.selenium模块的使用 # 之前咱们学requests,可以发送htt ...
- 利用selenium爬取京东商品信息存放到mongodb
利用selenium爬取京东商城的商品信息思路: 1.首先进入京东的搜索页面,分析搜索页面信息可以得到路由结构 2.根据页面信息可以看到京东在搜索页面使用了懒加载,所以为了解决这个问题,使用递归.等待 ...
- python爬虫——用selenium爬取京东商品信息
1.先附上效果图(我偷懒只爬了4页) 2.京东的网址https://www.jd.com/ 3.我这里是不加载图片,加快爬取速度,也可以用Headless无弹窗模式 options = webdri ...
- 爬虫之selenium爬取京东商品信息
import json import time from selenium import webdriver """ 发送请求 1.1生成driver对象 2.1窗口最大 ...
- 爬虫系列(十三) 用selenium爬取京东商品
这篇文章,我们将通过 selenium 模拟用户使用浏览器的行为,爬取京东商品信息,还是先放上最终的效果图: 1.网页分析 (1)初步分析 原本博主打算写一个能够爬取所有商品信息的爬虫,可是在分析过程 ...
- selenium+phantomjs爬取京东商品信息
selenium+phantomjs爬取京东商品信息 今天自己实战写了个爬取京东商品信息,和上一篇的思路一样,附上链接:https://www.cnblogs.com/cany/p/10897618. ...
- [Python爬虫] Selenium爬取新浪微博客户端用户信息、热点话题及评论 (上)
转载自:http://blog.csdn.net/eastmount/article/details/51231852 一. 文章介绍 源码下载地址:http://download.csdn.net/ ...
- Python爬虫-爬取京东商品信息-按给定关键词
目的:按给定关键词爬取京东商品信息,并保存至mongodb. 字段:title.url.store.store_url.item_id.price.comments_count.comments 工具 ...
- Scrapy实战篇(七)之Scrapy配合Selenium爬取京东商城信息(下)
之前我们使用了selenium加Firefox作为下载中间件来实现爬取京东的商品信息.但是在大规模的爬取的时候,Firefox消耗资源比较多,因此我们希望换一种资源消耗更小的方法来爬取相关的信息. 下 ...
随机推荐
- Ultra-QuickSort--POJ2299(归并排序求逆序数对)
http://poj.org/problem?id=2299 归并排序:比如现在有一个序列[l,r),我们可以把这个序列分成两个序列[l,mid),[mid,r),利用递归按照上 述方法逐步缩小序列, ...
- html5 拖拽元素
利用html5实现元素的拖拽,让拖动元素在指定的容器中拖动. 注意点:1.被拖元素要设置拖动属性.draggable="true" 2.容器元素要设置阻止默认事件处理 实现效果图如 ...
- Meteor Assets资源
静态服务器资源位于应用程序内的 private 子文件夹.在这个例子中,我们将学习如何从简单的JSON文件中使用数据. 第1步 - 创建文件和文件夹 让我们创建一个 private 文件夹并在这个文件 ...
- Java和C++里面的重写/隐藏/覆盖
首先,无关重载. 注:重载是同一个类的各个函数之间的.重写是父类子类之间的.Overload和Overwrite(也叫Override)的区别. 注意:Java里面区分重写(Override/Over ...
- 【APUE】fork函数
#include <unisth.h> pid_t fork(void) fork函数被调用一次,返回两次.子进程的返回值是0,父进程的返回值是子进程的进程id. fork函数调用一次却返 ...
- 【Mongodb教程 第六课 】MongoDB 插入文档
insert() 方法 要插入数据到 MongoDB 集合,需要使用 MongoDB 的 insert() 或 save() 方法. 语法 insert() 命令的基本语法如下: >db.CO ...
- HLJU 1220: AC100天 (枚举)
1220: AC100天 Time Limit: 1 Sec Memory Limit: 128 MB Submit: 89 Solved: 12 [id=1220">Submit ...
- Maven实战(七,八)——经常使用Maven插件介绍
我们都知道Maven本质上是一个插件框架,它的核心并不运行不论什么详细的构建任务,全部这些任务都交给插件来完毕,比如编译源代码是由maven-compiler-plugin完毕的.进一步说,每一个任务 ...
- android通过adb wireless的使用
转自:http://www.cnblogs.com/Androider123/p/3848415.html?utm_source=tuicool 开发android程序,总是需要插拔插拔的,usb口都 ...
- [IT学习]学习Python过程需要记忆的一些坑
1.列表的引用和复制 A byte of Python 中文4.05c版本85页 单纯对列表进行引用,则列表指向同一对象. 如果你需要复制一份全新的拷贝,则需要通过切片操作. 2.仅有一个元素的元组, ...