
Python爬虫学习笔记(一)
概念:
使用代码模拟用户,批量发送网络请求,批量获取数据。
分类:
通用爬虫:
通用爬虫是搜索引擎(Baidu、Google、Yahoo等)“抓取系统”的重要组成部分。
主要目的是将互联网上的网页下载到本地,形成一个互联网内容的镜像备份。
简单来讲就是尽可能的把互联网上的所有的网页下载下来,放到本地服务器里形成备分,
在对这些网页做相关处理(提取关键字、去掉广告),最后提供一个用户检索接口。
聚焦爬虫:
聚焦爬虫是根据指定的需求抓取网络上指定的数据。
例如:获取豆瓣上电影的名称和影评,而不是获取整张页面中所有的数据值。
增量式爬虫:
增量式是用来检测网站数据更新的情况,且可以将网站更新的数据进行爬取。
Robots协议:
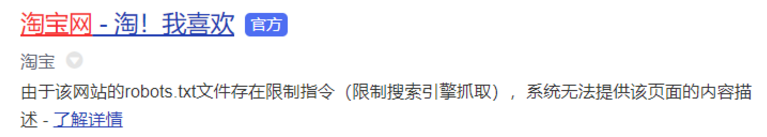
robots协议也叫robots.txt(统一小写)是一种存放于网站根目录下的ASCII编码的文本文件,它通常告诉网络搜索引擎的漫游器(又称网络蜘蛛),此网站中的哪些内容是不应被搜索引擎的漫游器获取的,哪些是可以被漫游器获取的。

因为一些系统中的URL是大小写敏感的,所以robots.txt的文件名应统一为小写。robots.txt应放置于网站的根目录下。

如果想单独定义搜索引擎的漫游器访问子目录时的行为,那么可以将自定的设置合并到根目录下的robots.txt,或者使用robots元数据(Metadata,又称元数据)。

robots协议并不是一个规范,而只是约定俗成的,所以并不能保证网站的隐私。
简单来说,robots决定是否允许爬虫(通用爬虫)抓取某些内容。
注:聚焦爬虫不遵守robots。
eg:
爬取流程:
大多数情况下的需求,我们都会指定去使用聚焦爬虫,也就是爬取页面中指定部分的数据值,而不是整个页面的数据。
- 指定url
- 发起请求
- 获取响应数据
- 数据解析
- 持久化存储
Test:
Test1:


import urllib.request

def load_data():

    url = "http://www.baidu.com/"

    #GET请求

    #http请求

    #response:http响应对象

    response = urllib.request.urlopen(url)

    print(response)

load_data()
urllib
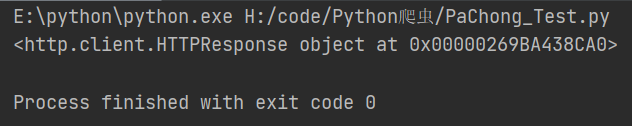
Test2:
import urllib.request

def load_data():

    url = "http://www.baidu.com/"

    #GET请求

    #http请求

    #response:http响应对象

    response = urllib.request.urlopen(url)

    print(response)

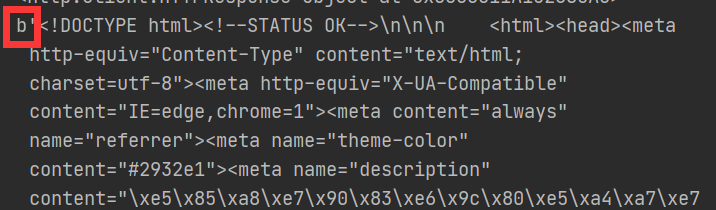
    #读取内容 byte类型

    data = response.read()

    print(data)

load_data()
读取内容
Test3:
import urllib.request

def load_data():

    url = "http://www.baidu.com/"

    #GET请求

    #http请求

    #response:http响应对象

    response = urllib.request.urlopen(url)

    #print(response)

    #读取内容 byte类型

    data = response.read()

    #print(data)

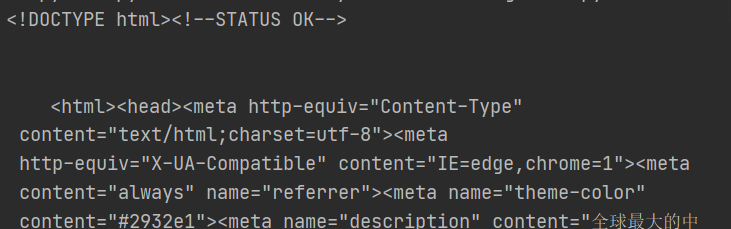
    #将文件获取的内容转换为字符串

    str_data = data.decode("UTF-8")

    print(str_data)

load_data()
字符串方式读取内容
Test4:
import urllib.request

def load_data():

    url = "http://www.baidu.com/"

    #GET请求

    #http请求

    #response:http响应对象

    response = urllib.request.urlopen(url)

    #print(response)

    #读取内容 byte类型

    data = response.read()

    #print(data)

    #将文件获取的内容转换为字符串

    str_data = data.decode("UTF-8")

    #print(str_data)

    #将数据写入文件

    with open("baidu.html", "w", encoding="utf-8") as f:

        f.write(str_data)

load_data()
将数据写入文件
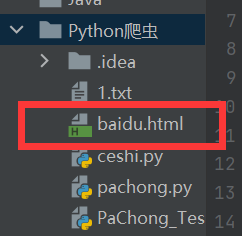
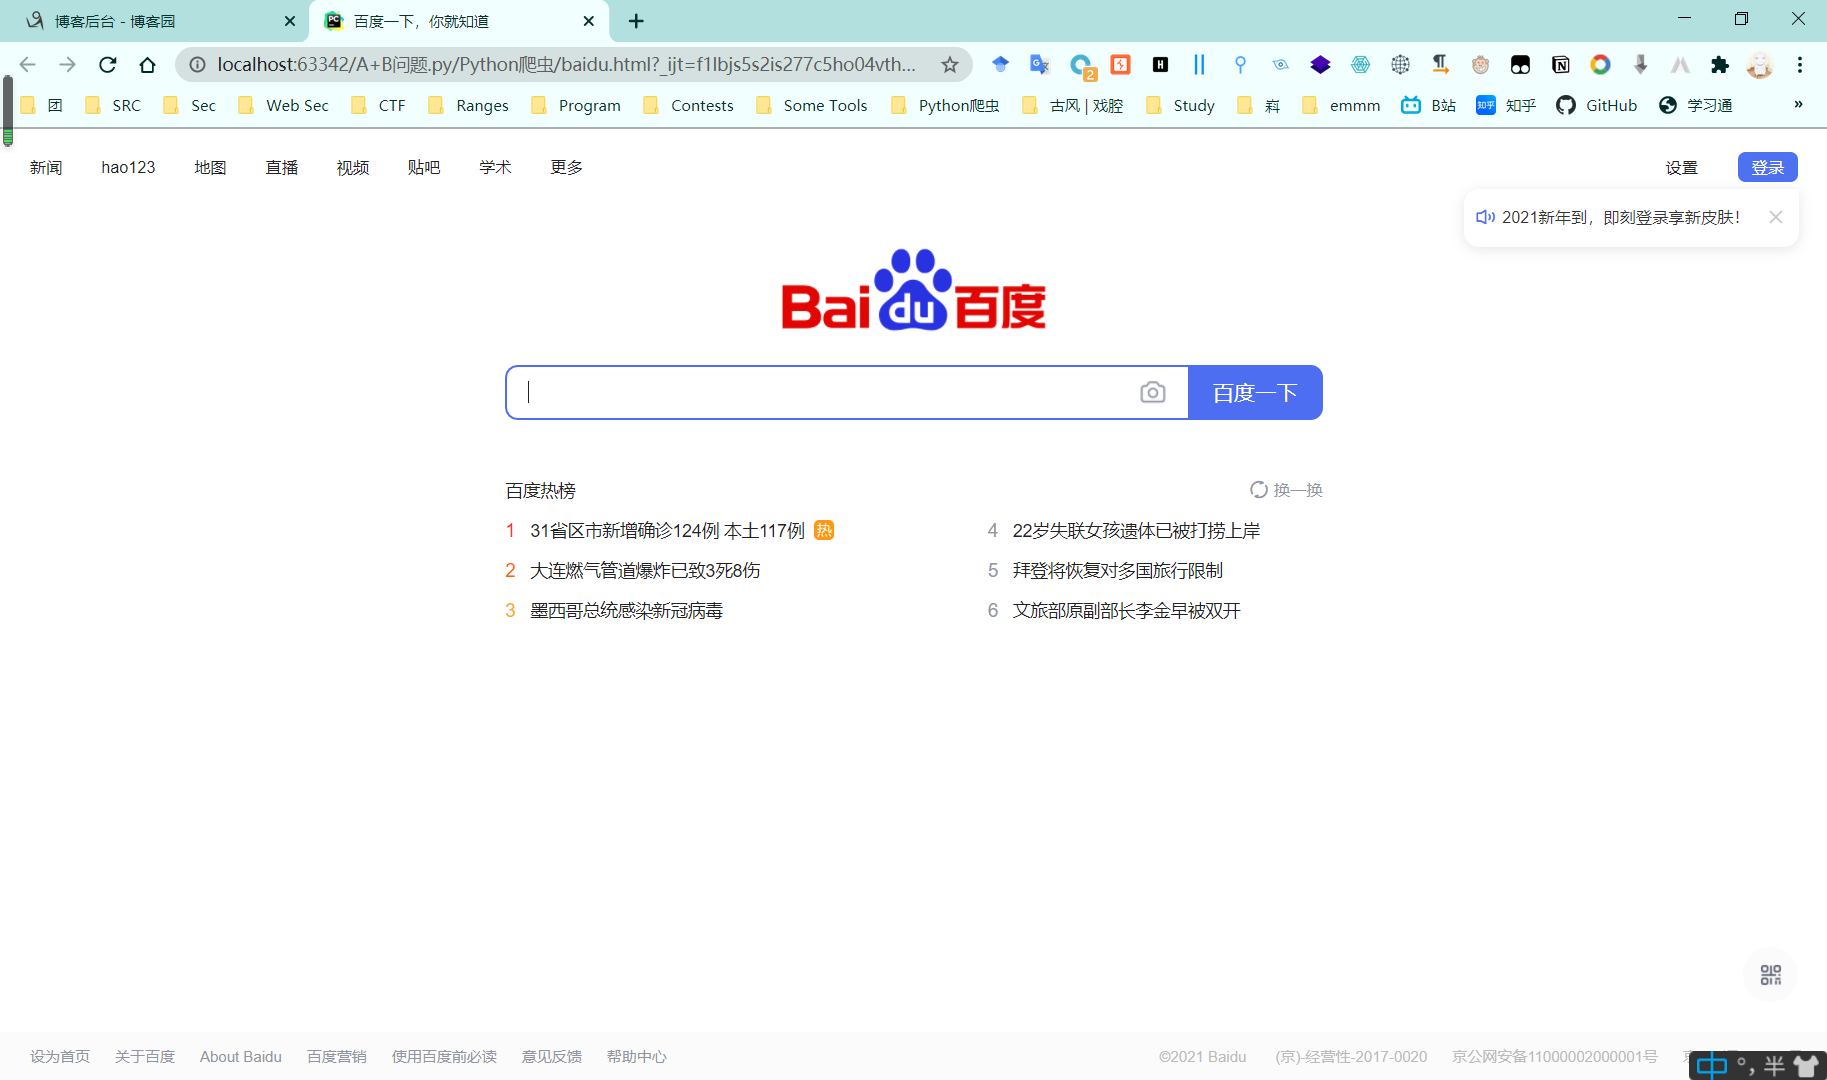
注:
出于安全性,https请求的话将无法打开,而http则可以打开。
Test5:
str_name = "baidu"

    bytes_name = str_name.encode("utf-8")

    print(str_name)
将字符串类型传唤为bytes
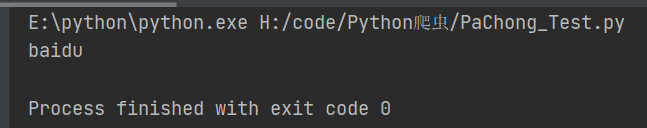
注:
python爬取的类型:str,bytes
如果爬取返回的是bytes类型:但写入的时候需要字符串 => decode(“utf-8”);
如果爬取返回的是str类型:但写入的时候需要bytes类型 => encode(“utf-8”).
Test1 ~ Test4代码:
import urllib.request

def load_data():

    url = "http://www.baidu.com/"

    #GET请求

    #http请求

    #response:http响应对象

    response = urllib.request.urlopen(url)

    #print(response)

    #读取内容 byte类型

    data = response.read()

    #print(data)

    #将文件获取的内容转换为字符串

    str_data = data.decode("UTF-8")

    #print(str_data)

    #将数据写入文件

    with open("baidu.html", "w", encoding="utf-8") as f:

        f.write(str_data)

    #将字符串类型传唤为bytes

    str_name = "baidu"

    bytes_name = str_name.encode("utf-8")

    print(str_name)

load_data()
Test5:
import urllib.request

import urllib.parse

import string

def get_method_params():

    url = "http://www.baidu.com/?wd="

    #拼接字符串(汉字)

    name = "爬虫"

    final_url = url + name

    #print(final_url)

    #代码发送了请求

    #网址里面包含了汉字;ascii是没有汉字的;URL转义

    #使用代码发送网络请求

    #将包含汉字的网址进行转义

    encode_new_url = urllib.parse.quote(final_url, safe=string.printable)

    #response = urllib.request.urlopen(final_url)

    print(encode_new_url)

    #UnicodeEncodeError: 'ascii' codec can't encode characters in position 15-16: ordinal not in range(128)

    #针对报错结合上一条注释的解释:

    #python是解释性语言;解释器只支持 ascii 0 - 127,即不支持中文!!!

get_method_params()
GET - params
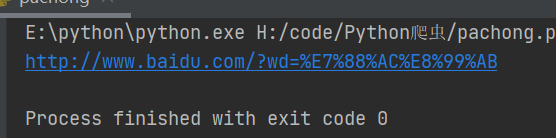
import urllib.request

import urllib.parse

import string

def get_method_params():

    url = "http://www.baidu.com/?wd="

    #拼接字符串(汉字)

    name = "爬虫"

    final_url = url + name

    #print(final_url)

    #代码发送了请求

    #网址里面包含了汉字;ascii是没有汉字的;URL转义

    #将包含汉字的网址进行转义

    encode_new_url = urllib.parse.quote(final_url, safe=string.printable)

    response = urllib.request.urlopen(encode_new_url)

    print(response)

    #UnicodeEncodeError: 'ascii' codec can't encode characters in position 15-16: ordinal not in range(128)

    #针对报错结合上一条注释的解释:

    #python是解释性语言;解释器只支持 ascii 0 - 127,即不支持中文!!!

get_method_params()
直接运行
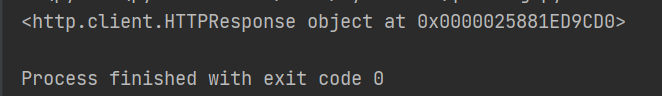
import urllib.request

import urllib.parse

import string

def get_method_params():

    url = "http://www.baidu.com/?wd="

    #拼接字符串(汉字)

    name = "爬虫"

    final_url = url + name

    #print(final_url)

    #代码发送了请求

    #网址里面包含了汉字;ascii是没有汉字的;URL转义

    #将包含汉字的网址进行转义

    encode_new_url = urllib.parse.quote(final_url, safe=string.printable)

    response = urllib.request.urlopen(encode_new_url)

    print(response)

    #读取内容

    data = response.read().decode()

    print(data)

    #UnicodeEncodeError: 'ascii' codec can't encode characters in position 15-16: ordinal not in range(128)

    #针对报错结合上一条注释的解释:

    #python是解释性语言;解释器只支持 ascii 0 - 127,即不支持中文!!!

get_method_params()
读取内容
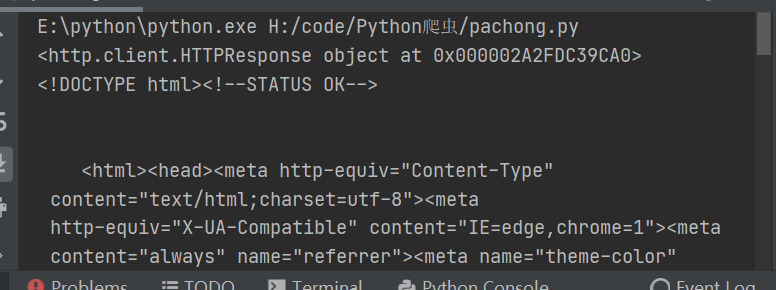
import urllib.request

import urllib.parse

import string

def get_method_params():

    url = "http://www.baidu.com/?wd="

    #拼接字符串(汉字)

    name = "爬虫"

    final_url = url + name

    #print(final_url)

    #代码发送了请求

    #网址里面包含了汉字;ascii是没有汉字的;URL转义

    #将包含汉字的网址进行转义

    encode_new_url = urllib.parse.quote(final_url, safe=string.printable)

    response = urllib.request.urlopen(encode_new_url)

    print(response)

    #读取内容

    data = response.read().decode()

    print(data)

    #保存到本地

    with open("encode_test.html", "w", encoding="utf-8")as f:

        f.write(data)

    #UnicodeEncodeError: 'ascii' codec can't encode characters in position 15-16: ordinal not in range(128)

    #针对报错结合上一条注释的解释:

    #python是解释性语言;解释器只支持 ascii 0 - 127,即不支持中文!!!

get_method_params()
保存到本地
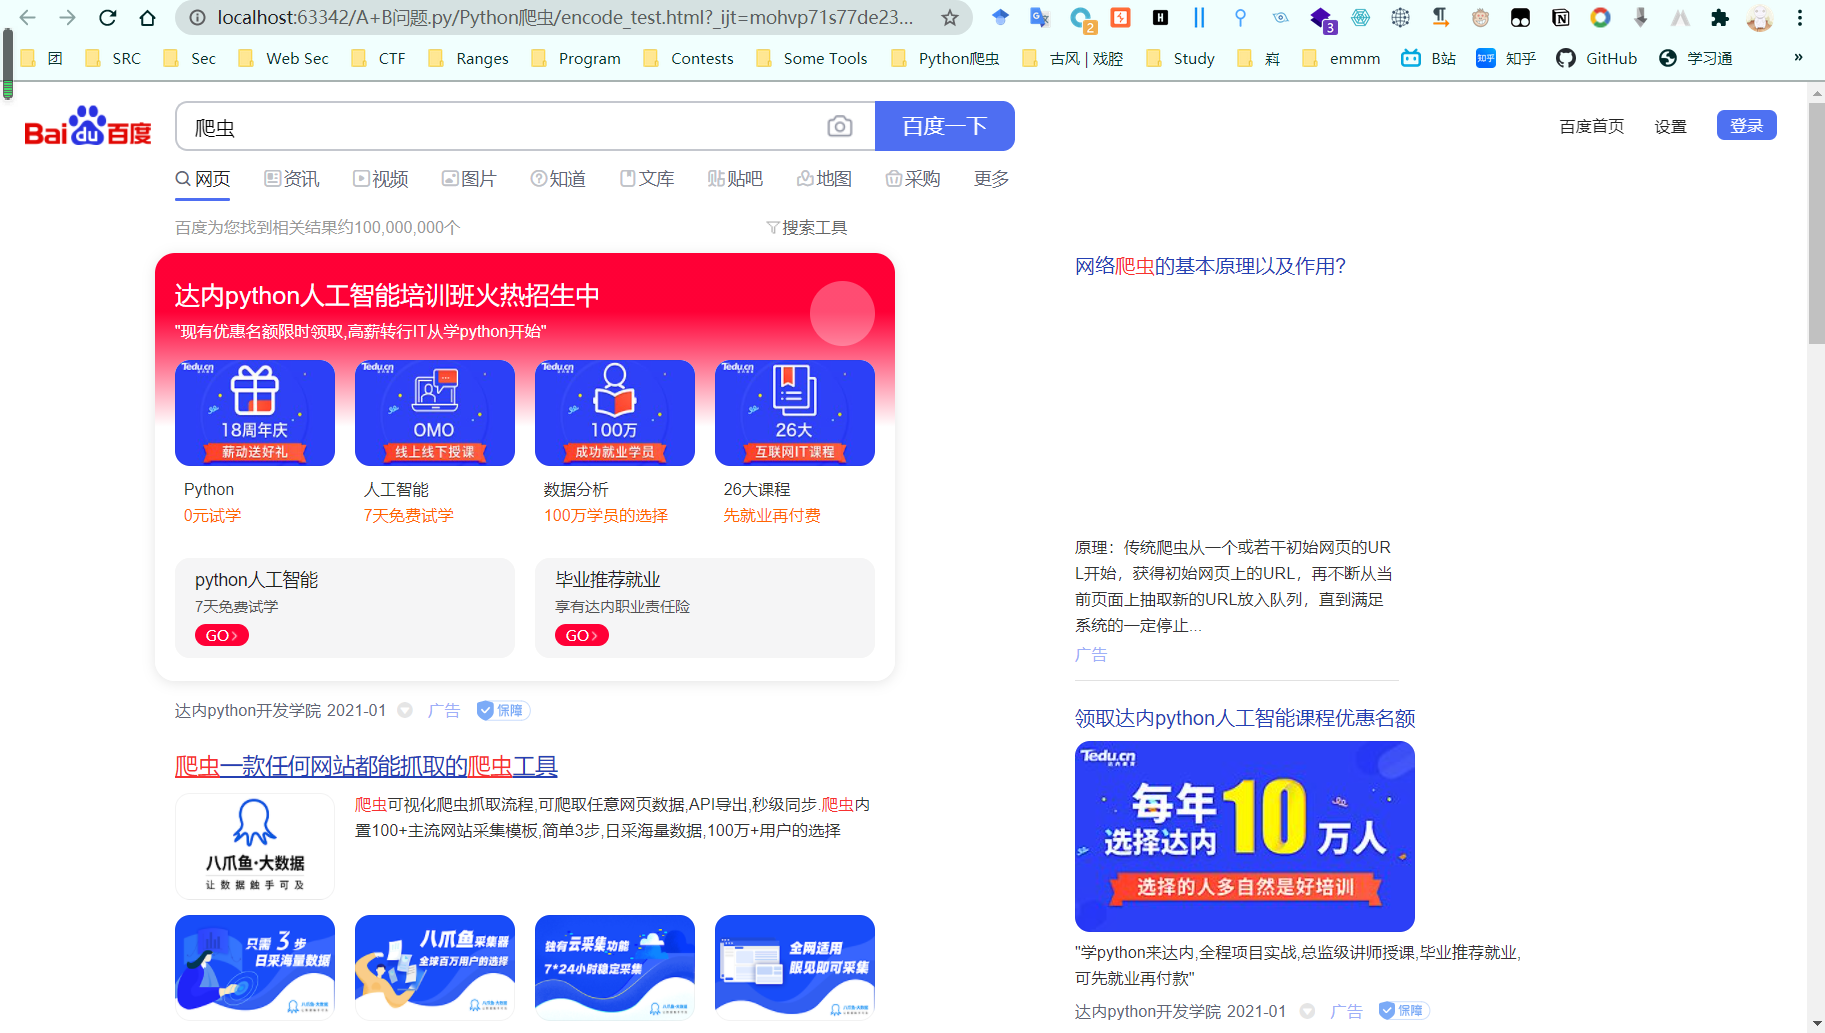
参考:
https://www.bilibili.com/video/BV1XZ4y1u7Kv
Python爬虫学习笔记(一)的更多相关文章
- python爬虫学习笔记(一)——环境配置(windows系统)
在进行python爬虫学习前,需要进行如下准备工作: python3+pip官方配置 1.Anaconda(推荐,包括python和相关库) [推荐地址:清华镜像] https://mirrors ...
- Python爬虫学习笔记(三)
Cookies: 以抓取https://www.yaozh.com/为例 Test1(不使用cookies): 代码: import urllib.request # 1.添加URL url = &q ...
- python爬虫学习笔记
爬虫的分类 1.通用爬虫:通用爬虫是搜索引擎(Baidu.Google.Yahoo等)“抓取系统”的重要组成部分.主要目的是将互联网上的网页下载到本地,形成一个互联网内容的镜像备份. 简单来讲就是尽可 ...
- Python、pip和scrapy的安装——Python爬虫学习笔记1
Python作为爬虫语言非常受欢迎,近期项目需要,很是学习了一番Python,在此记录学习过程:首先因为是初学,而且当时要求很快速的出demo,所以首先想到的是框架,一番查找选用了Python界大名鼎 ...
- 一入爬虫深似海,从此游戏是路人!总结我的python爬虫学习笔记!
前言 还记得是大学2年级的时候,偶然之间看到了学长在学习python:我就坐在旁边看他敲着代码,感觉很好奇.感觉很酷,从那之后,我就想和学长一样的厉害,就想让学长教我,请他吃了一周的饭,他答应了.从此 ...
- Python爬虫学习笔记——豆瓣登陆(一)
#-*- coding:utf-8 -*- import requests from bs4 import BeautifulSoup import html5lib import re import ...
- Python爬虫学习笔记-1.Urllib库
urllib 是python内置的基本库,提供了一系列用于操作URL的功能,我们可以通过它来做一个简单的爬虫. 0X01 基本使用 简单的爬取一个页面: import urllib2 request ...
- 【Python爬虫学习笔记(3)】Beautiful Soup库相关知识点总结
1. Beautiful Soup简介 Beautiful Soup是将数据从HTML和XML文件中解析出来的一个python库,它能够提供一种符合习惯的方法去遍历搜索和修改解析树,这将大大减 ...
- 【Python爬虫学习笔记(1)】urllib2库相关知识点总结
1. urllib2的opener和handler概念 1.1 Openers: 当你获取一个URL你使用一个opener(一个urllib2.OpenerDirector的实例).正常情况下,我们使 ...
随机推荐
- matplotlib的学习3-figure图像
import matplotlib.pyplot as plt import numpy as np # matplotlib 的 figure 就是一个 单独的 figure 小窗口, 小窗口里面还 ...
- JavaScript var,let,const三个关键字的区别
var: 1)声明作用域:在函数内部,使用var定义一个变量(局部变量),在函数被调用完之后,该变量会被立即销毁.在定义变量时如果省略var,就会创建一个全局变量(不建议在局部作用域中定义全局变量,难 ...
- Containerd 的前世今生和保姆级入门教程
原文链接:https://fuckcloudnative.io/posts/getting-started-with-containerd/ 1. Containerd 的前世今生 很久以前,Dock ...
- 写一个简单的HTML留言板
最近有点懒,没码什么字,防止遗忘,从头开始码,写一个简单的HTML留言板.包含两个文件,book.html还有style.css,放在同一目录下. book.html 1 <!DOCTYPE h ...
- CentOS7下常用安装服务软件yum方式的介绍
简介:介绍yum软件包的管理并配置本地yum源 yum安装:基于 C/S 架构,yum安装称之为傻瓜式安装 yum安装优点:方便快捷,不用考虑包依赖,自动下载软件包. yum安装缺点:人为无法干预,无 ...
- 如何重新加载 Spring Boot 上的更改,而无需重新启动服务器?
这可以使用 DEV 工具来实现.通过这种依赖关系,您可以节省任何更改,嵌入式 tomcat将重新启动.Spring Boot 有一个开发工具(DevTools)模块,它有助于提高开发人员的生产力.Ja ...
- python-scrapy框架爬取某瓣电视剧信息--异步加载页面
前期准备,首先要有python环境+scrapy环境+pycharm环境 一.建立爬虫所需的环境,在命令行输入: scrapy startproject doubantv #命名自定义就好 会生成一个 ...
- JVM 分代GC策略分析
JVM 分代GC策略分析 我们以Sun HotSpot VM来进行分析,首先应该知道,如果我们没有指定任何GC策略的时候,JVM默认使用的GC策略.Java虚拟机是按照分代的方式来回收垃圾空间,我 ...
- maven版本仲裁原则
这里有一个案例是项目里依赖了b组件,b组件依赖了a组件1.0.2版本,而用户也直接在pom依赖了a组件并声明的1.0.0版本,结果在仲裁时选择了1.0.0版本的a组件: +- com.xxx:a:ja ...
- IPC 经典问题:Reader & Writer Problem
完整代码实现: #include <stdio.h> #include <unistd.h> #include <time.h> #include <stdl ...