
Hive的安装和使用
1.Hive
1.1 在hadoop生态圈中属于数据仓库的角色。他能够管理hadoop中的数据,同时可以查询hadoop中的数据。
本质上讲,hive是一个SQL解析引擎。Hive可以把SQL查询转换为MapReduce中的job来运行。
hive有一套映射工具,可以把SQL转换为MapReduce中的job,可以把SQL中的表、字段转换为HDFS中的文件(夹)以及文件中的列。
这套映射工具称之为metastore,一般存放在derby、mysql中。
1.2 hive在hdfs中的默认位置是/user/hive/warehouse,是由配置文件hive-site.xml中属性hive.metastore.warehouse.dir决定的(简短点,可以修改为/hive)。
1.3 hive的系统架构

用户接口主要有三个:CLI,JDBC/ODBC和 WebUI
CLI,即Shell命令行
JDBC/ODBC 是 Hive 的Java,与使用传统数据库JDBC的方式类似
WebGUI是通过浏览器访问 Hive
Hive 将元数据存储在数据库中(metastore),目前只支持 mysql、derby。Hive 中的元数据包括表的名字,表的列和分区及其属性,表的属性(是否为外部表等),表的数据所在目录等
解释器、编译器、优化器完成 HQL 查询语句从词法分析、语法分析、编译、优化以及查询计划(plan)的生成。生成的查询计划存储在 HDFS 中,并在随后有 MapReduce 调用执行
Hive 的数据存储在 HDFS 中,大部分的查询由 MapReduce 完成(包含 * 的查询,比如 select * from table 不会生成 MapRedcue 任务)
2.hive的安装(在hadoop0上)
(1)解压缩、重命名、设置环境变量vi /etc/profile
export HIVE_HOME=/usr/local/hive
export PATH=....:$HIVE_HOME/bin...
设置好,执行source /etc/profile
(2)在目录$HIVE_HOME/conf/下,执行命令mv hive-default.xml.template hive-site.xml重命名
在目录$HIVE_HOME/conf/下,执行命令mv hive-env.sh.template hive-env.sh重命名
(3)修改hadoop的配置文件hadoop-env.sh,修改内容如下:
打开修改 export HADOOP_CLASSPATH=.:$CLASSPATH:$HADOOP_CLASSPATH:$HADOOP_HOME/bin
(4)在目录$HIVE_HOME/bin下面,修改文件hive-config.sh,增加以下内容:
export JAVA_HOME=/usr/local/jdk
export HIVE_HOME=/usr/local/hive
export HADOOP_HOME=/usr/local/hadoop
在hadoop0上执行hive命令,就进入到了hive命令行模式下,在这个模式下一些数据库操作跟MySQL的命令行下(cmd-->mysql -uroot -proot)的操作一样!
如: show databases;
use default;
show tables;
create table t1(id string);
show tables;
select * from t1;

通过在浏览器中输入hadoop0:50070,可以查看到hive在HDFS中的相关信息。

3.安装mysql
(1)删除linux上已经安装的mysql相关库信息。rpm -e mysql-libs-xxx --nodeps
执行命令rpm -qa |grep mysql 检查是否删除干净
(2)执行命令 rpm -i mysql-server-******** 安装mysql服务端
(3)启动mysql 服务端,执行命令 mysqld_safe &
(4)执行命令 rpm -i mysql-client-******** 安装mysql客户端
(5)执行命令mysql_secure_installation设置root用户密码( Y admin n n n Y ) 登录:mysql -uroot -padmin
4. 使用mysql作为hive的metastore
metastore是hive元数据的集中存放地。metastore默认使用内嵌的derby数据库作为存储引擎 Derby引擎的缺点:一次只能打开一个会话 使用Mysql作为外置存储引擎,多用户同时访问
(1)把mysql的jdbc驱动放置到hive的lib目录下cp mysql-connector-java-5.1.10.jar /usr/local/hive/lib/
(2)修改hive-site.xml文件,修改内容如下:
<property>
<name>javax.jdo.option.ConnectionURL</name>
<value>jdbc:mysql://hadoop0:3306/hive?createDatabaseIfNotExist=true</value>
</property>
<property>
<name>javax.jdo.option.ConnectionDriverName</name>
<value>com.mysql.jdbc.Driver</value>
</property>
<property>
<name>javax.jdo.option.ConnectionUserName</name>
<value>root</value>
</property>
<property>
<name>javax.jdo.option.ConnectionPassword</name>
<value>admin</value>
</property>
要想用工具远程连接MySQL数据库,先要在MySQL命令行下授权:grant all on hive.* to 'root'@'%' identified by 'admin';
刷新:flush privileges ;

5. 内部表
CREATE TABLE t1(id int);
LOAD DATA LOCAL INPATH '/root/id' INTO TABLE t1; -----先新建一个id文件,cd /root/
vi id 输入一些数据
1
2
3
4
5
注意:如果上面不加LOCAL,就会从HDFS中取找对应文件加载!
select * from t1;----可以查看到插入的数据,也可在浏览器中查看hadoop0:50070

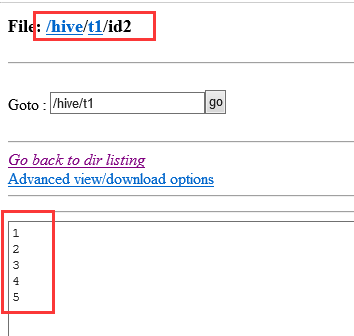
注意:加载数据,用LOAD DATA..可以,也可以直接使用hadoop fs -put /root/id /hive/t1/id2,这样加载数据的效果跟LOAD DATA一样!

CREATE TABLE t2(id int, name string) ROW FORMAT DELIMITED FIELDS TERMINATED BY '\t'; -----列与列之间通过制表符来区分
cp id stu
vi stu 输入数据
1 zhangsan
2 lisi
3 wangwu
4 zhaoliu
5 qian
上传数据到表里面:hadoop fs -put stu /hive/t2


6. 分区表
CREATE TABLE t3(id int) PARTITIONED BY (day int);
LOAD DATA LOCAL INPATH '/root/id' INTO TABLE t3 PARTITION (day=22);
LOAD DATA LOCAL INPATH '/root/id' INTO TABLE t3 PARTITION (day=23);
LOAD DATA LOCAL INPATH '/root/id' INTO TABLE t3 PARTITION (day=24);
在浏览器中查看,在/hive/t3/目录下,会有三个分区day=22,day=23,day=24

根据分区名来查询:select * from t3 where day=22;

7. 桶表
create table t4(id int) clustered by(id) into 4 buckets;
set hive.enforce.bucketing = true; ----默认不使用桶,现在改为使用桶
insert into table t4 select id from t3;
可以在浏览器中观察,/hive/t4表下有四个桶,分别都存储了数据。(数据加载到桶表时,会对字段值取hash值,然后与桶的数量取模。把数据放到对应的文件中)


8. 外部表(外部表不同于上面的表,上面的表都是受控表MANAGED_TABLE)
create external table t5(id int) location '/external';
hadoop fs -put /root/id /external/id
select * from t5;
9.使用Java客户端,查看Hive中表的数据
Hive远程服务启动#hive --service hiveserver >/dev/null 2>/dev/null &
JAVA客户端相关代码 (先导入hive中的Jar包)
 package hive;

 import java.sql.Connection;

 import java.sql.DriverManager;

 import java.sql.ResultSet;

 import java.sql.Statement;

 public class App {

     public static void main(String[] args) throws Exception {

         Class.forName("org.apache.hadoop.hive.jdbc.HiveDriver");

         Connection con = DriverManager.getConnection("jdbc:hive://hadoop0:10000/default", "", "");

         Statement stmt = con.createStatement();

         String querySQL="SELECT * FROM default.t1";

         ResultSet res = stmt.executeQuery(querySQL);

         while (res.next()) {

         System.out.println(res.getInt(1));

         }

     }

 }

Hive的安装和使用的更多相关文章
- Hive的安装
Hive的安装 第一步:解压并安装:第二步:配置 1)root用户下,解压后,改名为hive,并将hive文件夹赋给hadoop用户 tar -zxvf hive-0.9.0.tar.gz -C ...
- hive权威安装出现的不解错误!(完美解决)两种方法都可以
以下两种方法都可以,推荐用方法一! 方法一: 步骤一: yum -y install mysql-server 步骤二:service mysqld start 步骤三:mysql -u root - ...
- Hive的安装配置
Hive的安装配置 Hive的安装配置 安装前准备 下载Hive版本1.2.1: 1.[root@iZ28gvqe4biZ ~]# wget http://mirror.bit.edu.cn/apac ...
- hive的安装和升级
目录 [toc] 安装 升级 安装 nohup hive –service hiveserver & 启动: sudo nohup ./hive --service metastore &am ...
- Ubuntu16.04下Hive的安装与配置
一.系统环境 os : Ubuntu 16.04 LTS 64bit jdk : 1.8.0_161 hadoop : 2.6.4mysql : 5.7.21 hive : 2.1.0 在配置hive ...
- Hive的安装与部署(MySQL作为元数据库)
Hive的安装与部署(MySQL作为元数据) (开始之前确保Hadoop环境已经启动,确保Linux下的MySQL已经安装好) 1. 安装Hive (1)下载安装包 可从apache上下载hi ...
- Hive的架构原理&Hive的安装步骤
Hive架构图 元数据默认数据库是:Derby.开发使用MySQL Hive如何将SQL语句翻译成MapReduce的? 1.使用SQL解析器解析SQL语句 2.使用编译器进行编译逻辑 3.使用优化器 ...
- Hive的安装及配置
title: Hive的安装及配置 summary: 关键词:Hive ubuntu 安装和配置 Derby MySQL PostgreSQL 数据库连接 date: 2019-5-19 13:25 ...
- Hive的安装搭建(三)
03 Hive的安装搭建 Hive可以从源码中编译安装,也可以直接使用官网下载的安装包,在此处我们选择安装包解压安装的方式. Hive中最最重要的角色就是metastore 因此按照metastore ...
随机推荐
- sql server 小技巧(4) Sql server 排序时让空值排在最后
order by coalesce( u.sort, 2147483647) sql server 小技巧 集锦
- bzoj千题计划267:bzoj3129: [Sdoi2013]方程
http://www.lydsy.com/JudgeOnline/problem.php?id=3129 如果没有Ai的限制,就是隔板法,C(m-1,n-1) >=Ai 的限制:m减去Ai &l ...
- bzoj千题计划260:bzoj2940: [Poi2000]条纹
http://www.lydsy.com/JudgeOnline/problem.php?id=2940 SG 博弈入门推荐张一飞的<由感性认识到理性认识 ——透析一类搏弈游戏的解答过程> ...
- 移动端手势库hammerJS 2.0.4官方文档翻译(转)
hammerJS是一个优秀的.轻量级的触屏设备手势库,现在已经更新到2.04版本,跟1.0版本有点天壤地别了,毕竟改写了事件名并新增了许多方法,允许同时监听多个手势.自定义识别器,也可以识别滑动方向. ...
- 一些js的小技巧
这里收集了一些编码上的小技巧,大家可以学习学习. 1.浮点转整型 使用|0快速转换 var a=(12.002)|0;//12 使用~~快速转换 ~取反运算符,2=0010,~2=1101,因为第一位 ...
- 第5月第27天 cocos2d
1. 流程是这样的: 在CCApplication的run函数中,显示设备链调用相应的场景显示函数drawScene来绘制场景,然后调用了CCScheduler的update函数,在这个函数里,对所有 ...
- Servlet笔记11--补充
Servlet线程安全问题: 代码示例: package com.bjpowernode.javaweb.servlet; import java.io.IOException; import jav ...
- AF_INET域与AF_UNIX域socket通信原理对比
原文 1. AF_INET域socket通信过程 典型的TCP/IP四层模型的通信过程. 发送方.接收方依赖IP:Port来标识,即将本地的socket绑定到对应的IP端口上,发送数据时,指定对方的 ...
- mysql5.7 主从复制的正常切换【转】
目前环境如下: master server IP:172.17.61.131 slave server IP:172.17.61.132 mysql version: mysql-5.7.21-lin ...
- casper Dom的操作
phantom.casperTest = true; phantom.outputEncoding="utf-8"; var casper = require('casper'). ...