
深入理解Word2Vec
Word2Vec Tutorial - The Skip-Gram Model,Skip-Gram模型的实现原理:http://mccormickml.com/2016/04/19/word2vec-tutorial-the-skip-gram-model/
Word2Vec 数学原理详解:http://suanfazu.com/t/word2vec-zhong-de-shu-xue-yuan-li-xiang-jie-duo-tu-wifixia-yue-du/178
Word2Vec是什么?
Word2Vec 即 Word to vector,词汇转向量。2013年,Google开源了一款用于词向量计算的工具——word2vec,引起了工业界和学术界的关注。首先,word2vec可以在百万数量级的词典和上亿的数据集上进行高效地训练;其次,该工具得到的训练结果——词向量(word embedding),可以很好地度量词与词之间的相似性。
为什么使用Word2Vec?
自然语言处理(NLP)相关任务中,要将自然语言交给机器学习中的算法来处理,通常需要首先将语言数学化,因为机器不是人,机器只认数学符号。向量是人把自然界的东西抽象出来交给机器处理的东西,基本上可以说向量是人对机器输入的主要方式了。词向量就是用来将语言中的词进行数学化的一种方式,顾名思义,词向量就是把一个词表示成一个向量。
词向量主要有两种表示方法:
(1)One-Hot Representation
一种最简单的词向量方式是 one-hotrepresentation,就是用一个很长的向量来表示一个词,向量的长度为词典的大小,向量的分量只有一个 1,其他全为 0, 1 的位置对应该词在词典中的位置。举个例子,
“话筒”表示为 [0 0 0 1 00 0 0 0 0 0 0 0 0 0 0 ...]
“麦克”表示为 [0 0 0 0 00 0 0 1 0 0 0 0 0 0 0 ...]
每个词都是茫茫 0 海中的一个 1。
这种 One-hotRepresentation 如果采用稀疏方式存储,会是非常的简洁:也就是给每个词分配一个数字 ID。比如刚才的例子中,话筒记为 3,麦克记为 8(假设从 0 开始记)。如果要编程实现的话,用 Hash 表给每个词分配一个编号就可以了。这么简洁的表示方法配合上最大熵、SVM、CRF 等等算法已经很好地完成了 NLP 领域的各种主流任务。
但这种词表示有两个缺点:(1)容易受维数灾难的困扰,尤其是将其用于 Deep Learning 的一些算法时;(2)不能很好地刻画词与词之间的相似性(术语好像叫做“词汇鸿沟”):任意两个词之间都是孤立的。光从这两个向量中看不出两个词是否有关系,哪怕是话筒和麦克这样的同义词也不能幸免于难。
(2)Distributed Representation
这种就是Word2Vec得到的结果,它最早是 Hinton 于 1986 年提出的,可以克服 one-hot representation 的缺点。其基本想法是直接用一个普通的向量表示一个词,这种向量一般长成这个样子:[0.792, −0.177, −0.107, 0.109, −0.542, ...],也就是普通的向量表示形式。维度以 50 维和 100 维比较常见。
当然一个词怎么表示成这么样的一个向量是要经过一番训练的,训练方法较多,word2vec是其中一种,在后面会提到,这里先说它的意义。还要注意的是每个词在不同的语料库和不同的训练方法下,得到的词向量可能是不一样的。由于是用向量表示,而且用较好的训练算法得到的词向量的向量一般是有空间上的意义的,也就是说,将所有这些向量放在一起形成一个词向量空间,而每一向量则为该空间中的一个点,在这个空间上的词向量之间的距离度量也可以表示对应的两个词之间的“距离”。所谓两个词之间的“距离”,就是这两个词之间的语法,语义之间的相似性。
比如可能会有这样一个效果:vector(”King”) - vector(”Man”) + vector(”Woman”) ≈vector("Queen")
还有在考虑英语和西班牙语两种语言,通过训练分别得到它们对应的词向量空间 E 和 S。从英语中取出五个词 one,two,three,four,five,设其在 E 中对应的词向量分别为 v1,v2,v3,v4,v5,为方便作图,利用主成分分析(PCA)降维,得到相应的二维向量 u1,u2,u3,u4,u5,在二维平面上将这五个点描出来,如下图左图所示。类似地,在西班牙语中取出(与 one,two,three,four,five 对应的) uno,dos,tres,cuatro,cinco,设其在 S 中对应的词向量分别为 s1,s2,s3,s4,s5,用 PCA 降维后的二维向量分别为 t1,t2,t3,t4,t5,将它们在二维平面上描出来(可能还需作适当的旋转),如下图右图所示:
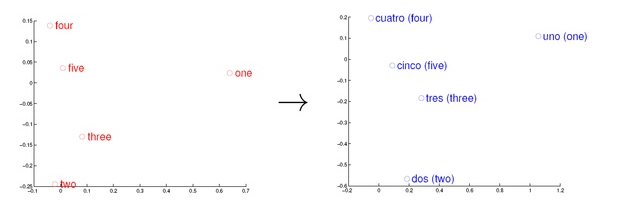
观察左、右两幅图,容易发现:五个词在两个向量空间中的相对位置差不多,这说明两种不同语言对应向量空间的结构之间具有相似性,从而进一步说明了在词向量空间中利用距离刻画词之间相似性的合理性。
Word2Vec目的就是得到具有可以描述词之间相似性的词向量,即Distributed Representation。
Word2Vec的思想
大部分的有监督机器学习模型,都可以归结为:f(x)=y
在 NLP 中,把 x 看做一个句子里的一个词语,y 是这个词语的上下文词语,那么这里的 f,便是 NLP 中经常出现的『语言模型』(language model),这个模型的目的,就是判断 (x,y) 这个样本,是否符合自然语言的法则,更通俗点说就是:词语x和词语y放在一起,是不是人话。
Word2vec 正是来源于这个思想,但它的最终目的,不是要把 f 训练得多么完美,而是只关心模型训练完后的副产物——模型参数(这里特指神经网络的权重),并将这些参数,作为输入 x 的某种向量化的表示,这个向量便叫做——词向量(这里看不懂没关系,下一节我们详细剖析)。
我们来看个例子,如何用 Word2vec 寻找相似词:
- 对于一句话:『她们 夸 吴彦祖 帅 到 没朋友』,如果输入 x 是『吴彦祖』,那么 y 可以是『她们』、『夸』、『帅』、『没朋友』这些词
- 现有另一句话:『她们 夸 我 帅 到 没朋友』,如果输入 x 是『我』,那么不难发现,这里的上下文 y 跟上面一句话一样
- 从而 f(吴彦祖) = f(我) = y,所以大数据告诉我们:我 = 吴彦祖(完美的结论)
Word2Vec的语言模型:Skip-gram 和 CBOW
- 如果是用一个词语作为输入,来预测它周围的上下文,那这个模型叫做『Skip-gram 模型』
- 而如果是拿一个词语的上下文作为输入,来预测这个词语本身,则是 『CBOW 模型』
深入理解Word2Vec的更多相关文章
- 理解 Word2Vec 之 Skip-Gram 模型
理解 Word2Vec 之 Skip-Gram 模型 天雨粟 模型师傅 / 果粉 https://zhuanlan.zhihu.com/p/27234078 508 人赞同了该文章 注明:我发现知乎有 ...
- 通俗理解word2vec
https://www.jianshu.com/p/471d9bfbd72f 独热编码 独热编码即 One-Hot 编码,又称一位有效编码,其方法是使用N位状态寄存器来对N个状态进行编码,每个状态都有 ...
- 通俗理解word2vec的训练过程
https://www.leiphone.com/news/201706/eV8j3Nu8SMqGBnQB.html https://blog.csdn.net/dn_mug/article/deta ...
- 理解Word2Vec
一.简介 Word2vec 是 Word Embedding 的方法之一,属于NLP 领域.它是将词转化为「可计算」「结构化」的向量的过程.它是 2013 年由谷歌的 Mikolov 提出了一套新的词 ...
- 一步一步理解word2Vec
一.概述 关于word2vec,首先需要弄清楚它并不是一个模型或者DL算法,而是描述从自然语言到词向量转换的技术.词向量化的方法有很多种,最简单的是one-hot编码,但是one-hot会有维度灾难的 ...
- 对word2vec的理解及资料整理
对word2vec的理解及资料整理 无他,在网上看到好多对word2vec的介绍,当然也有写的比较认真的,但是自己学习过程中还是看了好多才明白,这里按照自己整理梳理一下资料,形成提纲以便学习. 介绍较 ...
- (转)word2vec前世今生
word2vec 前世今生 2013年,Google开源了一款用于词向量计算的工具——word2vec,引起了工业界和学术界的关注.首先,word2vec可以在百万数量级的词典和上亿的数据集上进行高效 ...
- 深度学习word2vec笔记之算法篇
深度学习word2vec笔记之算法篇 声明: 本文转自推酷中的一篇博文http://www.tuicool.com/articles/fmuyamf,若有错误望海涵 前言 在看word2vec的资料 ...
- word2vec原理(二) 基于Hierarchical Softmax的模型
word2vec原理(一) CBOW与Skip-Gram模型基础 word2vec原理(二) 基于Hierarchical Softmax的模型 word2vec原理(三) 基于Negative Sa ...
随机推荐
- DL中epoch、batch等的意义【转载】
转自:深度学习中 number of training epochs 中的 epoch到底指什么? - 知乎 https://www.zhihu.com/question/43673341 1. (1 ...
- Angular1和Aangular4剖析
字面解析: 1.Angular1又名angularJs,从angular2,angular4都不带JS 2.变化:angular2跳转到angular4 架构: 1.angular1是基于MVC 2. ...
- 根据白名单过滤 HTML(防止 XSS 攻击)
https://github.com/leizongmin/js-xss/blob/master/README.zh.md 根据白名单过滤 HTML(防止 XSS 攻击) xss是一个用于对用户输入的 ...
- 如何设置locale
什么是 locale? 是根据计算机用户所使用的语言,所在国家或者地区,以及当地的文化传统所定义的一个软件运行时的语言环境 locale定义文件放在目录 /usr/share/i18n/locales ...
- iOS UI进阶-3.0 核心动画
Core Animation是一组非常强大的动画处理API,使用它能做出非常炫丽的动画效果,而且往往是事半功倍,使用它需要先添加QuartzCore.framework和引入对应的框架<Quar ...
- cocos2d JS 监听键盘触摸响应事件(cc.EventListener.KEYBOARD)
除了可以监听键盘按键,还可以是终端设备的各个菜单键,都能使用同一个监听器来进行处理. //给statusLabel绑定键盘事件 cc.eventManager.addListener({ event: ...
- cocos2d-x JS 复选按钮checkBox的单选与多选
var HZ_createRoom = jx.BaseView.extend({//红中麻将 ctor : function() { this._super(); this.addLayout(res ...
- dotnet 命令
以下用实例串起dotnet常用命令,带你玩转dotnet命令. 1.创建(dotnet new) 首先我们创建一个项目,这里我们创建控制台程序,命令如下图所示. dotnet new dotnet n ...
- 43.HTML--a标签之mailto邮箱属性用法
HTML 属性标记之 mailto 的用法详解 大家知道,mailto是网页设计制作中的一个非常实用的html标签,许多拥有个人网页的朋友都喜欢在网站的醒目位置处写上自己的电子邮件地址,这样网页浏 ...
- schame定义及用处
一.schame详解 http://www.cnblogs.com/Neo-ds/p/4790413.html 1.先明确一点,SQL Server中模式(schema)这个概念是在2005的版本里才 ...