
(转)spark日志配置
一、第一部分
1、spark2.1与hadoop2.7.3集成,spark on yarn模式下,需要对hadoop的配置文件yarn-site.xml增加内容,如下:

<property>

        <name>yarn.log-aggregation-enable</name>

        <value>true</value>

</property>

<property>

        <name>yarn.log.server.url</name>

        <value>http://node2:19888/jobhistory/logs</value>

</property>

<property>

        <name>yarn.nodemanager.pmem-check-enabled</name>

        <value>false</value>

</property>

<property>

        <name>yarn.nodemanager.vmem-check-enabled</name>

        <value>false</value>

</property>
2、spark的conf/spark-defaults.conf配置
spark.yarn.historyServer.address=node2:18080

spark.history.ui.port=18080

spark.eventLog.enabled=true

spark.eventLog.dir=hdfs:///tmp/spark/events

spark.history.fs.logDirectory=hdfs:///tmp/spark/events
如果你是运行在yarn之上的话,就要告诉yarn,你spark的地址,当我在yarn上点击一个任务,进去看history的时候,他会链接到18080里面,如果你配的是node1:18080,那么你就要在node1上启动spark的history server(见后面注①)
最下面两个配置是运行spark程序的时候配置的,一旦你运行spark,就会将日志等发送到那两个目录,有了这两个目录,spark的historyserver就可以读取spark的运行状态信息日志等读取并展示
18080是spark的history server,会显示出你最近spark跑过的一些程序,点击execution后,点击最右边的日志(如果有的话),会重定向到19888(见后面注②),这个是mr的jobserver的地址(启动命令:mr-jobhistory-daemon.sh start historyserver)
spark.yarn.historyServer.address和spark.history.ui.port如果缺少其中一个,日志就看不到
综上,1和2两个配置齐全,才可以查看spark的stdout和stderr日志
二、第二部分

实际上,在spark程序运行的时候,会起一个driver程序和多个executor程序,他们都是跑在nodemanager之上的,在启动程序的时候,如果我们在默认的配置项里面,配置了参数spark.eventLog.enabled=true,spark.eventLog.dir=地址,那么driver上就会把所有的事件全部给记录下来,事件包括,executor的启动,executor执行的task等发送给driver
每当写日志的时候,都有一个写日志的组件将日志写进那个目录里面,这个目录下面每一个应用程序都会存在一个文件,然后将会由spark的history server(也就是配置在spark-default.conf里面),这个server会在18080启动一个进程,去扫描日志目录,并解析每一个文件,进行还原,就得到了整个应用的状态
在hadoop-2.7.3/etc/hadoop/mapred-site.xml配置文件中
<property>

<name>mapreduce.jobhistory.done-dir</name>

<value>/user/history/done</value>

</property>

<property>

<name>mapreduce.jobhistory.intermediate-done-dir</name>

<value>/user/history/done_intermediate</value>

</property>
stdlog和err是每一个nodemanager上的每一个executor都会产生的,如果当程序完成后,在这个节点上,跟这个应用相关的所有信息全部会被清除掉,包括这些日志,这样的话如果我们不把这个日志收集起来,那么后面在历史信息(18080 executord模块的stderr和out)里面就看不到这些日志
为了能够看到这些日志,我们要做的事情是,让nodemanager开启一个日志聚合的功能,这个功能的作用是,当应用程序终止的时候,需要将这个应用程序产生的所有日志全部聚集到远程hdfs上的一个目录,聚集之后,还需要通过一个http的接口去查看这些日志,查看日志的这个角色就叫做mr的history server,通过她的web ui接口,当我们点击std日志的时候,就会跳转到mr job history server这个地址上19888上,然后去把这个日志展示出来
三、总结
总的来说,yarn-site.xml和conf/spark-defaults.conf这两个配置文件中的地址比较关键
http://node2:19888/jobhistory/logs : 对应的是点击strout的时候跳转的地址
spark.yarn.historyServer.address=node2:18080 :对应的是在yarn里点击history,跳转的地址
注①:
1、进入yarn的web ui页面,点击左侧FINISHED,可查看运行完的作业,点击一个app id

2、进入下图页面,点击History
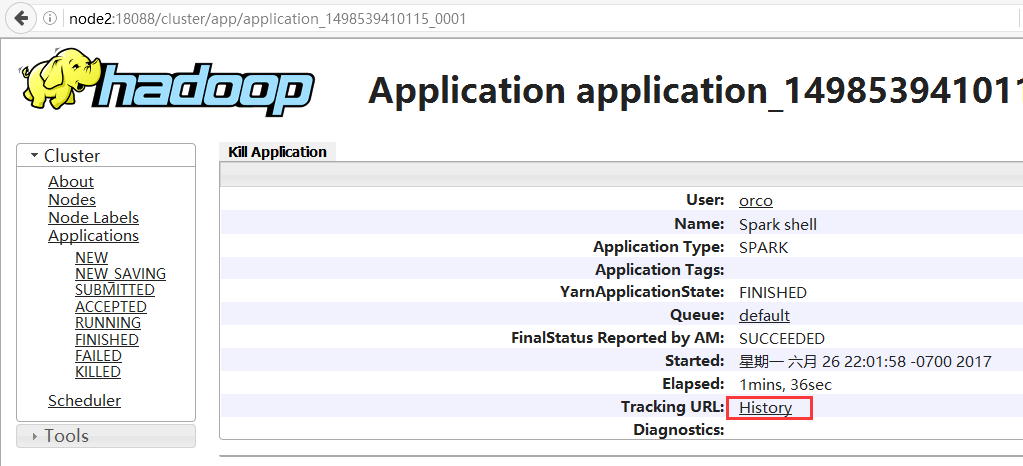
3、重定向到conf/spark-defaults.conf配置的地址

注②:
具体步骤如下:
1、我先运行一个spark程序
bin/spark-shell --master local
2、登录Spark History server的web ui
http://node1:18080/
3、如下图,找到我刚才运行的程序
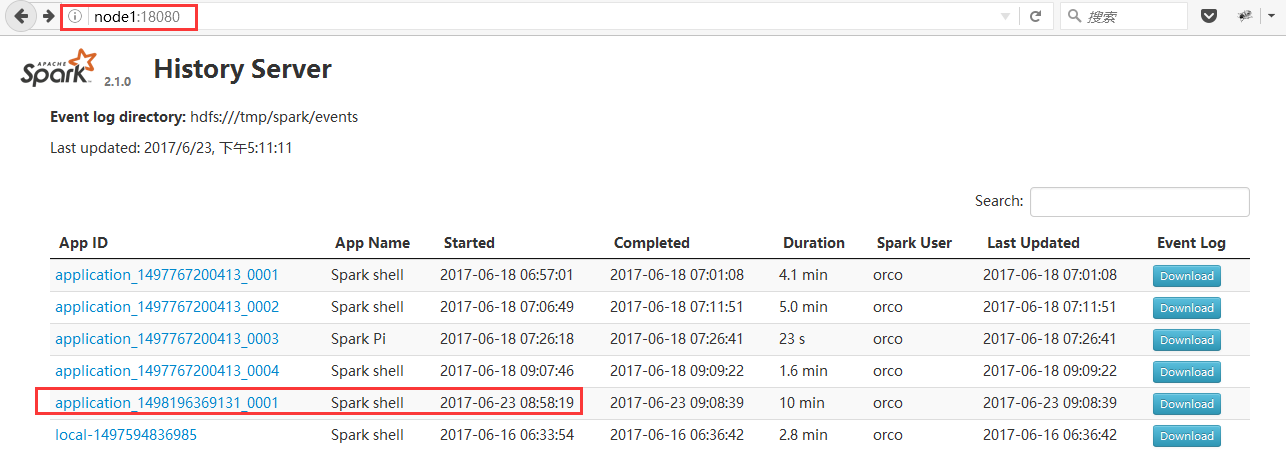 4、点击红框位置App ID,进入如下图页面
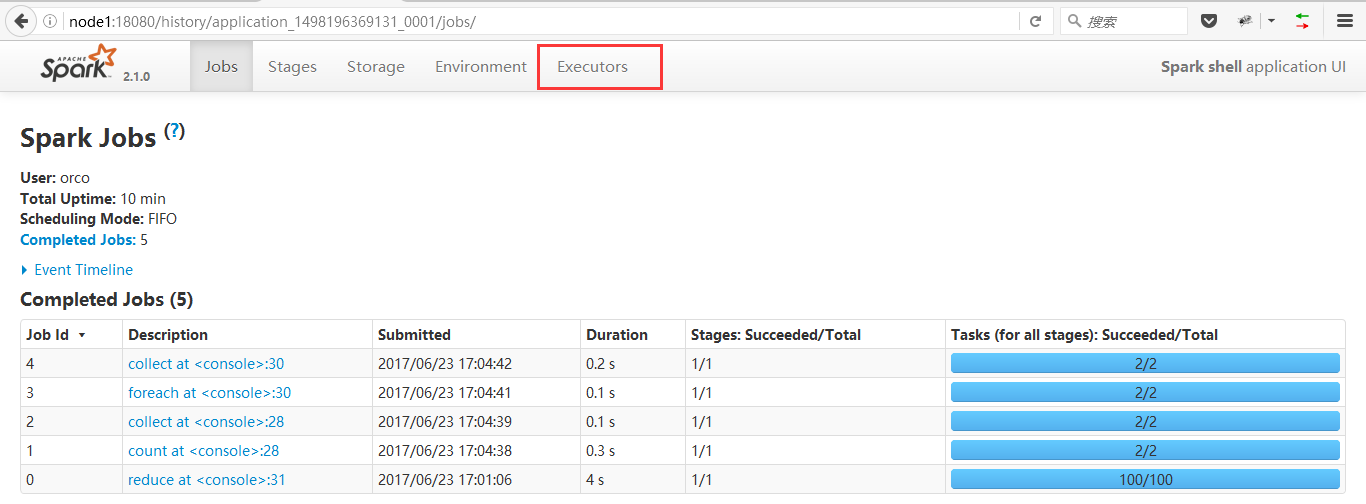
5、点击红框位置Executor,进入下图页面
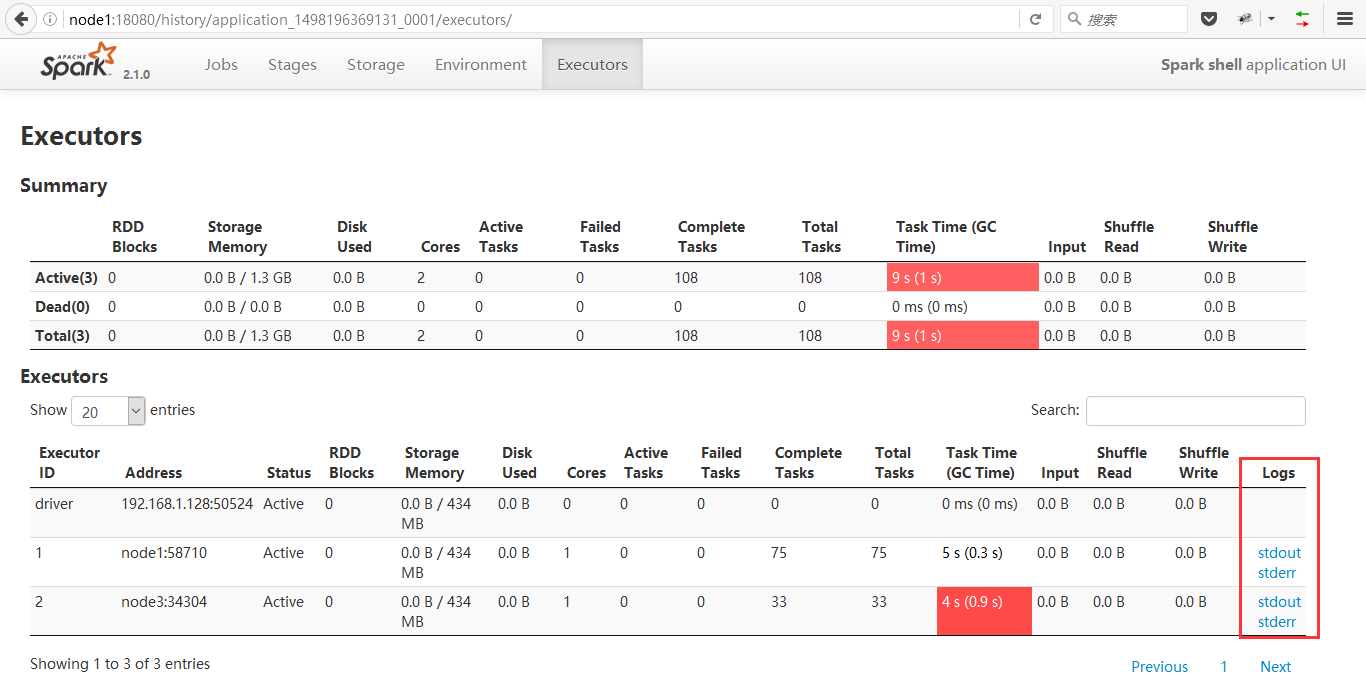
6、右下角的stderr和stdout就是我们此行的目标了
<property>

        <name>yarn.log.server.url</name>

        <value>http://node2:19888/jobhistory/logs</value>

</property>
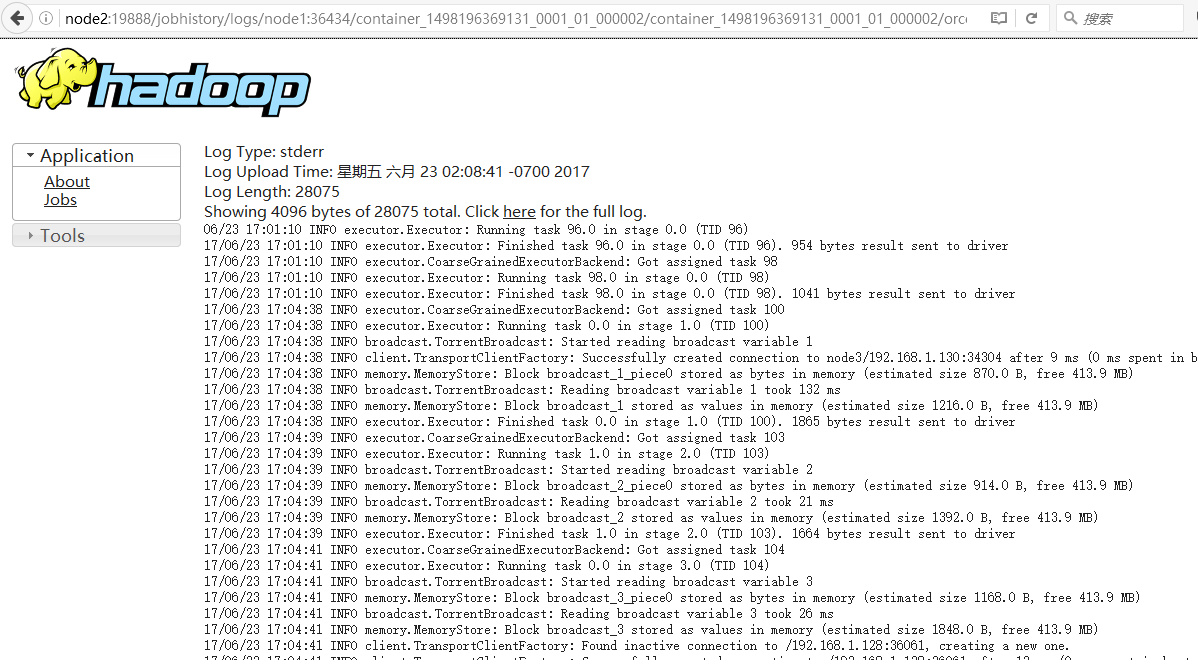
当你点击stderr或stdout,就会重定向到node2:19888,所以如果这里你配错了,那这两个日志你是看不了的
node2:19888是你的MapReduce job history server的启动节点地址
进入页面如下图
https://www.cnblogs.com/sorco/p/7070922.html
(转)spark日志配置的更多相关文章
- spark日志配置及问题排查方式。
此文已由作者岳猛授权网易云社区发布. 欢迎访问网易云社区,了解更多网易技术产品运营经验. 任何时候日志都是定位问题的关键,spark也不会例外,合适的配置和获取spark的driver,am,及exe ...
- spark入门(四)日志配置
1 背景 在测试spark计算时,将作业提交到yarn(模式–master yarn-cluster)上,想查看print到控制台这是很难的,因为作业是提交到yarn的集群上,所以,去yarn集群上看 ...
- Spark 属性配置
1.Spark1.x 属性配置方式 Spark属性提供了大部分应用程序的控制项,并且可以单独为每个应用程序进行配置. 在Spark1.0.0提供了3种方式的属性配置: SparkConf方式 Spar ...
- Spark日志,及设置日志输出级别
Spark日志,及设置日志输出级别 1.全局应用设置 2.局部应用设置日志输出级别 3.Spark log4j.properties配置详解与实例(摘录于铭霏的记事本) 文章内容来源: 作者:大葱拌豆 ...
- django 1.8 日志配置
django 1.8 日志配置 以下为setings配置logging代码片段 BASE_DIR = os.path.dirname(os.path.dirname(os.path.abspath(_ ...
- nginx日志配置
nginx日志配置 http://www.ttlsa.com/linux/the-nginx-log-configuration/ 日志对于统计排错来说非常有利的.本文总结了nginx日志相关的配置如 ...
- 日志配置logback
在选择项目日志框架时,发现log4j的作者开发了新的日志框架,据说性能提高不少,那就选它了,不过,除了配置上有点不习惯外,最重要的一点 ,打印线程号这个功能依然没有(打印线程名这个东西是在是个鸡肋). ...
- 服务器是windows时tomcat无法打印所有日志配置修改
Tomcat运行仅一天磁盘空间突然就增加了很多,发现是日志文件太大了,修改tomcat的日志配置即可. 查看目录所占空间大小: ? 1 [root@XXX webapps]du -sh 清理方法: ? ...
- [译]Stairway to Integration Services Level 12 - 高级日志配置
介绍 本文中,我们将结合之前学习的时间冒泡,日志记录,以及复制模型.建立一个自定义的SSIS包日志模型. SSIS Task事件回顾 Reviewing SSIS Task Events 在做实 ...
随机推荐
- 第一篇:初识ASP.NET控件开发_第二节:HelloWorld
1)步骤一:新建类库项目:Controls,创建新解决方案:CustomLibrary 2)步骤二:在类库项目中添加“ASP.NET服务器控件”新建项:RenderHelloWorld.cs (也可以 ...
- Java 8 Stream – Read a file line by line
In Java 8, you can use Files.lines to read file as Stream. c://lines.txt – A simple text file for te ...
- Python 图像下载解决图像损坏
在下载图片的过程中,经常会发现图片损坏,下面提供了两种解决方法: 方法一: if response.status_code == 200: print '======================= ...
- 【转】在一个Job中同时写入多个HBase的table
在进行Map/Reduce时,有的业务需要在一个job中将数据写入到多个HBase的表中,下面是实现方式. 原文地址:http://lookfirst.com/2011/07/hbase-multit ...
- vue.js 首屏优化
我们以 vue-cli 工具为例,使用 vue-router 搭建SPA应用,UI框架选用 element-ui , ajax方案选用 axios, 并引入 vuex ,使用 vuex-router- ...
- ssr.js数据模拟工具
ssr相当于是搭建了一个 Mock Server ,构建假数据,然后把这些假数据存到 JSON 文件上,Mock Server 可以响应请求或者生成页面,当然也可以顺便生成 API 文档. 强制跨域访 ...
- HTML5学习笔记(三):语义化和新增结构元素
在HTML5之前,使用机器来阅读一个网页是非常困难的,我们使用不同样式的div来标记不同的内容,所以实际上机器无法得知页面的哪个部分是正文,哪个部分是标题,那么在HTML5里,针对这个问题就引入了语义 ...
- 【小白的CFD之旅】21 网格划分软件的选择
但是怎样才能获得流体计算网格呢?“工欲善其事必先利其器”,画网格该用什么器呢?小白决定找黄师姐请教一番. 小白找到黄师姐的时候,黄师姐正在电脑上忙着. “黄师姐,我发现网格划分软件有好多种,究竟哪种才 ...
- bitcoin双花
https://en.bitcoin.it/wiki/Irreversible_Transactions https://www.reddit.com/r/Bitcoin/comments/2e7bf ...
- nginx 屏蔽恶意请求
https://www.xlongwei.com/detail/nginx-%E5%B1%8F%E8%94%BD%E6%81%B6%E6%84%8F%E8%AF%B7%E6%B1%82 nginx可以 ...