
kafka Auto offset commit faild reblance
今天在使用python消费kafka时遇到了一些问题, 特记录一下。
场景一、
特殊情况: 单独写程序只用来生产消费数据
开始时间: 10:42
Topic: t_facedec
Partition: 1
程序启动: 168 启动consumer, 158启动consumer, windows机器producer推数据
运行时长: 15分钟
结果:
1、168的consume暂停,158的consumer一直消费
2、10:46分producer停止后重启推数, 158停止消费又开始消费
3、10:49分停止168、158的consumer并按顺序重启, 168消费一些数据之后158开始一直消费
4、后启动的consumer在消费数据
场景二、
特殊场景: 上线程序, 包含人脸识别处理
开始时间: 11:00
Topic: t_facedec
Partition: 1
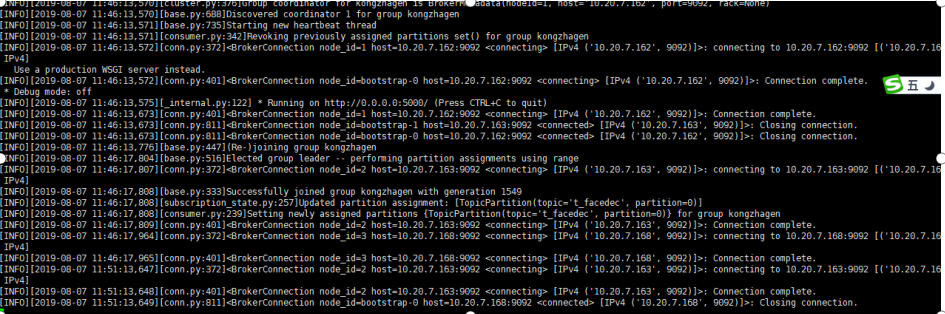
1、11:46 启动168的conumer消费, 6分钟后日志如下, 未见异常信息
场景二、
特殊场景: 上线程序, 包含人脸识别处理
开始时间: 11:00
Topic: t_facedec
Partition: 1
1、11:46 启动168的conumer消费, 6分钟后日志如下, 未见异常信息
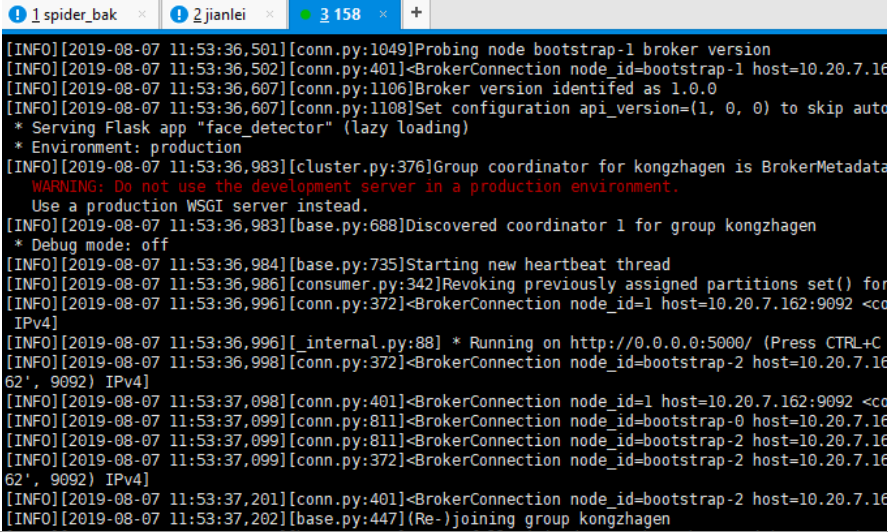
2、 11:53启动158的consumer, 日志如下, 未见异常, 158的consumer加入了组kongzhagen

3、168的consumer发出警告, 心跳失败,因组正在重新平衡

4、windows端启动producer, 168的consumer开始消费数据, 158的consumer没有消费数据
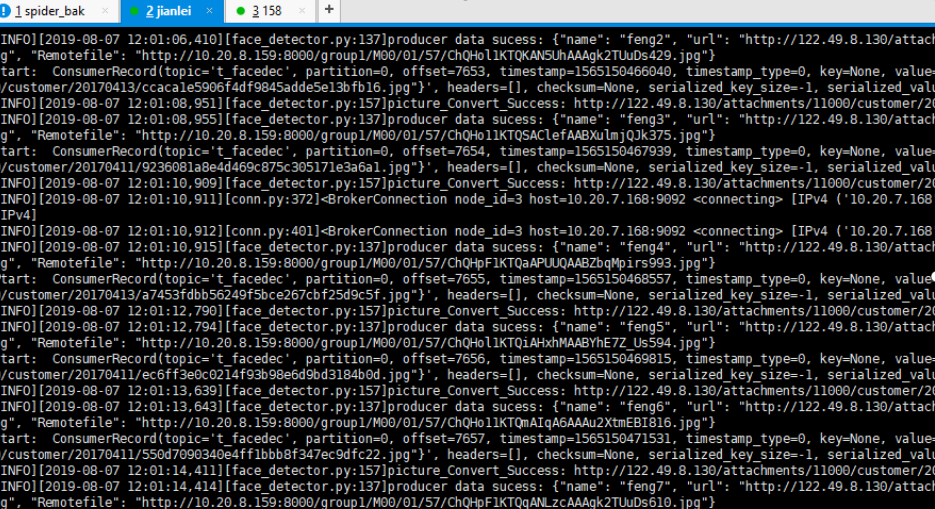
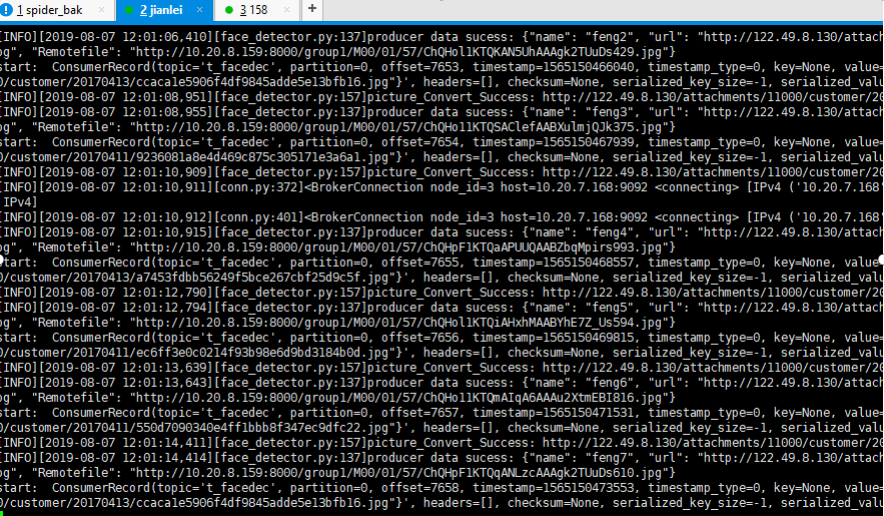
结论: 先启动的consumer会消费数据, 168的consumer关闭后, 158的consumer开始消费
5、半小时后
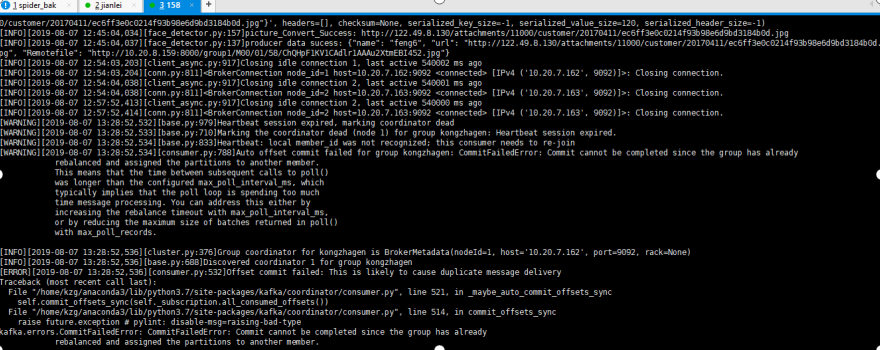
分解错误图:
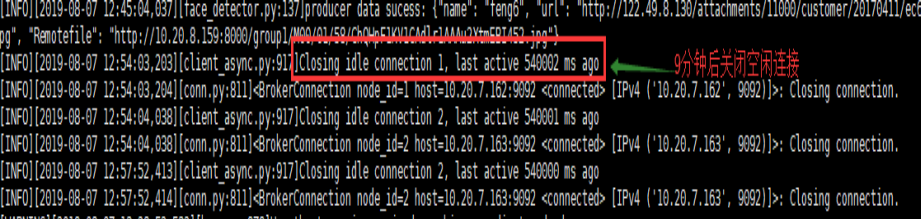
9分钟后空连接时间到'connections_max_idle_ms': 540000,
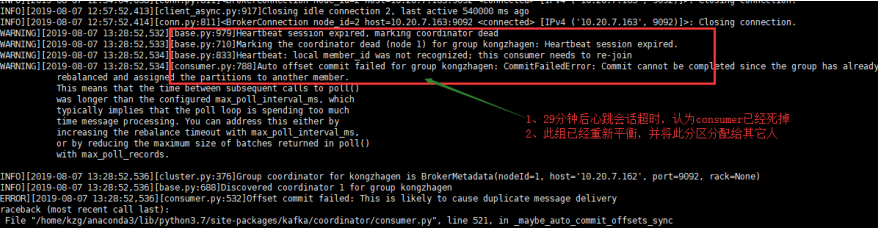
'max_poll_records': 500, 'heartbeat_interval_ms': 3000, 'session_timeout_ms': 30000,
后续:
14:32开始继续生产数据, 数据开始被消费

14:48分再次出现平衡超时

15:02分再次出现平衡超时

原因分析:
1、引起timeout的原因是consumer每3秒触发一次心跳, 由于某种原因在30秒内协调者没有收到此consumer的心跳信息, 认为此consumer已经死掉,topic内的分区在group的成员间重新分配(reblance)
2、默认consumer的每次最大poll数据量为500, 如果处理这500条记录的时候超过了最大时间间隔max_poll_interval_ms, consumer也会退出group, 导致reblance的产生
3、如果consumer没有产生消费行为的时间超过最大值connections_max_idle_ms:540000 (9 min)时, 也会导致consumer退出该组。
解决方法:
1、增加心跳会话超时间隔
session_timeout_ms = 300000(从30改为300秒)
2、减少每次获取任务的数量
max_poll_records = 5(从500改为5)
3、增加空闲连接时间
connections_max_idle_ms=5400000(从9min改为90min)
kafka Auto offset commit faild reblance的更多相关文章
- kafka auto.offset.reset参数解析
kafka auto.offset.reset参数解析 1.latest和earliest区别 2.创建topic 3.生产数据和接收生产数据 4.测试代码 auto.offset.reset关乎ka ...
- Kafka auto.offset.reset
要从头消费kafka的数据,可以通过以下参数: Kafka auto.offset.reset = earliest
- kafka之consumer参数auto.offset.reset 0.10+
https://blog.csdn.net/dingding_ting/article/details/84862776 https://blog.csdn.net/xianpanjia4616/ar ...
- kafka的auto.offset.reset详解与测试
1. 取值及定义 auto.offset.reset有以下三个可选值: latest (默认) earliest none 三者均有共同定义: 对于同一个消费者组,若已有提交的offset,则从提交的 ...
- kafka的offset相关知识
Offset存储模型 由于一个partition只能固定的交给一个消费者组中的一个消费者消费,因此Kafka保存offset时并不直接为每个消费者保存,而是以 groupid-topic-partit ...
- 「Kafka」Kafka中offset偏移量提交
在消费Kafka中分区的数据时,我们需要跟踪哪些消息是读取过的.哪些是没有读取过的.这是读取消息不丢失的关键所在. Kafka是通过offset顺序读取事件的.如果一个消费者退出,再重启的时候,它知道 ...
- kafka主题offset各种需求修改方法
简要:开发中,常常因为需要我们要认为修改消费者实例对kafka某个主题消费的偏移量.具体如何修改?为什么可行?其实很容易,有时候只要我们换一种方式思考,如果我自己实现kafka消费者,我该如何让我们的 ...
- Kafka提交offset机制
在kafka的消费者中,有一个非常关键的机制,那就是offset机制.它使得Kafka在消费的过程中即使挂了或者引发再均衡问题重新分配Partation,当下次重新恢复消费时仍然可以知道从哪里开始消费 ...
- kafka_2.11-0.10.2.1中的auto.offset.reset
在使用spark连接kafka消费topic时,发现无论怎么设置,也无法从头开始消费. 查看配置得出auto.offset.reset的以下3种设置及含义: earliest 当各分区下有已提交的of ...
随机推荐
- vue 仿写微信公众号自定义菜单
先看效果图 代码参考 <template> <div> <!-- 公众号设置 --> <el-col :span="24" style=& ...
- 【1】BIO与NIO、AIO的区别
一.BIO 在JDK1.4出来之前,我们建立网络连接的时候采用BIO模式,需要先在服务端启动一个ServerSocket,然后在客户端启动Socket来对服务端进行通信,默认情况下服务端需要对每个请求 ...
- GOF 的23种JAVA常用设计模式 学习笔记 持续更新中。。。。
前言: 设计模式,前人总结下留给后人更好的设计程序,为我们的程序代码提供一种思想与认知,如何去更好的写出优雅的代码,23种设计模式,是时候需要掌握它了. 1.工厂模式 大白话:比如你需要一辆汽车,你无 ...
- 报告题目:HAO智能:HI + AI + OI
报告题目:HAO智能:HI + AI + OI 报告摘要:大数据面向异构自治的多源海量数据, 旨在挖掘数据间复杂且演化的关联.大数据知识工程(BigKE)从大数据的 HACE定理开始, 从大知识建模 ...
- Unable to instantiate org.apache.hadoop.hive.ql.metadata.SessionHiveMetaStoreClient报错,问题排查
背景 最近在整合pyspark与hive,新安装spark-2.3.3以客户端的方式访问hive数据,运行方式使用spark on yarn,但是在配置spark读取hive数据的时候,这里直接把hi ...
- pip install scrapy 报错
最近在研究Python,安装scrapy过程中报错如下图: 尝试找了一下解决方式:下载已经编译好的.whl安装包 步骤如下: 1.下载与Python版本和系统版本相匹配的Twisted包,网址:htt ...
- 子进程的LD_PRELOAD
一个指定LD_PRELOAD的进程创建的子进程是否受LD_PRELOAD的影响? 1. fork()后在子进程中执行函数. main.c #include <unistd.h> #incl ...
- vs code 调试设置
首先vs code 安装插件:Debugger for Chrome vscode 设置:点击调试按钮,然后调试面板界面再点击设置按钮,添加一个配置,选择环境为:chrome编辑器自动生成一个laun ...
- 【iOS录音与播放】实现利用音频队列,通过缓存进行对声音的采集与播放
都说iOS最恶心的部分是流媒体,其中恶心的恶心之处更在即时语音. 所以我们先不谈即时语音,研究一下,iOS中声音采集与播放的实现. 要在iOS设备上实现录音和播放功能,苹果提供了简单的做法,那就是利用 ...
- MySQL Backup--xtrabackup与Bulk Load for Create Index
场景描述:主从使用MySQL 5.7.19 1.从库上使用xtrabackup进行热备. 2.主库行执行DDL创建索引: ALTER TABLE `tb_xxx` ADD INDEX idx_good ...