
【爬虫入门手记03】爬虫解析利器beautifulSoup模块的基本应用
【爬虫入门手记03】爬虫解析利器beautifulSoup模块的基本应用
1、引言
网络爬虫最终的目的就是过滤选取网络信息,因此最重要的就是解析器了,其性能的优劣直接决定这网络爬虫的速度和效率。BeautifulSoup可以通过定位HTML件中的标签来格式化和组织复杂的网络信息,尝试化平淡为神奇,用简单易用的Python对象为我们展现XML的信息结构,它会帮你节省数小时甚至数天的工作时间。
2、什么是BeautifulSoup模块?
BeautifulSoup是一个非常优秀的Python扩展库,它可以从HTML或XML文件中提取我们感兴趣的数据。它不但可以标签进行查找,还可以通过标签属性来查找。 BeautifulSoup除了支持Python标准库中的HTML解析器之外,还支持一些第三方的解析器,可以有针对性地向网页进行解析。 BeautifulSoup官方推荐使用lxml作为解析器,据说因为lxml解析器的效率更高。
学习BeautifulSoup的最完整和最好资料是官方文档,常用的内容熟练掌握,不常用的需要的时候查阅就好。在本文中,只总结爬虫开发中常用知识,更多内容要看官方文档:
http://beautifulsoup.readthedocs.io/zh_CN/latest/#id18
3、对象的种类
BeautifulSoup对象是一个复杂的树形结构,它的每一个节点都是一个Python对象,获取网页内容就是一个提取对象内容的过程,其提取对象的方法可以分为:遍历文档树、搜索文档树、CSS选择器。
所有的对象可以分为4种:
<1> Tag:Tag对象与XML或HTML原生文档中的tag相同。它有很多方法和属性,其中最重要的是:name和attributes。BeautifulSoup对象通过find()和find_all()方法,或者直接调用子标签获取一列对象或单个对象。
<2> NavigableString:用来表示标签里的文字,不是标签。
<3> Comment:这是一个特殊类型的NavigableString对象,用来查找HTML文档中的注释。
<4> BeautifulSoup:这个对象表示文档的全部内容。大部分时候可以把它当作Tag对象,它支持遍历文档树和搜索文档树的大部分方法。
4、官方测试样例
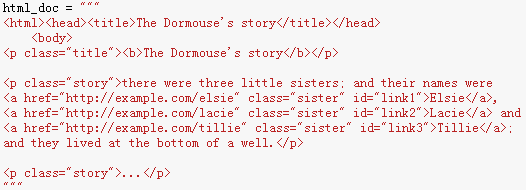
5、遍历文档树
文档树的遍历方法就好像爬树一样,需要首先爬到树干上,然后慢慢爬到小树干,最后到树枝上,就可以得到需要的数据了。
例1:获取文档树中的‘body标签中的‘p’标签中的’‘b’标签。

在遍历文档树中,搞清各个标签之间的关系是非常重要的。子标签就是一个父标签的下一级;而后代标签是指一个父标签下面所有级别的标签。所有子标签都是后代标签,但不是所有的后代标签都是子标签。一般情况下,BeautifulSoup的方法总是处理当前标签的后代标签。
可以通过 .parent 属性来获取某个元素的父节点.
例2:获取文档树中‘p’标签的父标签。
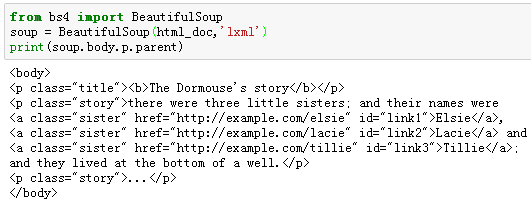
tag的.contents 属性可以将tag的子节点以列表的方式输出;通过tag的.children 生成器,也可以对tag的子节点进行循环。
例3:获取文档树中‘p’标签的子标签。
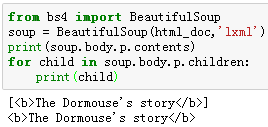
6、搜索文档树
相对于遍历文档树来说,搜索文档树最常用。在搜索文档树时,最常用的是find_all()和find()方法。在这里,主要通过例子讲述find_all()的常见使用,关于find_all()的具体描述参见官方文档。
find_all (name, attrs, recursive, string, limit, keyword)
该方法搜索当前tag的所有tag子节点,并判断是否符合过滤器的条件。
[1] name参数:可以查找所有名字为name的tag,字符串对象会自动忽略掉。该参数的值可以接受:字符串、正则表达式、列表和True。
例4:搜索文档树中的‘title’标签。
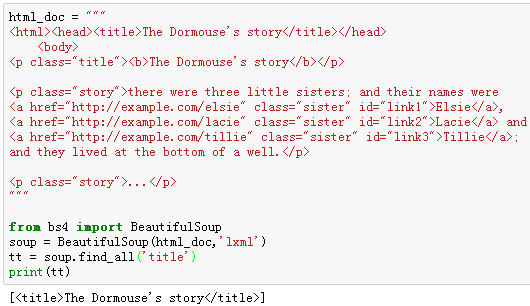
例5:搜索文档树中的‘a’标签,逐条打印出来。

[2] attrs参数:是用一个Python字典封装一个标签的若干属性和对应的属性值。
例6:搜索‘a’标签中,id属性的值为“link2”的标签。
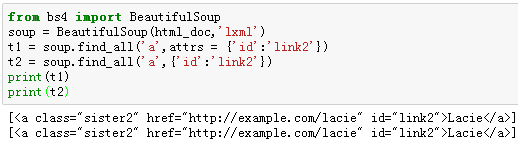
因为表示CSS类名的关键字class在Python中是保留字,所以,在按照CSS类名搜索tag的时候,如果使用class作为参数会导致语法的错误,不过,可以通过class_搜索指定CSS类名的tag,或者通过字典的方式指定参数。
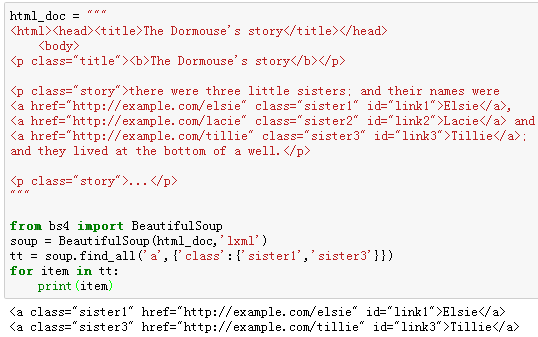
例7:搜索‘a’标签中,class属性的值为“sister1”的标签。

例8:搜索‘a’标签中,class属性的值为“sister1”和属性值为“sister3”的标签。
[3] recursive参数:是一个布尔变量。该参数为True,find_all()就会根据你的要求去查找标签参数的所有子标签,以及子标签的子标签。如果该参数为False,find_all()就只查找文档一级标签。该参数默认是True的,一般情况下不需要修改,除非你真正了解自己需要那些信息,而且抓去的速度非常重要,那么你可以设置该参数。
[4] string参数:通过该参数可以搜索文档中的字符串内容,与name参数相似,其可选值一样,接受:字符串、正则表达式、列表和True,例如:
soup.find_all(string = "Elsie")
soup.find_all(string = ["Elsie", "Tillie", "Lacie"])
soup.find_all(string = re.compile("Dormouse"))
该参数还可以与其他参数混合使用来过滤:
soup.find_all("a", string = "Elsie")
例9:搜索文档树中符合列表中参数的字符串内容。

[5] limit参数:find_all()方法返回的是全部的搜索结果,如果我们不需要全部结果,可以使用limit参数来限制返回结果的数量。当搜索到的结果数量达到limit的限制时,就停止搜索返回结果。find()方法实际上等价于find_all()的limit参数为1的情形。
例10:搜索'a'标签并返回一个结果。

[6]keyword参数:如果一个指定名字的参数不是搜索内置的参数名,搜索时会把该参数当作指定名字tag的属性来搜索。
通过标签参数name把标签列表传到find_all()里获取一系列标签,其实就是一个“或”关系的过滤器;而关键字参数keyword可以让你增加一个“与”关系的过滤器来简化工作。
如果传入一个名字为id的参数,BeautifulSoup会搜索每一个tag的id属性,如果传入href参数,则会搜索每一个tag的href属性。在搜索指定名字的属性时,可以使用的参数值包括:字符串、正则表达式、列表和True。
例11:在文档树中查找所有包含id属性的tag,无论id属性的值是什么。

例12:查找id属性值为link2的标签。
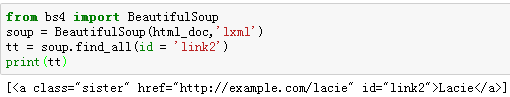
除了上面的基础应用之外,关于find_all()使用可以相当灵活,需要通过在实践中不断的体会和积累,我们在看几个例子:
例13:使用多个指定名字的参数,同时过滤tag的多个属性。
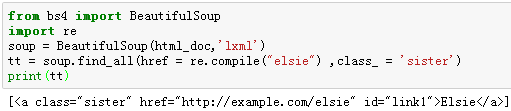
例14:将‘a’标签中的网络链接抓取出来。

例15:将‘a’标签中的网络链接和字符串抓取出来,形成可视数据。
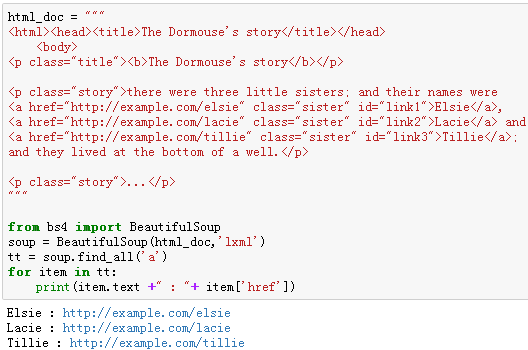
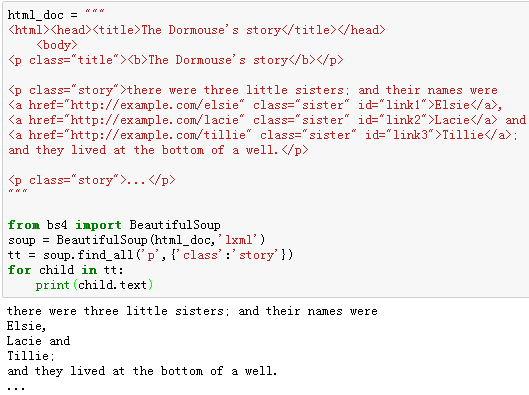
例16:将class属性值为“story”的‘p’标签的全部子标签的文本抓取出来。
7、小结
对爬取网页的解析工作,除了 BeautifulSoup之外,还可以使用re正则表达式、lxml解析器、xpath等等来实现,熟练掌握一个工具,学习其他的会很容易。BeautifulSoup的用法远不止此,但作为网络爬虫的入门应用,上述知识基本足够。如果在学习过程中观看不练,会感觉非常抽象,无法理解;如果只知道敲代码而忽略了为什么,也只能一知半解,难以灵活应用。
【爬虫入门手记03】爬虫解析利器beautifulSoup模块的基本应用的更多相关文章
- 【网络爬虫入门03】爬虫解析利器beautifulSoup模块的基本应用
[网络爬虫入门03]爬虫解析利器beautifulSoup模块的基本应用 1.引言 网络爬虫最终的目的就是过滤选取网络信息,因此最重要的就是解析器了,其性能的优劣直接决定这网络爬虫的速度和效率.B ...
- 【网络爬虫入门01】应用Requests和BeautifulSoup联手打造的第一条网络爬虫
[网络爬虫入门01]应用Requests和BeautifulSoup联手打造的第一条网络爬虫 广东职业技术学院 欧浩源 2017-10-14 1.引言 在数据量爆发式增长的大数据时代,网络与用户的沟 ...
- 2.Python爬虫入门二之爬虫基础了解
1.什么是爬虫 爬虫,即网络爬虫,大家可以理解为在网络上爬行的一直蜘蛛,互联网就比作一张大网,而爬虫便是在这张网上爬来爬去的蜘蛛咯,如果它遇到资源,那么它就会抓取下来.想抓取什么?这个由你来控制它咯. ...
- Python爬虫入门二之爬虫基础了解
1.什么是爬虫 爬虫,即网络爬虫,大家可以理解为在网络上爬行的一直蜘蛛,互联网就比作一张大网,而爬虫便是在这张网上爬来爬去的蜘蛛咯,如果它遇到资源,那么它就会抓取下来.想抓取什么?这个由你来控制它咯. ...
- 转 Python爬虫入门二之爬虫基础了解
静觅 » Python爬虫入门二之爬虫基础了解 2.浏览网页的过程 在用户浏览网页的过程中,我们可能会看到许多好看的图片,比如 http://image.baidu.com/ ,我们会看到几张的图片以 ...
- 爬虫----爬虫解析库Beautifulsoup模块
一:介绍 Beautiful Soup 是一个可以从HTML或XML文件中提取数据的Python库.它能够通过你喜欢的转换器实现惯用的文档导航,查找,修改文档的方式.Beautiful Soup会帮你 ...
- 爬虫利器BeautifulSoup模块使用
一.简介 BeautifulSoup 是一个可以从HTML或XML文件中提取数据的Python库.它能够通过你喜欢的转换器实现惯用的文档导航,查找,修改文档的方式,同时应用场景也是非常丰富,你可以使用 ...
- 转:Scrapy安装、爬虫入门教程、爬虫实例(豆瓣电影爬虫)
Scrapy在window上的安装教程见下面的链接:Scrapy安装教程 上述安装教程已实践,可行.(本来打算在ubuntu上安装Scrapy的,但是Ubuntu 磁盘空间太少了,还没扩展磁盘空间,所 ...
- Scrapy安装、爬虫入门教程、爬虫实例(豆瓣电影爬虫)
Scrapy在window上的安装教程见下面的链接:Scrapy安装教程 上述安装教程已实践,可行.(本来打算在ubuntu上安装Scrapy的,但是Ubuntu 磁盘空间太少了,还没扩展磁盘空间,所 ...
随机推荐
- C语言之算法初步(汉诺塔--递归算法)
个人觉得汉诺塔这个递归算法比电子老鼠的难了一些,不过一旦理解了也还是可以的,其实网上也有很多代码,可以直接参考.记得大一开始时就做过汉诺塔的习题,但是那时代码写得很长很长,也是不理解递归的结果.现在想 ...
- 学号:201521123116 《java程序设计》第三周学习总结
1. 本周学习总结 初学面向对象,会学习到很多碎片化的概念与知识.尝试学会使用思维导图将这些碎片化的概念.知识组织起来.请使用纸笔或者下面的工具画出本周学习到的知识点. 书面作业 Q1:代码阅读 pu ...
- 201521123028 《Java程序设计》第13周学习总结
本周学习总结 书面作业 网络基础 1.1 比较ping www.baidu.com与ping cec.jmu.edu.cn,分析返回结果有何不同?为什么会有这样的不同? Ans:cec.jmu.edu ...
- JDBC中的ResultSet无法多次循环的问题。
前几天碰见了一个很奇葩的问题,使我百思不得其解,今天就写一下我遇见的问题吧,也供大家参考,别和我犯同样的毛病. 首先说下jdbc,jdbc是java是一种用于执行SQL语句的Java API,从jdb ...
- Eclipse 版本选择
查看Eclipse的版本号: 1. 找到eclipse安装目录 2. 进入readme文件夹,打开readme_eclipse.html 3. readme_eclipse.html呈现的第二行即数字 ...
- Angular2 Service实践
引言: 如果说组件系统(Component)是ng2应用的躯体,那把服务(Service)认为是流通于组件之间并为其带来生机的血液再合适不过了.组件间通信的其中一种优等选择就是使用服务,在ng1里就有 ...
- centos 6.5系统下安装ibus及设置开机自启动
先说一下系统环境:centos 6.5,然后我是以root身份执行的,没有权限的用户参见sudo用法 第1步:查找并安装ibus安装包,命令如下: 找到一行: ibus-pinyin.x86_64 : ...
- 微信支付之h5方式(非微信内置浏览器中支付)
这两天完成了公司网站手机和PC端的支付对接,就是支付宝和微信. 对接完后有所感触,我们来聊一聊,微信支付的坑,为什么这么说呢,因为我在对接完支付宝后是很愉快的,基本上在demo上稍加修改就ok了, 对 ...
- 接口测试——HttpClient工具的https请求、代理设置、请求头设置、获取状态码和响应头
目录 https请求 代理设置 请求头设置 获取状态码 接收响应头 https请求 https协议(Secure Hypertext Transfer Protocol) : 安全超文本传输协议, H ...
- JQuery实现banner图滚动
前 言 jQuery是一个功能强大的库,提供了开发JavaScript项目所需的所有核心函数.很多时候我们使用jQuery的原因就是因为其使用插件的功能,然而,有时候我们还是 ...