
【网络爬虫入门03】爬虫解析利器beautifulSoup模块的基本应用
【网络爬虫入门03】爬虫解析利器beautifulSoup模块的基本应用
1、引言
网络爬虫最终的目的就是过滤选取网络信息,因此最重要的就是解析器了,其性能的优劣直接决定这网络爬虫的速度和效率。BeautifulSoup可以通过定位HTML件中的标签来格式化和组织复杂的网络信息,尝试化平淡为神奇,用简单易用的Python对象为我们展现XML的信息结构,它会帮你节省数小时甚至数天的工作时间。
2、什么是BeautifulSoup模块?
BeautifulSoup是一个非常优秀的Python扩展库,它可以从HTML或XML文件中提取我们感兴趣的数据。它不但可以标签进行查找,还可以通过标签属性来查找。 BeautifulSoup除了支持Python标准库中的HTML解析器之外,还支持一些第三方的解析器,可以有针对性地向网页进行解析。 BeautifulSoup官方推荐使用lxml作为解析器,据说因为lxml解析器的效率更高。
学习BeautifulSoup的最完整和最好资料是官方文档,常用的内容熟练掌握,不常用的需要的时候查阅就好。在本文中,只总结爬虫开发中常用知识,更多内容要看官方文档:
http://beautifulsoup.readthedocs.io/zh_CN/latest/#id18
3、对象的种类
BeautifulSoup对象是一个复杂的树形结构,它的每一个节点都是一个Python对象,获取网页内容就是一个提取对象内容的过程,其提取对象的方法可以分为:遍历文档树、搜索文档树、CSS选择器。
所有的对象可以分为4种:
<1> Tag:Tag对象与XML或HTML原生文档中的tag相同。它有很多方法和属性,其中最重要的是:name和attributes。BeautifulSoup对象通过find()和find_all()方法,或者直接调用子标签获取一列对象或单个对象。
<2> NavigableString:用来表示标签里的文字,不是标签。
<3> Comment:这是一个特殊类型的NavigableString对象,用来查找HTML文档中的注释。
<4> BeautifulSoup:这个对象表示文档的全部内容。大部分时候可以把它当作Tag对象,它支持遍历文档树和搜索文档树的大部分方法。
4、官方测试样例
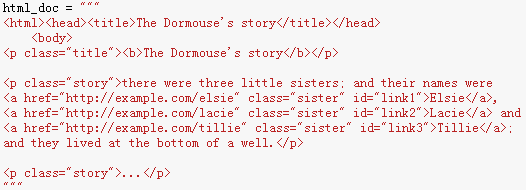
5、遍历文档树
文档树的遍历方法就好像爬树一样,需要首先爬到树干上,然后慢慢爬到小树干,最后到树枝上,就可以得到需要的数据了。
例1:获取文档树中的‘body标签中的‘p’标签中的’‘b’标签。

在遍历文档树中,搞清各个标签之间的关系是非常重要的。子标签就是一个父标签的下一级;而后代标签是指一个父标签下面所有级别的标签。所有子标签都是后代标签,但不是所有的后代标签都是子标签。一般情况下,BeautifulSoup的方法总是处理当前标签的后代标签。
可以通过 .parent 属性来获取某个元素的父节点.
例2:获取文档树中‘p’标签的父标签。
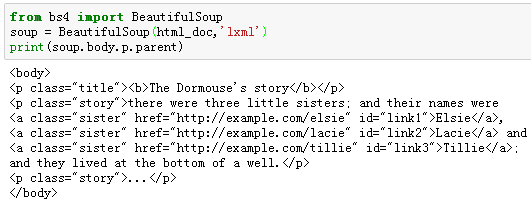
tag的.contents 属性可以将tag的子节点以列表的方式输出;通过tag的.children 生成器,也可以对tag的子节点进行循环。
例3:获取文档树中‘p’标签的子标签。
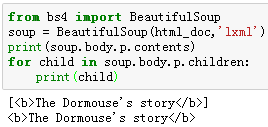
6、搜索文档树
相对于遍历文档树来说,搜索文档树最常用。在搜索文档树时,最常用的是find_all()和find()方法。在这里,主要通过例子讲述find_all()的常见使用,关于find_all()的具体描述参见官方文档。
find_all (name, attrs, recursive, string, limit, keyword)
该方法搜索当前tag的所有tag子节点,并判断是否符合过滤器的条件。
[1] name参数:可以查找所有名字为name的tag,字符串对象会自动忽略掉。该参数的值可以接受:字符串、正则表达式、列表和True。
例4:搜索文档树中的‘title’标签。
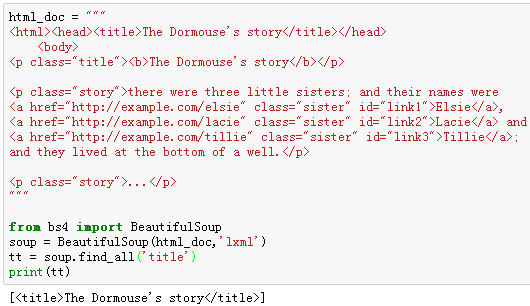
例5:搜索文档树中的‘a’标签,逐条打印出来。

[2] attrs参数:是用一个Python字典封装一个标签的若干属性和对应的属性值。
例6:搜索‘a’标签中,id属性的值为“link2”的标签。
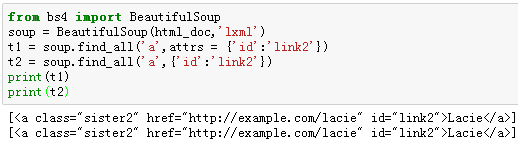
因为表示CSS类名的关键字class在Python中是保留字,所以,在按照CSS类名搜索tag的时候,如果使用class作为参数会导致语法的错误,不过,可以通过class_搜索指定CSS类名的tag,或者通过字典的方式指定参数。
例7:搜索‘a’标签中,class属性的值为“sister1”的标签。

例8:搜索‘a’标签中,class属性的值为“sister1”和属性值为“sister3”的标签。
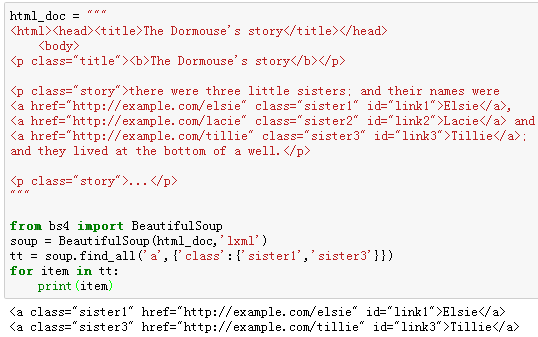
[3] recursive参数:是一个布尔变量。该参数为True,find_all()就会根据你的要求去查找标签参数的所有子标签,以及子标签的子标签。如果该参数为False,find_all()就只查找文档一级标签。该参数默认是True的,一般情况下不需要修改,除非你真正了解自己需要那些信息,而且抓去的速度非常重要,那么你可以设置该参数。
[4] string参数:通过该参数可以搜索文档中的字符串内容,与name参数相似,其可选值一样,接受:字符串、正则表达式、列表和True,例如:
soup.find_all(string = "Elsie")
soup.find_all(string = ["Elsie", "Tillie", "Lacie"])
soup.find_all(string = re.compile("Dormouse"))
该参数还可以与其他参数混合使用来过滤:
soup.find_all("a", string = "Elsie")
例9:搜索文档树中符合列表中参数的字符串内容。

[5] limit参数:find_all()方法返回的是全部的搜索结果,如果我们不需要全部结果,可以使用limit参数来限制返回结果的数量。当搜索到的结果数量达到limit的限制时,就停止搜索返回结果。find()方法实际上等价于find_all()的limit参数为1的情形。
例10:搜索'a'标签并返回一个结果。

[6]keyword参数:如果一个指定名字的参数不是搜索内置的参数名,搜索时会把该参数当作指定名字tag的属性来搜索。
通过标签参数name把标签列表传到find_all()里获取一系列标签,其实就是一个“或”关系的过滤器;而关键字参数keyword可以让你增加一个“与”关系的过滤器来简化工作。
如果传入一个名字为id的参数,BeautifulSoup会搜索每一个tag的id属性,如果传入href参数,则会搜索每一个tag的href属性。在搜索指定名字的属性时,可以使用的参数值包括:字符串、正则表达式、列表和True。
例11:在文档树中查找所有包含id属性的tag,无论id属性的值是什么。

例12:查找id属性值为link2的标签。
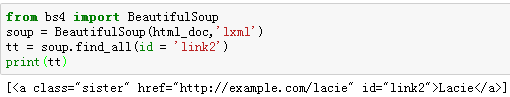
除了上面的基础应用之外,关于find_all()使用可以相当灵活,需要通过在实践中不断的体会和积累,我们在看几个例子:
例13:使用多个指定名字的参数,同时过滤tag的多个属性。
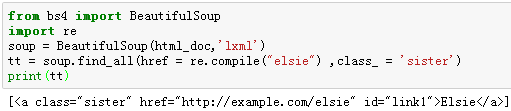
例14:将‘a’标签中的网络链接抓取出来。

例15:将‘a’标签中的网络链接和字符串抓取出来,形成可视数据。
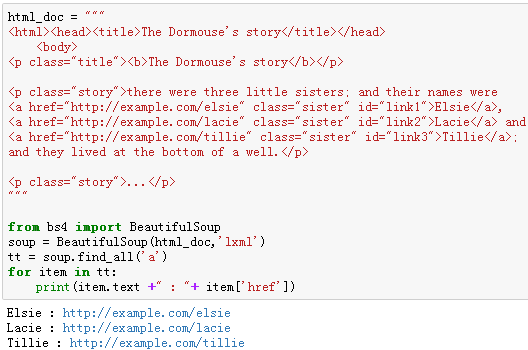
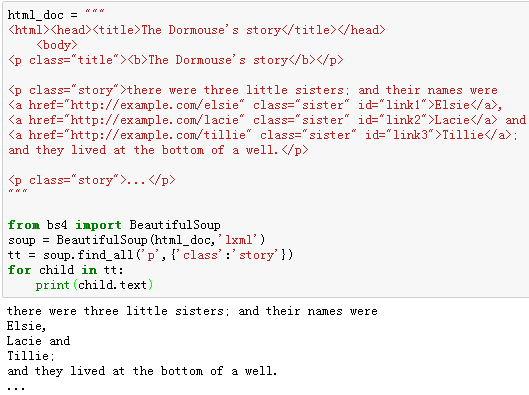
例16:将class属性值为“story”的‘p’标签的全部子标签的文本抓取出来。
7、小结
对爬取网页的解析工作,除了 BeautifulSoup之外,还可以使用re正则表达式、lxml解析器、xpath等等来实现,熟练掌握一个工具,学习其他的会很容易。BeautifulSoup的用法远不止此,但作为网络爬虫的入门应用,上述知识基本足够。如果在学习过程中观看不练,会感觉非常抽象,无法理解;如果只知道敲代码而忽略了为什么,也只能一知半解,难以灵活应用。
【网络爬虫入门03】爬虫解析利器beautifulSoup模块的基本应用的更多相关文章
- 【爬虫入门手记03】爬虫解析利器beautifulSoup模块的基本应用
[爬虫入门手记03]爬虫解析利器beautifulSoup模块的基本应用 1.引言 网络爬虫最终的目的就是过滤选取网络信息,因此最重要的就是解析器了,其性能的优劣直接决定这网络爬虫的速度和效率.Bea ...
- 【网络爬虫入门04】彻底掌握BeautifulSoup的CSS选择器
[网络爬虫入门04]彻底掌握BeautifulSoup的CSS选择器 广东职业技术学院 欧浩源 2017-10-21 1.引言 目前,除了官方文档之外,市面上及网络详细介绍BeautifulSoup ...
- 爬虫----爬虫解析库Beautifulsoup模块
一:介绍 Beautiful Soup 是一个可以从HTML或XML文件中提取数据的Python库.它能够通过你喜欢的转换器实现惯用的文档导航,查找,修改文档的方式.Beautiful Soup会帮你 ...
- 爬虫利器BeautifulSoup模块使用
一.简介 BeautifulSoup 是一个可以从HTML或XML文件中提取数据的Python库.它能够通过你喜欢的转换器实现惯用的文档导航,查找,修改文档的方式,同时应用场景也是非常丰富,你可以使用 ...
- Python爬虫入门:爬虫基础了解
有粉丝私信我想让我出更基础一些的,我就把之前平台的copy下来了,可以粗略看一下,之后都会慢慢出. 1.什么是爬虫 爬虫,即网络爬虫,大家可以理解为在网络上爬行的一直蜘蛛,互联网就比作一张大网,而爬虫 ...
- python爬虫-入门-了解爬虫
作为一个爬虫新手,我觉得首先要了解爬虫是的作用以及应用. 作用:通过爬虫获取网页内的信息.包括:标题(title)图片(image)链接(url)等等 应用:抽取所需信息,进行数据汇总及分析(从事网页 ...
- 解析库-beautifulsoup模块
# -*- coding: utf-8 -*- from bs4 import BeautifulSoup # 安装:pip install beautifulsoup4 # Beautiful So ...
- 【网络爬虫入门01】应用Requests和BeautifulSoup联手打造的第一条网络爬虫
[网络爬虫入门01]应用Requests和BeautifulSoup联手打造的第一条网络爬虫 广东职业技术学院 欧浩源 2017-10-14 1.引言 在数据量爆发式增长的大数据时代,网络与用户的沟 ...
- Python爬虫从入门到进阶(1)之Python概述及爬虫入门
一.Python 概述 1.计算机语言概述 (1).语言:交流的工具,沟通的媒介 (2).计算机语言:人跟计算机交流的工具 (3).Python是计算机语言的一种 2.Python编程语言 代码:人类 ...
随机推荐
- 洛谷P4169 天使玩偶 CDQ分治
还是照着CDQ的思路来. 但是有一些改动: 要求4个方向的,但是可爱的CDQ分治只能求在自己一个角落方向上的.怎么办?旋转!做4次就好了. 统计的不是和,而是——max!理由如下: 设当前点是(x,y ...
- centos7安装saltstack
环境是Cenos7 saltstack-master:192.168.0.140 saltstack-minion:192.168.0.141 安装epel yum源 yum -y install e ...
- 回调函数: 一定要在函数名前加上 CALLBACK,否则有可能引起内存崩溃!
今天又遇到一个莫名其妙的内存崩溃问题,问题代码 EnumChildWindows(...): EnumChildWindows(hwnd_panel_text_watermark, (WNDENUMP ...
- celery分布式异步框架
1.什么是Celery Celery是一个简单.灵活且可靠的,处理大量消息的分布式系统 专注于实时处理的异步任务队列 同时也支持任务调度 Celery架构 Celery的架构由三部分组成,消息中间件( ...
- Day7--Python--基础数据类型补充,集合,深浅拷贝
一.基础数据类型补充 1.join() 把列表中的每一项(必须是字符串)用字符串拼接 与split()相反 lst = ["汪峰", "吴君如", " ...
- RPC简介
一:为什么会出现RPC呢? 当公司业务量还是很小的时候,所有的程序都放置在一台机器上,程序之间通过函数或者类来调用.1:当公司的业务发展越来越大,业务线越来越多,公司后端人员也越来越多,分布在不同的业 ...
- ps -ef | grep Linux进程查看命令
我们常常会想查看Linux的一些进程,很自然地用到了: ps -ef | grep xxx ps: process show 展示进程 参数:1. e 显示所有程序. 2. f 显示UID,PPIP ...
- 2017-12-14python全栈9期第一天第一节之太白自我介绍和内容大纲
1.计算机基础 2.python历史 3.python的环境 4.Python的发展 5.python的种类 6.变量 7.常量 8.注释 9.用户交互 10.基础类型初始 11.if 12.whil ...
- 剑指Offer_编程题_5
题目描述 用两个栈来实现一个队列,完成队列的Push和Pop操作. 队列中的元素为int类型. class Solution { public: void push(int node) { if( ...
- fuel6.0安装部署
在经过一系列安装openstack方式后,个人觉得fuel的安装方式相对简易,接下来记录下安装部署fuel6.0的过程.本教程适合想把fuel6.0部署后,云主机需要连接外网的需求. 安装virtua ...