
CDH hadoop的安装
1
先拷贝tar包到目录底下(tar 包解压 tar zxvf)
2 :
1、使用课程提供的hadoop-2.5.0-cdh5.3.6.tar.gz,上传到虚拟机的/usr/local目录下。(http://archive.cloudera.com/cdh5/cdh/5/)
2、将hadoop包进行解压缩:tar -zxvf hadoop-2.5.0-cdh5.3.6.tar.gz
3、对hadoop目录进行重命名:mv hadoop-2.5.0-cdh5.3.6 hadoop
4、配置hadoop相关环境变量
vi ~/.bashrc
export HADOOP_HOME=/usr/local/hadoop
export PATH=$HADOOP_HOME/bin:$HADOOP_HOME/sbin
source ~/.bashrc
5、创建/usr/local/data目录(用来存放data目录)
3:配置core-site
(dir/hadoop/etc/hadoop/)
<property>
<name>fs.default.name</name>
<value>hdfs://sparkproject1:9000</value>
</property>
4:配置hdfs-site.xml
<property>
<name>dfs.name.dir</name>
<value>/usr/local/data/namenode</value>
</property>
<property>
<name>dfs.data.dir</name>
<value>/usr/local/data/datanode</value>
</property>
<property>
<name>dfs.tmp.dir</name>
<value>/usr/local/data/tmp</value>
</property>
<property>
<name>dfs.replication</name>
<value>2</value>
</property>
4.配置map-site.xml(mapreduce配置)
<property>
<name>mapreduce.framework.name</name>
<value>yarn</value>
</property>
5.修改yarn-site.xml
<property>
<name>yarn.resourcemanager.hostname</name>
<value>sparkproject1</value>
</property>
<property>
<name>yarn.nodemanager.aux-services</name>
<value>mapreduce_shuffle</value>
</property>
6:scp -r hadoop root@sparkproject2:/usr/local/soft
用scp命令把hadoop文件scp到别的机器上
7:把bashrc也拷贝到别的机器上
scp ~/.bashrc root@sparkproject2:~/
(同理拷贝到别的机器上)
8:hdfs格式化
1、格式化namenode:在sparkproject1上执行以下命令,hdfs namenode -format
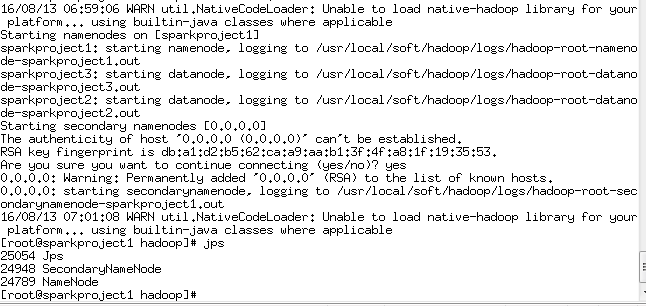
9:start-dfs.sh (yes)
CDH hadoop的安装的更多相关文章
- 使用yum安装CDH Hadoop集群
使用yum安装CDH Hadoop集群 2013.04.06 Update: 2014.07.21 添加 lzo 的安装 2014.05.20 修改cdh4为cdh5进行安装. 2014.10.22 ...
- Hadoop Linux安装
Hadoop Linux安装 步骤流程 1.硬件准备 2.软件准备(推荐CDH) 3.将Hadoop安装包分发到各个节点下 4.安装JDK 5.修改/etc/hosts配置文件 6.设置SSH免密码登 ...
- CDH集群安装&测试总结
0.绪论 之前完全没有接触过大数据相关的东西,都是书上啊,媒体上各种吹嘘啊,我对大数据,集群啊,分布式计算等等概念真是高山仰止,充满了仰望之情,觉得这些东西是这样的: 当我搭建的过程中,发现这些东西是 ...
- 【从零开始学习Hadoop】--1.Hadoop的安装
第1章 Hadoop的安装1. 操作系统2. Hadoop的版本3. 下载Hadoop4. 安装Java JDK5. 安装hadoop6. 安装rsync和ssh7. 启动hadoop8. 测试had ...
- hadoop环境安装及简单Map-Reduce示例
说明:这篇博客来自我的csdn博客,http://blog.csdn.net/lxxgreat/article/details/7753511 一.参考书:<hadoop权威指南--第二版(中文 ...
- hadoop群集安装中碰到的问题
在hadoop群集安装结束后,进行格式测试出现问题如下 格式化 cd /data/hadoop/bin ./hdfs namenode -format 15/01/21 05:21:17 WARN f ...
- 从零开始学习Hadoop--第1章 Hadoop的安装
Hadoop的安装比较繁琐,有如下几个原因:其一,Hadoop有非常多的版本:其二,官方文档不尽详细,有时候更新脱节,Hadoop发展的太快了:其三,网上流传的各种文档,或者是根据某些需求定制,或者加 ...
- Hadoop学习---安装部署
hadoop框架 Hadoop使用主/从(Master/Slave)架构,主要角色有NameNode,DataNode,secondary NameNode,JobTracker,TaskTracke ...
- hadoop分布式安装教程(转)
from:http://www.cnblogs.com/xia520pi/archive/2012/05/16/2503949.html 1.集群部署介绍 1.1 Hadoop简介 Hadoop是Ap ...
随机推荐
- Hibernate中的一对一映射
1.需求 用户和身份证是一一对应的关系. 有两种对应方式: 用户id作为身份证表的外键,身份证号作为主键: 用户id作为身份证表的主键: 2.实体Bean设计 User: public class U ...
- JAVA工作方式
public class Hellow { int eyes = 2; int ears = 2; int legs = 4; void run(){ //方法 System.out.println( ...
- 上架app 到app store 的出现: “The IPA is invalid. It does not inlude a Payload directory.”错误处理
今天打包上传app到app store上遇到的一个错误,在xcode6.2下提示: The IPA is invalid. It does not inlude a Payload director ...
- (转)SQLLite数据操作
原文:http://dreamboy.blog.51cto.com/3180937/722352 SQLLite数据操作 一般数据采用的固定的静态数据类型,而SQLite采用的是动态数据类型,会根据存 ...
- leetcode 239 Sliding Window Maximum
这题是典型的堆排序算法,只是比一般的堆算法多了删除的操作,有两件事需要做: 1 用一个hash表存储从输入数组索引到堆数组(用于实现堆的那个数组)所以的映射,以便在需要删除一个元素的时候能迅速定位到堆 ...
- Ubuntu下安装Apache mysql php的命令
sudo apt-get install apache2 php5-mysql libapache2-mod-php5 mysql-serversudo apt-get install php5-gd ...
- 转:Spring中@Autowired注解、@Resource注解的区别
Pay attention: When using these annotations, the object itself has to be created by Spring context. ...
- 数位dp-POJ-3252-Round Numbers
最近一直在看书和博客,即使做出几道题来也是看别人题解写的,感觉没自己的东西,所以很久没更新博客 看了很多数位dp的题和题解,发现数位dp题是有固定的模版的,并且终于自己做出来一道. 我觉得用记忆化搜索 ...
- 【LEETCODE OJ】Binary Tree Preorder Traversal
Problem Link: http://oj.leetcode.com/problems/binary-tree-preorder-traversal/ Even iterative solutio ...
- mac下U盘装机系统的制作(命令行)
1,不插入U盘和插入U盘分别命令检测硬盘,确定要制作的U盘号:diskutil list 2,卸载usb盘,不推出,diskutil umountDisk /dev/disk1 3,将dmg写入U盘, ...