
一次使用scrapy的问题记录
前景描述:
需要获取某APP的全国订单量,及抢单量。由于没有全国的选项所以只能分别对每一个城市进行订单的遍历。爬虫每天运行一次,一次获取48小时内的订单,从数据库中取出昨天的数据进行对比,有订单被抢则更新,无则不操作。(更新逻辑在这里不重要,重要的是爬取逻辑)。每个订单有发布时间,根据发布时间判断,在48小时外的就停止爬取,开始爬取下一个城市。
先看第一版:
#spider

# 构造一些请求参数,此处省略

# 从配置中读取所有城市列表

cities = self.settings['CITY_CH']

# end_signal为某个城市爬取完毕的信号,

self.end_signal = False

for city in cities:

    # 通过for循环对每个城市进行订单爬取

    post_data.update({'locationName':city})

    count = 1

    while not self.end_signas:

        post_data.update({'pageNum':str(count)})

        data = ''.join(json.dumps(post_data, ensure_ascii=False).split())

        sign = MD5Util.hex_digest(api_key + data + salt).upper()

        params = {

            'apiKey':api_key,

            'data':data,

            'system':system,

            'sign':sign

        }

        meta = {'page':count}

        yield scrapy.Request(url=url, method='POST', body=json.dumps(params, ensure_ascii=False),

                             headers=self.headers, callback=self.parse,meta=meta, dont_filter=True)

        count+=1

    self.end_signal = False

def parse(self,response):

    # 略
# 在spiderMiddleware中根据返回的item中的订单时间进行判断(此处不详写)

def process_spider_output(self, response, result, spider):

    result_bkp = []

    for res in result:

        if res['order_time'] < before_date(2): #before_date为自定义的时间函数

            logger.info("{%s}爬取完毕,开始爬取下一个城市" % (res['city_name']))

            spider.end_signal = True

            break

        result_bkp.append(res.copy())

    return result_bkp
乍一看没有问题,遍历每个城市,再到解析 解析完后返回item到spiderMiddleware中进行判断订单是否超过48小时,超过就设置
self.end_signal为True跳出spider中的while循环,注意while循环后面又将这个参数设置False然后下个城市的循环就开始了。
问题来了:
spider中将request返回出去添加到队列中,这里有一个队列,当response下载好返回回来通过parse函数去处理的时候也有一个队列,众所周知运气不好的人总会偶尔遇到一点网络问题,来举个栗子就清楚了
栗子:spider中将城市A的1、2、3订单页(2、3为超过48小时的订单页),添加到队列中,下载器去下载的时候可能第2页代理挂了,第三页超过48小时,中间件判断成功设置self.end_signal=True进行下一个城市的爬取。城市B添加了1、2、3(都在48小时内),这个时候城市A的第二页订单下载完成了在中间件中判断又将self.end_signal=True,于是城市B后面的订单也就都没了,都没了。。。,直接开始了下一个城市的订单!
一版总结:
不要在一个异步的程序中通过一个全局变量去控制整个程序的流程。(总结的不好,可以帮我总结一下)
第二版:
既然不能通过全局变量来控制,那能不能让每个城市带一个标识来指明订单爬取结束。
先看代码
#spider

cities = self.settings['CITY_CH']

# end_signal为某个城市爬取完毕的信号,

self.end_signal = False

for city in cities:

    # 通过for循环对每个城市进行订单爬取

    post_data.update({'locationName':city})

    count = 1

    print(cities)

    print(city)

    while in cities:

        post_data.update({'pageNum':str(count)})

        data = ''.join(json.dumps(post_data, ensure_ascii=False).split())

        sign = MD5Util.hex_digest(api_key + data + salt).upper()

        params = {

            'apiKey':api_key,

            'data':data,

            'system':system,

            'sign':sign

        }

        meta = {'page':count}

        yield scrapy.Request(url=url, method='POST', body=json.dumps(params, ensure_ascii=False),

                             headers=self.headers, callback=self.parse,meta=meta, dont_filter=True)

        count+=1

    self.end_signal = False

def parse(self,response):

    # 略
# 在spiderMiddleware中根据返回的item中的订单时间进行判断(此处不详写)

def process_spider_output(self, response, result, spider):

    result_bkp = []

    for res in result:

        if res['order_time'] < before_date(2): #before_date为自定义的时间函数

            if res['city_name'] in spider.cities:

                spider.cities.remove(res['city_name'])

                logger.info("{%s}爬取完毕,开始爬取下一个城市" % (res['city_name']))

            break

        result_bkp.append(res.copy())

    return result_bkp
看逻辑也有点意思,判断这个城市是否在列表中,在的话说明还没爬取完毕,爬取完毕了就删除这个城市。嗯!运行一下!
有意思的来了,第一个城市爬取正常,第二个城市不见了,上诉代码中打印的城市没有显示第二个城市,直接跳到了最后一个(设就三个城市) 怎么被吞了呢。
敏感数据就不截图了。
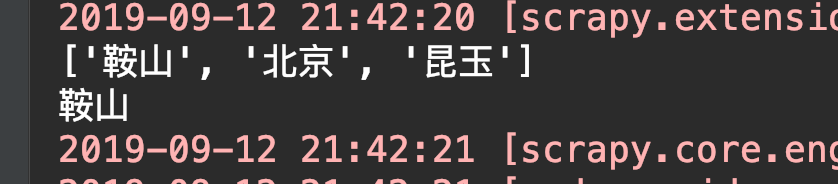
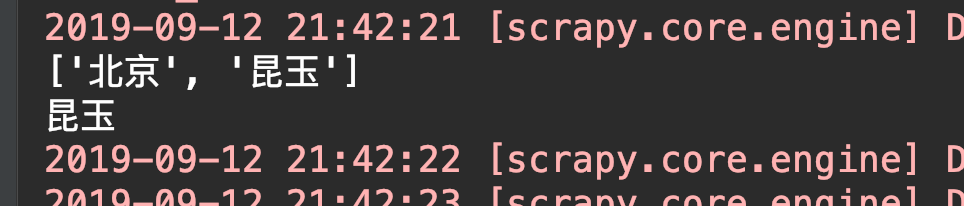
可以看到 打印的城市列表中明明还有北京的没有被删除,为啥直接到最后一个城市了呢?
可能有大佬已经看出来了,我是生生打断点调试了半天,甚至怀疑是for循环内部有什么bug。
最后灵机一动(滑稽),难倒是因为城市列表的问题?我for循环它,然后又在他内部去删除它里面的元素,可以这样吗?
写个demo测试一下
cities = ['鞍山', '北京', '昆玉',]

for city in cities:

    cities.remove('鞍山')

    print(city)
# 错误就来了! 果然不能在循环它的时候再对它进行删除操作

ValueError: list.remove(x): x not in list
至于在运行scrapy的时候为什么没有报这个错误,可能是在别的地方做了异常处理,但是有这个问题在,我们先去修复它一下。
将for city in cities改为for city in cities.copy(),完美解决!!!
还有一个小点就是python的值传递和地址传递,在处理item的时候要注意。
一次使用scrapy的问题记录的更多相关文章
- python scrapy简单爬虫记录(实现简单爬取知乎)
之前写了个scrapy的学习记录,只是简单的介绍了下scrapy的一些内容,并没有实际的例子,现在开始记录例子 使用的环境是python2.7, scrapy1.2.0 首先创建项目 在要建立项目的目 ...
- Scrapy使用详细记录
这几天,又用到了scrapy框架写爬虫,感觉忘得差不多了,虽然保存了书签,但有些东西,还是多写写才好啊 首先,官方而经典的的开发手册那是需要的: https://doc.scrapy.org/en/l ...
- Python Scrapy安装杂症记录
昨天安装了scrapy一切正常,调试了bbsSpider案例(详见上文),今日开机因为冰封还原,提示找不到python27.dll,重新安装了python2.7, 使用easy-install scr ...
- scrapy安装问题记录
ubuntu小白一枚,由于对于ubuntu的不了解所以导致有的问题解决不了只能白痴的重装一遍. 总结一下问题: 1.pip安装自带scrapy版本过低官方不提供维护,卸载不完全导致重装最新版不成功 # ...
- scrapy笔记集合
细读http://scrapy-chs.readthedocs.io/zh_CN/latest/index.html 目录 Scrapy介绍 安装 基本命令 项目结构以及爬虫应用介绍 简单使用示例 选 ...
- Scrapy笔记:日志的使用
scrapy的日志记录有两种方式: spider.logger.xx()和python标准库中的logger = logging.get_Logger('log information') 向日志对象 ...
- windows下搭建scrapywindows 7 (64) + python 3.5 (64)
说明 之前在 window 10 (64) + python 3.5 (64) 环境下就已经成功安装了 scrapy,当然也费了不少周折. 由于近日将系统换回 windows 7 (64),再安装 s ...
- 爬虫:Scrapy11 - Logging
Scrapy 提供了 log 功能.可以通过 scrapy.log 模块使用.当前底层实现使用了 Twisted logging,不过可能在之后会有所变化. log 服务必须通过显式调用 scrapy ...
- scrapy学习记录
scrapy是一个用来爬取一个或多个网站的数据,提取数据的应用框架.下载过程非常复杂,而且会遇到各种问题.所以写个博客来记录下. 安装好python2.7之后,就可以开始.安装scrapy前还需要安装 ...
随机推荐
- macos Mojave 出现网络出错 Frame Check Sequence: Bad checksum
问题描述:使用软电话外呼的时候出现Request Timeout . 端口监听之后通过 Wireshark发现错误:`Frame Check Sequence: Bad checksum`,查看wir ...
- hadoop学习(二)----HDFS简介及原理
前面简单介绍了hadoop生态圈,大致了解hadoop是什么.能做什么.带着这些目的我们深入的去学习他.今天一起看一下hadoop的基石--文件存储.因为hadoop是运行与集群之上,处于分布式环境之 ...
- golang 结合实例更好的理解参数传递和指针
关于参数传递 其实go的参数传递,核心就是一句话:go里所有参数传递都是值传递,既把参数复制一份放到函数里去用. go的函数传参,不管参数是什么类型,都会复制一份,然后新的参数在函数内部被使用. 不像 ...
- 还在为垂直居中苦恼?CSS 布局利器 flexbox 轻轻松松帮你搞定
传统的 CSS 布局方式是基于盒模型(它是根据盒子与父盒子以及兄弟盒子的关系确定大小和位置的算法),实现时依赖于 block, inline, table, position, float 这些属性, ...
- JS DOM(文档对象模型)与BOM(浏览器对象模型)
在JS中,对DOM(Document Object Model)对象和BOM(Browser Object Model )对象的操作是非常重要的内容.DOM主要包括HTML文档的属性和方法,像对HTM ...
- Ubuntu 16.04 安装 SVN-Client (RaabitVCS)
1.添加源 sudo add-apt-repository ppa:rabbitvcs/ppa 2. 更新源 sudo apt-get update 3.安装依赖库 sudo apt-get inst ...
- 史上最全面 Android逆向培训之__Xposed使用
刚招来个Android,干了半个月辞职了,他走之后,成堆的bug被测了出来,都是这个新人代码都没看懂就开始改的一塌糊涂,还给提交了.实在是让人头疼,清理了一个月多月才把他半个月写的bug清理个差不多. ...
- idea 2019安装完(打不开&&启动不了)问题解决(最全解决方法)
今天从网盘把idea下载下来后一路安装,准备 设置的时候不管怎么打开 他都无动于衷没办法,卸了安,安了卸,反复折腾了 好几遍 它都无动于衷.于是开始在百度上找答案看了 好几个 方法一遍一遍试还是不行, ...
- windows下搭建syslog服务器及基本配置
一.环境 windows7 64位+ kiwi_syslog_server_9.5.0 kiwi_syslog百度云下载地址: 链接: https://pan.baidu.com/s/1EpPBNsL ...
- Day 05--最终修改(一)
1.今天大家集中交流了自己的的课程设计雏形,我们感到收获颇丰.在感慨别的同学设计的别出心裁的同时,我们也反思了自己的模型.通过与老师的讨论我们决定修改已有的首页格式,以及丰富用户的身份:即小程序不仅面 ...