
word2vec改进之Negative Sampling
训练网络时往往会对全部的神经元参数进行微调,从而让训练结果更加准确。但在这个网络中,训练参数很多,每次微调上百万的数据是很浪费计算资源的。那么Negative Sampling方法可以通过每次调整很小的一部分权重参数,从而代替全部参数微调的庞大计算量。
词典D中的词在语料C中出现的次数有高有低,对于那些高频词,我们希望它被选为负样本的概率比较大,对于那些低频词,我们希望它被选中的概率比较小,这是我们对于负采样过程的一个大致要求,本质上可以认为是一个带权采样的问题。
一、基于Negative Sampling的CBOW模型
输入:基于CBOW的语料训练样本,词向量的维度大小Mcount,CBOW的上下文大小2c,步长η, 负采样的个数neg
输出:词汇表每个词对应的模型参数θ,所有的词向量xw
1. 随机初始化所有的模型参数θ,所有的词向量w
2. 对于每个训练样本(context(w0),w0),负采样出neg个负例中心词wi,i=1,2,...neg
3. 进行梯度上升迭代过程,对于训练集中的每一个样本(context(w0),w0,w1,...wneg)做如下处理:
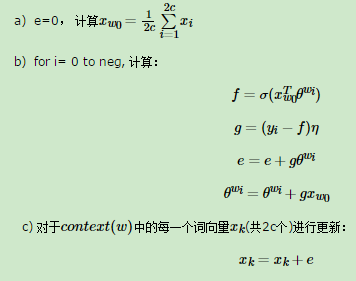
d) 如果梯度收敛,则结束梯度迭代,否则回到步骤3继续迭代。
二、基于Negative Sampling的Skip-Gram模型
输入:基于Skip-Gram的语料训练样本,词向量的维度大小Mcount,Skip-Gram的上下文大小2c,步长η, , 负采样的个数neg。
输出:词汇表每个词对应的模型参数θ,所有的词向量xw
1. 随机初始化所有的模型参数θ,所有的词向量w
2. 对于每个训练样本(context(w0),w0),负采样出neg个负例中心词wi,i=1,2,...neg
3. 进行梯度上升迭代过程,对于训练集中的每一个样本(context(w0),w0,w1,...wneg)做如下处理:
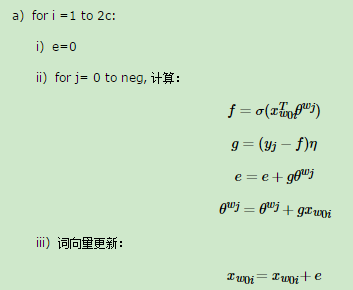
b)如果梯度收敛,则结束梯度迭代,算法结束,否则回到步骤a继续迭代。
参考内容:
https://www.cnblogs.com/pinard/p/7249903.html
word2vec改进之Negative Sampling的更多相关文章
- word2vec原理(三) 基于Negative Sampling的模型
word2vec原理(一) CBOW与Skip-Gram模型基础 word2vec原理(二) 基于Hierarchical Softmax的模型 word2vec原理(三) 基于Negative Sa ...
- word2vec 中的数学原理具体解释(五)基于 Negative Sampling 的模型
word2vec 是 Google 于 2013 年开源推出的一个用于获取 word vector 的工具包,它简单.高效,因此引起了非常多人的关注. 因为 word2vec 的作者 Tomas ...
- DL4NLP——词表示模型(三)word2vec(CBOW/Skip-gram)的加速:Hierarchical Softmax与Negative Sampling
上篇博文提到,原始的CBOW / Skip-gram模型虽然去掉了NPLM中的隐藏层从而减少了耗时,但由于输出层仍然是softmax(),所以实际上依然“impractical”.所以接下来就介绍一下 ...
- 词表征 2:word2vec、CBoW、Skip-Gram、Negative Sampling、Hierarchical Softmax
原文地址:https://www.jianshu.com/p/5a896955abf0 2)基于迭代的方法直接学 相较于基于SVD的方法直接捕获所有共现值的做法,基于迭代的方法一次只捕获一个窗口内的词 ...
- Notes on Noise Contrastive Estimation and Negative Sampling
Notes on Noise Contrastive Estimation and Negative Sampling ## 生成负样本 在常见的关系抽取应用中,我们经常需要生成负样本来训练一个好的系 ...
- 论文解读(SelfGNN)《Self-supervised Graph Neural Networks without explicit negative sampling》
论文信息 论文标题:Self-supervised Graph Neural Networks without explicit negative sampling论文作者:Zekarias T. K ...
- [DeeplearningAI笔记]序列模型2.7负采样Negative sampling
5.2自然语言处理 觉得有用的话,欢迎一起讨论相互学习~Follow Me 2.7 负采样 Negative sampling Mikolov T, Sutskever I, Chen K, et a ...
- word2vec改进之Hierarchical Softmax
首先Hierarchical Softmax是word2vec的一种改进方式,因为传统的word2vec需要巨大的计算量,所以该方法主要有两个改进点: 1. 对于从输入层到隐藏层的映射,没有采取神经网 ...
- 【计算语言学实验】基于 Skip-Gram with Negative Sampling (SGNS) 的汉语词向量学习和评估
一.概述 训练语料来源:维基媒体 https://dumps.wikimedia.org/backup-index.html 汉语数据 用word2vec训练词向量,并用所学得的词向量,计算 pku_ ...
随机推荐
- Java HotSpot(TM) 64-Bit Server VM warning: Insufficient space for shared memory file...
Java HotSpot(TM) 64-Bit Server VM warning: Insufficient space for shared memory file: 把tomcat中的日志删除, ...
- SAP建数据库索引
[转]SAP建数据库索引 %_hints db6 'INDEX("MKPF","MKPF~BUD")' db6 'INDEX(&quo ...
- Mac终端基本指令,一些实用命令的收集.
基本命令1.列出文件ls 参数 目录名 例: 看看驱动目录下有什么:ls /System/Library/Extensions参数 -w 显示中文,-l 详细信息, -a 包括隐藏文件 ...
- [usaco2008feb_gold]路面修整
FJ打算好好修一下农场中某条凹凸不平的土路.按奶牛们的要求,修好后的路面高度应当单调上升或单调下降,也就是说,高度上升与高度下降的路段不能同时出现在修好的路中. 整条路被分成了N段,N个整数A_1 ...
- [noi2002]荒岛野人 拓展欧几里得
克里特岛以野人群居而著称.岛上有排列成环行的M个山洞.这些山洞顺时针编号为1,2,…,M.岛上住着N个野人,一开始依次住在山洞C1,C2,…,CN中,以后每年,第i个野人会沿顺时针向前走Pi个洞住下来 ...
- hdu 1004 Let the Balloon Rise 解题报告
题目链接:http://acm.hdu.edu.cn/showproblem.php?pid=1004 用STL 中的 Map 写的 #include <iostream> #includ ...
- wiki中文语料+word2vec (python3.5 windows win7)
环境: win7+python3.5 1. 下载wiki中文分词语料 使用迅雷下载会快不少,大小为1个多G https://dumps.wikimedia.org/zhwiki/late ...
- some characters cannot be mapped using iso-8859-1 character encoding
Eclipse中新建一个.properties文件,如果输入中文保存时就会提示错误 Reason:some characters cannot be mapped using "ISO-88 ...
- JUC类图
JUC的类图总览.
- bzoj 4260 Codechef REBXOR——trie树
题目:https://www.lydsy.com/JudgeOnline/problem.php?id=4260 一段的异或和就是两个前缀的异或和.正反扫两边,用trie树算每个位置为左/右端点时最大 ...