
Spark集群搭建_Standalone
2017年3月1日, 星期三
Spark集群搭建_Standalone
1.下载安装
下载地址:http://spark.apache.org/downloads.html
Standalone模式的spark集群虽然不依赖于yarn,但是数据文件存在hdfs,所以需要hdfs集群启动成功
这里下载包也要根据hadoop集群版本启动
比如hadoop2.5.2需要下载spark-1.4.0-bin-hadoop2.4.tgz

下载解压进入解压缩目录
2.配置启动
2.1.上传Spark.jar,解压,修改配置文件(改名,配置)

配置spark-env.shexport SPARK_MASTER_IP=masterexport SPARK_MASTER_PORT=7077export SPARK_WORKER_CORES=1export SPARK_WORKER_INSTANCES=1export SPARK_WORKER_MEMORY=1G

2.2配置环境变量


2.3启动Spark集群


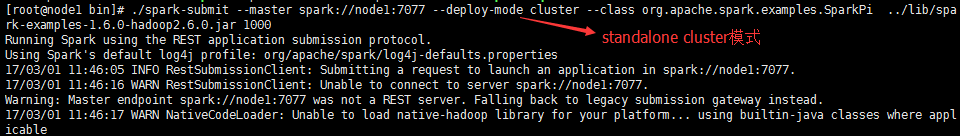
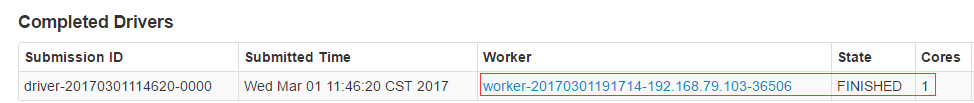


访问node1:8080能看到Spark web界面

附录
不同运行模式的命令不同1.standalone client模式./bin/spark-submit --class org.apache.spark.examples.SparkPi--master spark://master:7077 --executor-memory 512m --total-executor-cores 1 ./lib/spark-examples-1.5.2-hadoop2.4.0.jar 1002.standalone cluster模式./bin/spark-submit --class org.apache.spark.examples.SparkPi--master spark://spark001:7077 --driver-memory 512m --deploy-mode cluster --supervise --executor-memory 512M --total-executor-cores 1 ./lib/spark-examples-1.5.2-hadoop2.4.0.jar 1003.on yarn client模式./bin/spark-submit --class org.apache.spark.examples.SparkPi--master yarn-client --executor-memory 512M--num-executors 1./lib/spark-examples-1.5.2-hadoop2.4.0.jar 1004.on yarn cluster模式./bin/spark-submit --class org.apache.spark.examples.SparkPi--master yarn-cluster --executor-memory 512m--num-executors 1./lib/spark-examples-1.5.2-hadoop2.4.0.jar 100SparkSQL与Hive整合1、只需要在master节点的conf里面创建一个hive-site.xml 然后里面的配置是:<configuration><property><name>hive.metastore.uris</name><value>thrift://hadoop1:9083</value><description>Thrift uri for the remote metastore.Used by metastore client to connect to remote metastore.</description></property></configuration>2、启动hive的metastore服务
附件列表
Spark集群搭建_Standalone的更多相关文章
- Spark集群搭建_YARN
2017年3月1日, 星期三 Spark集群搭建_YARN 前提:参考Spark集群搭建_Standalone 1.修改spark中conf中的spark-env.sh 2.Spark on ...
- (四)Spark集群搭建-Java&Python版Spark
Spark集群搭建 视频教程 1.优酷 2.YouTube 安装scala环境 下载地址http://www.scala-lang.org/download/ 上传scala-2.10.5.tgz到m ...
- Spark集群搭建简要
Spark集群搭建 1 Spark编译 1.1 下载源代码 git clone git://github.com/apache/spark.git -b branch-1.6 1.2 修改pom文件 ...
- Spark集群搭建简配+它到底有多快?【单挑纯C/CPP/HADOOP】
最近耳闻Spark风生水起,这两天利用休息时间研究了一下,果然还是给人不少惊喜.可惜,笔者不善JAVA,只有PYTHON和SCALA接口.花了不少时间从零开始认识PYTHON和SCALA,不少时间答了 ...
- Spark集群搭建中的问题
参照<Spark实战高手之路>学习的,书籍电子版在51CTO网站 资料链接 Hadoop下载[链接](http://archive.apache.org/dist/hadoop/core/ ...
- spark集群搭建
文中的所有操作都是在之前的文章scala的安装及使用文章基础上建立的,重复操作已经简写: 配置中使用了master01.slave01.slave02.slave03: 一.虚拟机中操作(启动网卡)s ...
- Spark 集群搭建
0. 说明 Spark 集群搭建 [集群规划] 服务器主机名 ip 节点配置 s101 192.168.23.101 Master s102 192.168.23.102 Worker s103 19 ...
- hadoop+spark集群搭建入门
忽略元数据末尾 回到原数据开始处 Hadoop+spark集群搭建 说明: 本文档主要讲述hadoop+spark的集群搭建,linux环境是centos,本文档集群搭建使用两个节点作为集群环境:一个 ...
- Spark集群搭建(local、standalone、yarn)
Spark集群搭建 local本地模式 下载安装包解压即可使用,测试(2.2版本)./bin/spark-submit --class org.apache.spark.examples.SparkP ...
随机推荐
- //@sourceURL=filename.js
在 console 中输入代码的最后一行加上 //@ sourceURL=filename.js, 会在 Scripts 面板中有个叫 filename.js 的文件, 然后他就和外部 js 文件一样 ...
- iOS 准备
iOS 编程知识点 iOS 基础知识点 iOS 之 系统机制 Xcode 使用技巧 Mac 使用技巧 iOS 之 英语 iOS 之 编外知识点 iOS 知识库链接
- Struts1、WebWork、Struts2介绍
一.Struts1 1.Struts1原理简介 Struts1框架以ActionServlet作为控制器核心,整个应用由客户端请求驱动.当客户端向Web应用发送请求时,请求被Struts1的核心控制器 ...
- JS base64 加密和解密
/*** * 加密 base64encode(utf16to8(str)) * 解密 utf8to16(base64decode(str)) * * */ var base64EncodeChars ...
- Java线程:线程中断
interrupt方法可以用来请求终止线程. 当对一个线程调用interrupt方法时,线程的中断状态被置位.这时每个线程都有boolean标志.每个线程都应该不时的检查这个标志,以判断线程是否被中断 ...
- Markdown使用教程
Markdown 是一种 轻量级标记语言,主要特点是:使用易读易写的纯文本格式编写文档,然后转换成有效的XHTML(或者HTML)文档". 本文参考了:语法手册.简书介绍. 常用语法 一.标 ...
- GreenDao 3.2.0 的基本使用
前言 Android开发中我们或多或少都会接触到数据库.Android中提供了一个占用内存极小的关系型数据库-SQLite.虽然Android系统中提供了许多操作SQLite的API,但是我们还是需要 ...
- 如何在NodeJS项目中优雅的使用ES6
如何在NodeJS项目中优雅的使用ES6 NodeJs最近的版本都开始支持ES6(ES2015)的新特性了,设置已经支持了async/await这样的更高级的特性.只是在使用的时候需要在node后面加 ...
- SQL递归查询知多少
最近工作中遇到了一个问题,需要根据保存的流程数据,构建流程图.数据库中保持的流程数据是树形结构的,表结构及数据如下图: 仔细观察表结构,会发现其树形结构的特点: FFIRSTNODE:标记是否为根节点 ...
- netty 对 protobuf 协议的解码与包装探究(2)
netty 默认支持protobuf 的封装与解码,如果通信双方都使用netty则没有什么障碍,但如果客户端是其它语言(C#)则需要自己仿写与netty一致的方式(解码+封装),提前是必须很了解net ...