
爬虫实例系列一(requests)
一 爬虫简介
'''
    爬虫:通过编写程序,模拟浏览器上网,让其去互联网上爬取数据的过程

    分类:
        通用爬虫:爬取全部的页面数据
        聚焦爬虫:抓取页面中局部数据
        增量式爬虫:爬取网站中更新出的数据

    反爬机制:门户网站会通过制定相关的技术手段,组织爬虫程序进行数据获取
    反反爬策略:针对反爬机制制定的策略,为了获取数据

    第一个反爬机制:
        robots.txt协议:防君子不防小人的协议
'''
二 request 入门使用流程
'''

    request使用流程:
        - 制定url
        - 发起请求
        - 获取响应回来的页面数据
        - 持久化存储

'''
三 实例
1 获取搜狗页面(反反爬机制:防君子不防小人)
import requests

#获取搜狗页面数据

#1.指定url

url='https://www.sogo.com/'

#2.发起请求

response=requests.get(url=url)

#3.获取页面数据

response_text=response.text

#4.持久化存储

with open('sogo.html',mode='w',encoding='utf8') as f:

    f.write(response_text)
2 获取知乎页面数据(UA伪装)
'''
    User-Agent:请求载体的身份标识
    反爬机制:UA检测
    反反爬策略:UA伪装
'''
#请求知乎

url='https://www.zhihu.com/'

#指定请求头,进行UA伪装

headers={

    'user-agent': 'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.20 Safari/537.36'

}

response=requests.get(url=url,headers=headers)

print(response.text)
3 post请求实例(请求百度翻译结果)

#请求百度翻译结果

#经过分析发现,百度翻译发送的请求是ajax请求
import requests

url='https://fanyi.baidu.com/sug'

#指定请求头,进行UA伪装

headers={

    'user-agent': 'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.20 Safari/537.36'

}

#搜索数据不要写死

kw=input('input a word:')

#构建请求数据

data={

    'kw':kw

}

response=requests.post(url=url,headers=headers,data=data)

print(response.json())
4 post 请求携带更多参数data={}
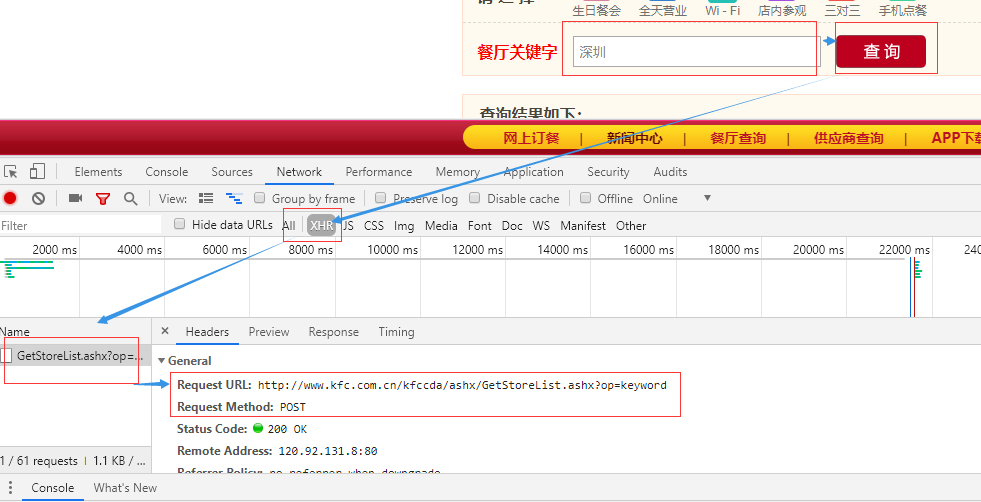

#爬取城市肯德基餐厅的位置信息 http://www.kfc.com.cn/kfccda/storelist/index.aspx

'''

抓包获取的数据

Request URL: http://www.kfc.com.cn/kfccda/ashx/GetStoreList.ashx?op=keyword

Request Method: POST

Status Code: 200 OK

Remote Address: 120.92.131.8:80

Referrer Policy: no-referrer-when-downgrade

'''

import requests

url='http://www.kfc.com.cn/kfccda/ashx/GetStoreList.ashx?op=keyword'

headers={

    'user-agent': 'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.20 Safari/537.36'

}

data={

    'cname':'',

    'pid':'',

    'keyword': '深圳',

    'pageIndex': 3,

    'pageSize': 10,

}

response=requests.post(url=url,headers=headers,data=data)

print(response.json())
5 爬取豆瓣电影中的详细数据(ajax请求)
import requests

#爬取豆瓣电影中的详细数据(ajax请求)

#'https://movie.douban.com/j/chart/top_list?type=24&interval_id=100%3A90&action=&start=20&limit=20'

url='https://movie.douban.com/j/chart/top_list'

headers={

    'user-agent': 'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.20 Safari/537.36'

}

#此处参数已经写死,后续项目中在此基础修改

params={

    'type': '',

    'interval_id': '100:90',

    'action':'',

    'start':'',

    'limit':'',

}

response=requests.get(url=url,headers=headers,params=params)

print(response.json())
爬虫实例系列一(requests)的更多相关文章
- 爬虫实例之使用requests和Beautifusoup爬取糗百热门用户信息
这次主要用requests库和Beautifusoup库来实现对糗百的热门帖子的用户信息的收集,由于糗百的反爬虫不是很严格,也不需要先登录才能获取数据,所以较简单. 思路,先请求首页的热门帖子获得用户 ...
- 爬虫入门系列(二):优雅的HTTP库requests
在系列文章的第一篇中介绍了 HTTP 协议,Python 提供了很多模块来基于 HTTP 协议的网络编程,urllib.urllib2.urllib3.httplib.httplib2,都是和 HTT ...
- 爬虫入门系列(三):用 requests 构建知乎 API
爬虫入门系列目录: 爬虫入门系列(一):快速理解HTTP协议 爬虫入门系列(二):优雅的HTTP库requests 爬虫入门系列(三):用 requests 构建知乎 API 在爬虫系列文章 优雅的H ...
- 爬虫系列(七) requests的基本使用
一.requests 简介 requests 是一个功能强大.简单易用的 HTTP 请求库,可以使用 pip install requests 命令进行安装 下面我们将会介绍 requests 中常用 ...
- python爬虫学习(6) —— 神器 Requests
Requests 是使用 Apache2 Licensed 许可证的 HTTP 库.用 Python 编写,真正的为人类着想. Python 标准库中的 urllib2 模块提供了你所需要的大多数 H ...
- Python爬虫实例:爬取B站《工作细胞》短评——异步加载信息的爬取
很多网页的信息都是通过异步加载的,本文就举例讨论下此类网页的抓取. <工作细胞>最近比较火,bilibili 上目前的短评已经有17000多条. 先看分析下页面 右边 li 标签中的就是短 ...
- Python爬虫实例:爬取猫眼电影——破解字体反爬
字体反爬 字体反爬也就是自定义字体反爬,通过调用自定义的字体文件来渲染网页中的文字,而网页中的文字不再是文字,而是相应的字体编码,通过复制或者简单的采集是无法采集到编码后的文字内容的. 现在貌似不少网 ...
- Python爬虫实例:爬取豆瓣Top250
入门第一个爬虫一般都是爬这个,实在是太简单.用了 requests 和 bs4 库. 1.检查网页元素,提取所需要的信息并保存.这个用 bs4 就可以,前面的文章中已经有详细的用法阐述. 2.找到下一 ...
- [python爬虫]Requests-BeautifulSoup-Re库方案--Requests库介绍
[根据北京理工大学嵩天老师“Python网络爬虫与信息提取”慕课课程编写 文章中部分图片来自老师PPT 慕课链接:https://www.icourse163.org/learn/BIT-10018 ...
随机推荐
- asp.net core系列 37 WebAPI 使用OpenAPI (swagger)中间件
一.概述 在使用Web API时,对于开发人员来说,了解其各种方法可能是一项挑战.在ASP.NET Core上,Web api 辅助工具介绍二个中间件,包括:Swashbuckle和NSwag .NE ...
- 【Android】打开本地的html文件
网上好多说法 但实际上说到点上的没有 不想写太长 直接进入正题 Intent intent = new Intent(Intent.ACTION_VIEW); intent.addCategory(I ...
- 深入理解Mybatis插件开发
背景 关于Mybatis插件,大部分人都知道,也都使用过,但很多时候,我们仅仅是停留在表面上,知道Mybatis插件可以在DAO层进行拦截,如打印执行的SQL语句日志,做一些权限控制,分页等功能:但对 ...
- String str=null; 和String str=""的区别
1.最大的区别在于String str=null没有分配内存,String str=""分配了内存 2.String str=null 这个引用指向了一个null ,没有地址没 ...
- mariadb 内存占用优化
本文由云+社区发表 作者:工程师小熊 摘要:我们在使用mariadb的时候发现有时候不能启动起来,在使用过程中mariadb占用的内存很大,在这里学习下mariadb与内存相关的配置项,对mariad ...
- Docker系列09—Docker的系统资源限制及验证
本文收录在容器技术学习系列文章总目录 1.限制容器的资源 默认情况下,容器没有资源限制,可以使用主机内核调度程序允许的尽可能多的给定资源.Docker提供了控制容器可以使用多少内存或CPU的方法,设置 ...
- 痞子衡嵌入式:串口调试工具Jays-PyCOM诞生记(5)- 软件优化
大家好,我是痞子衡,是正经搞技术的痞子.今天痞子衡给大家介绍的是串口调试工具Jays-PyCOM诞生之软件优化. 前面痞子衡已经初步实现了Jays-PyCOM的串口功能,并且通过了最基本的测试,但目前 ...
- JsonRequestBehavior不存在问题,JsonRequestBehavior属于哪个dll
1.C#.Net.C++.JScript.VB语法 获取或设置一个值,该值指示是否允许来自客户端的 HTTP GET 请求. 命名空间: System.Web.Mvc程序集: System.Web.M ...
- python之编码与解码
编码 字符串被当作url提交时会被自动进行url编码处理,在python里也有个urllib.urlencode的方法,可以很方便的把字典形式的参数进行url编码.当url地址含有中文或者“/”的时候 ...
- Android破解学习之路(十)—— 我们恋爱吧 三色绘恋 二次破解
前言 好久没有写破解教程了(我不会告诉你我太懒了),找到一款恋爱游戏,像我这样的宅男只能玩玩恋爱游戏感觉一下恋爱的心动了.. 这款游戏免费试玩,但是后续章节得花6元钱购买,我怎么会有钱呢,而且身在吾爱 ...