
Python爬虫实例:爬取B站《工作细胞》短评——异步加载信息的爬取
很多网页的信息都是通过异步加载的,本文就举例讨论下此类网页的抓取。
《工作细胞》最近比较火,bilibili 上目前的短评已经有17000多条。
先看分析下页面
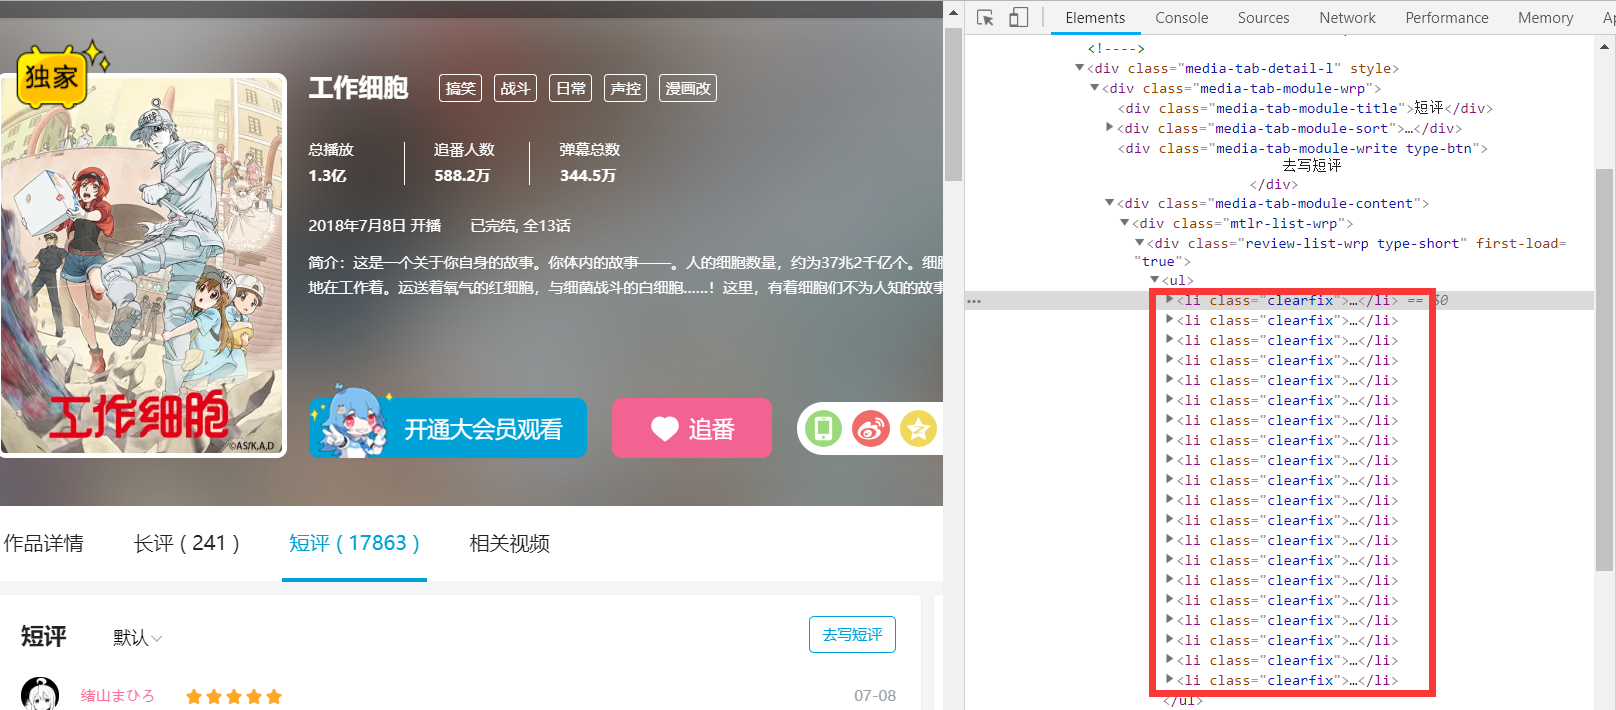
右边 li 标签中的就是短评信息,一共20条。一般我们加载大量数据的时候,都会做分页,但是这个页面没有,只有一个滚动条。
随着滚动条往下拉,信息自动加载了,如下图,变40条了。由此可见,短评是通过异步加载的。

我们不可能一次性将滚动条拉到最下面,然后来一次性获取全部的数据。既然知道是通过异步来加载的数据,那么我们可以想办法直接去获取这些异步的数据。
打开 Network 查看分析 http 请求,可以点击 XHR 过滤掉 img、css、js 等信息。这时我们发现了一些 fetch。fetch 我对它的了解就是一个比 ajax 更高级更好用的 API,当然这肯定是不准确的,但并并不影响我们的爬虫。
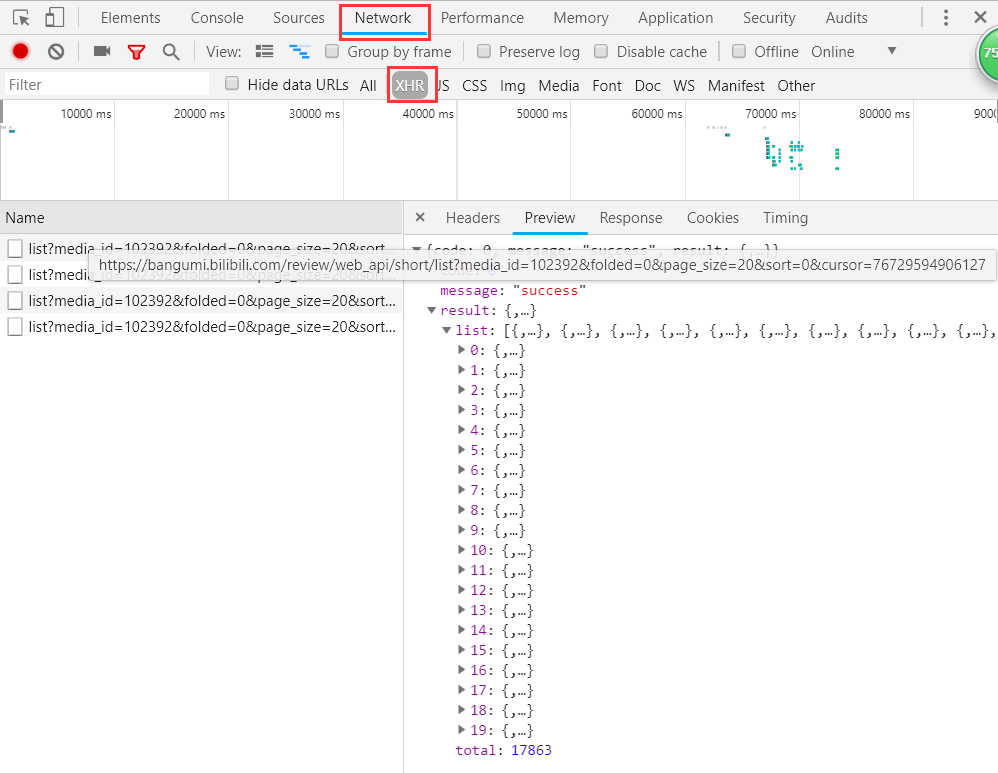
我们可以看到,其中返回的就是我们需要的内容,json 格式,一共20条,total 属性就是总的数目。分析一下 url 地址:https://bangumi.bilibili.com/review/web_api/short/list?media_id=102392&folded=0&page_size=20&sort=0&cursor=76729594906127
media_id 想必就是《工作细胞》的 id 了;
folded 不知道是啥,可以不管;
page_size 是每页的条数;
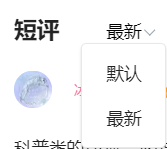
sort 排序,看名字就知道,找到排序的选项,试了下,果然是的,默认0,最新1;
cursor,字面意思的光标,猜测应该是指示本次获取开始的位置的,展开获取到的 json,发现其中包含有 cursor 属性,对比以后可以发现,url中的值跟上一次返回结果中的最后一条中的 cursor 的值是一致的。
好了,至此,页面已经分析清楚了,爬取的方式也明显了,根本不用管网页,直接根据 fetch 的地址获取 json 数据就可以了,连网页解析都省了,超级的方便。
下面的完整的代码:(如果 fake_useragent 报错,就手动写个 User-Agent 吧,那个库极度的不稳定)
import csv

import os

import time

import requests

from fake_useragent import UserAgent

curcount = 0

def main():

    url = 'https://bangumi.bilibili.com/review/web_api/short/list?media_id=102392&folded=0&page_size=20&sort=0'

    crawling(url)

def crawling(url):

    print(f'正在爬取:{url}')

    global curcount

    headers = {"User-Agent": UserAgent(verify_ssl=False).random}

    json_content = requests.get(url, headers).json()

    total = json_content['result']['total']

    infolist = []

    for item in json_content['result']['list']:

        info = {

            'author': item['author']['uname'],

            'content': item['content'],

            'ctime': time.strftime('%Y-%m-%d %H:%M:%S', time.localtime(item['ctime'])),

            'likes': item['likes'],

            'disliked': item['disliked'],

            'score': item['user_rating']['score']

        }

        infolist.append(info)

    savefile(infolist)

    curcount += len(infolist)

    print(f'当前进度{curcount}/{total}')

    if curcount >= total:

        print('爬取完毕。')

        return

    nexturl = f'https://bangumi.bilibili.com/review/web_api/short/list?' \

              f'media_id=102392&folded=0&page_size=20&sort=0&cursor={json_content["result"]["list"][-1]["cursor"]}'

    time.sleep(1)

    crawling(nexturl)

def savefile(infos):

    with open('WorkingCell.csv', 'a', encoding='utf-8') as sw:

        fieldnames = ['author', 'content', 'ctime', 'likes', 'disliked', 'score']

        writer = csv.DictWriter(sw, fieldnames=fieldnames)

        writer.writerows(infos)

if __name__ == '__main__':

    if os.path.exists('WorkingCell.csv'):

        os.remove('WorkingCell.csv')

    main()
相关博文推荐:
Python爬虫实例:爬取B站《工作细胞》短评——异步加载信息的爬取的更多相关文章
- Python爬虫实例:爬取猫眼电影——破解字体反爬
字体反爬 字体反爬也就是自定义字体反爬,通过调用自定义的字体文件来渲染网页中的文字,而网页中的文字不再是文字,而是相应的字体编码,通过复制或者简单的采集是无法采集到编码后的文字内容的. 现在貌似不少网 ...
- Python爬虫实例:爬取豆瓣Top250
入门第一个爬虫一般都是爬这个,实在是太简单.用了 requests 和 bs4 库. 1.检查网页元素,提取所需要的信息并保存.这个用 bs4 就可以,前面的文章中已经有详细的用法阐述. 2.找到下一 ...
- Python 爬虫练习项目——异步加载爬取
项目代码 from bs4 import BeautifulSoup import requests url_prefix = 'https://knewone.com/discover?page=' ...
- Python 爬取异步加载的数据
在我们的工作中,可能会遇到这样的情况:我们需要爬取的数据是通过ajax异步加载的,这样的话通过requests得到的只是一个静态页面,而我们需要的是ajax动态加载的数据! 那我们应该怎么办呢??? ...
- Python爬虫爬取异步加载的数据
前言 本文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理.作者:努力努力再努力 爬取qq音乐歌手数据接口数据 https://y.qq ...
- 爬虫--selenuim和phantonJs处理网页动态加载数据的爬取
1.谷歌浏览器的使用 下载谷歌浏览器 安装谷歌访问助手 终于用上谷歌浏览器了.....激动 问题:处理页面动态加载数据的爬取 -1.selenium -2.phantomJs 1.selenium 二 ...
- 爬虫开发6.selenuim和phantonJs处理网页动态加载数据的爬取
selenuim和phantonJs处理网页动态加载数据的爬取阅读量: 1203 动态数据加载处理 一.图片懒加载 什么是图片懒加载? 案例分析:抓取站长素材http://sc.chinaz.com/ ...
- Scrapy爬取Ajax(异步加载)网页实例——简书付费连载
这两天学习了Scrapy爬虫框架的基本使用,练习的例子爬取的都是传统的直接加载完网页的内容,就想试试爬取用Ajax技术加载的网页. 这里以简书里的优选连载网页为例分享一下我的爬取过程. 网址为: ht ...
- Scrapy爬虫框架教程(四)-- 抓取AJAX异步加载网页
欢迎关注博主主页,学习python视频资源,还有大量免费python经典文章 sklearn实战-乳腺癌细胞数据挖掘 https://study.163.com/course/introduction ...
随机推荐
- .net core在网关中统一配置Swagger
最近在做微服务的时候,由于我们是采用前后端分离来开发的,提供给前端的直接是Swagger,如果Swagger分布在各个API中,前端查看Swagger的时候非常不便,因此,我们试着将Swagger集中 ...
- 【Never Stop】联赛集训记录
始于10/01/2017. Day I: T2图论,没想到.T3谜一样DP(是从来没意识到还可以这样). rank10. 下午刷了点题,CDQ也只打出一个板子,感觉自己不在状态? ========== ...
- 在CentOS下安装Git
1.安装git依赖包 yum install curl-devel expat-devel gettext-devel openssl-devel zlib-devel gcc perl-ExtUti ...
- 大白话5分钟带你走进人工智能-第十五节L1和L2正则几何解释和Ridge,Lasso,Elastic Net回归
第十五节L1和L2正则几何解释和Ridge,Lasso,Elastic Net回归 上一节中我们讲解了L1和L2正则的概念,知道了L1和L2都会使不重要的维度权重下降得多,重要的维度权重下降得少,引入 ...
- jdk源码阅读笔记-ArrayList
一.ArrayList概述 首先我们来说一下ArrayList是什么?它解决了什么问题?ArrayList其实是一个数组,但是有区别于一般的数组,它是一个可以动态改变大小的动态数组.ArrayList ...
- [转载] Java中枚举类型的使用 - enum
目录 1 枚举类的编译特性 2 向枚举类中添加方法 3 接口内部创建枚举 4 枚举类中使用枚举 5 扩展: 验证values()不是通过父类继承的 本文转载自博客 - Java枚举类型, 博主对原文内 ...
- Java进阶篇设计模式之十一 ---- 策略模式和模板方法模式
前言 在上一篇中我们学习了行为型模式的访问者模式(Visitor Pattern)和中介者模式(Mediator Pattern).本篇则来学习下行为型模式的两个模式,策略模式(Strategy Pa ...
- .net core 杂记:日记记录
ASP.NET Core 有内置的log组件,遗憾的是看了微软官方文档,貌似无法直接将日志存于文件或数据库,只能由自己实现或引用第三方日志组件. 以下为Nlog和log4net的使用记录 Nlog使用 ...
- 万马齐喑究可哀-中文编程的又一波"讨论"
刚申诉了自动折叠, 还是把回答转帖一下: 吴烜:假设中国人最先开发电脑和设计程序语言,那么各种程序语言会使用汉字吗? 这种有明显倾向性的问题怎么还有市场呢...不管谁先开发的电脑(就不论算盘之类是不是 ...
- windows server 2012 r2打造工作站链接 和 RTSS画面防止撕裂方法(包括笔记本独显撕裂,视频撕裂等)
听说 windows server 2008 基于windows vista ,windows server 2008 R2基于win7 , windows server 2012 基于windows ...