
Spark环境搭建(五)-----------Spark生态圈概述与Hadoop对比
Spark:快速的通用的分布式计算框架
概述和特点:
1) Speed,(开发和执行)速度快。基于内存的计算;DAG(有向无环图)的计算引擎;基于线程模型;
2)Easy of use,易用 。 多语言(Java,python,scala,R); 多种计算API可调用;可在交互式模式下运行;
3)Generality 通用。可以一站式解决多个不同场景的应用业务
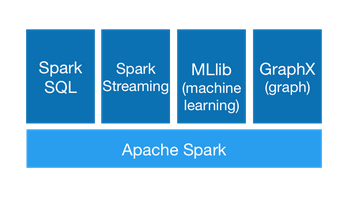
Spark Streaming :用来做流处理
MLlib : 用于机器学习
GraphX:用来做图形计算的
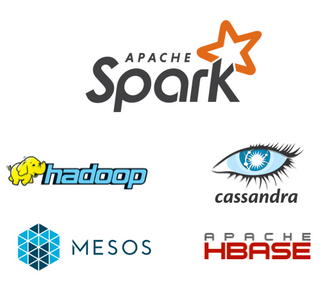
4) Runs Everywhere :
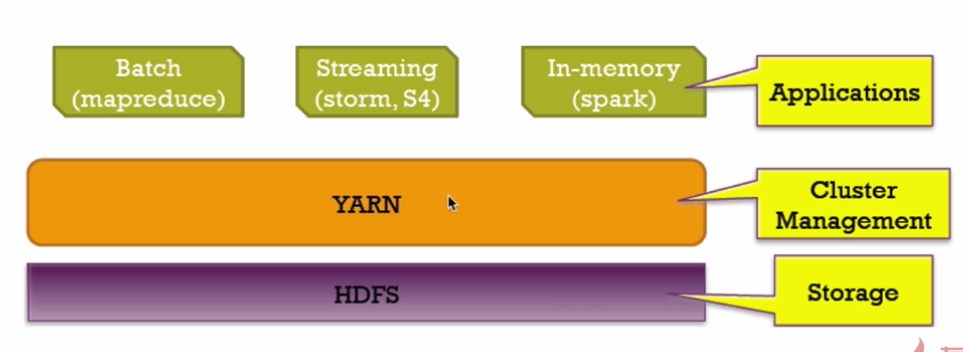
(1)可以运行在Hadoop的yarn,Mesos,standalone(Sprk自带的)这些资源管理和调度的程序之上
(2) 可以连接包括HDFS,Cassandra,HBase,S3这些数据源
产生背景:
1)MapReduce 局限性
(1)代码繁琐(官网有WordOCunt案例)
(2)效率低下:
a) 有结果写入磁盘,降低效率;
b) 通过进程模型,销毁创建效率低
(3)只能支持map和reduce方法
(4) 不适合迭代多次,交互式,流水的处理
2) 框架的多样化
(1)批处理(离线):MapReduce,Hive,Pig
(2)流式处理(实时):Storm,Jstorm
(3)交互式计算 :Impala
综上: 框架的多样化导致生产时所需要的框架繁多,学习运维成本较高,那么有没有一种框架,
既能执行效率高,学习成本低,还能支持批处理和流式处理与交互计算呢?
结论:Spark诞生
Spark与Hadoop对比:
Hadoop生态系统
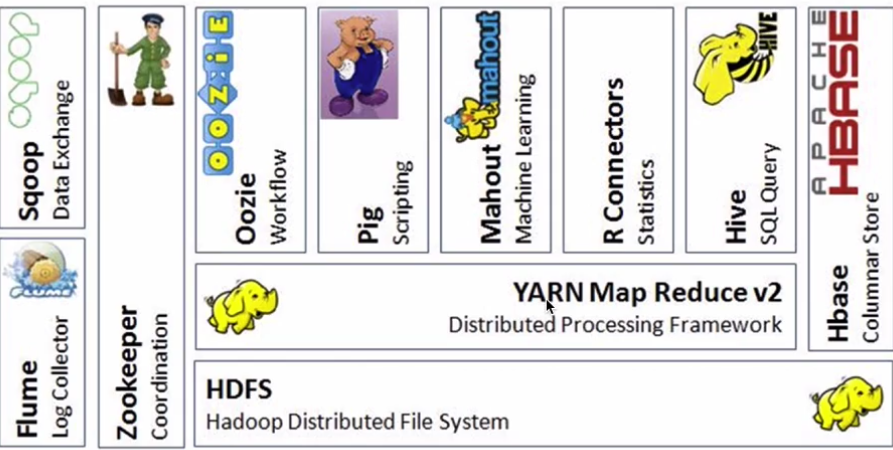
Hive:数据仓库
R:数据分析
Mahout:机器学习库
pig:脚本语言,跟Hive类似
Oozie:工作流引擎,管理作业执行顺序
Zookeeper:用户无感知,主节点挂掉选择从节点作为主的
Flume:日志收集框架
Sqoop:数据交换框架,例如:关系型数据库与HDFS之间的数据交换
Hbase : 海量数据中的查询,相当于分布式文件系统中的数据库
BDAS:Berkeley Data Analytics Stack(伯克利数据分析平台)
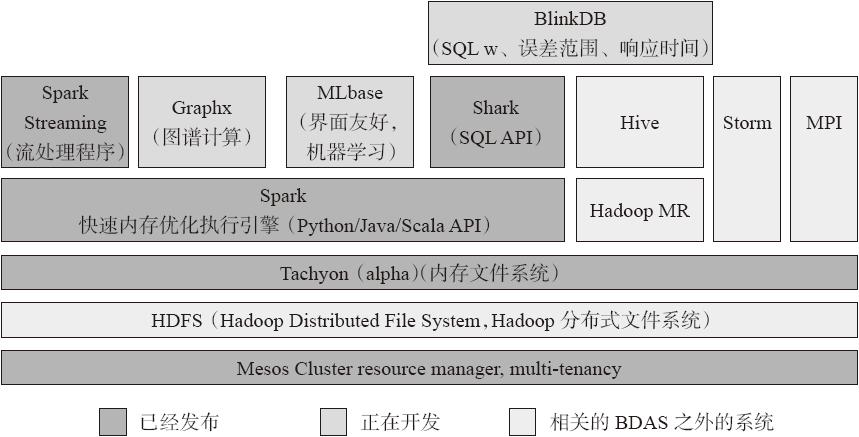
Spark与Hadoop生态圈对比
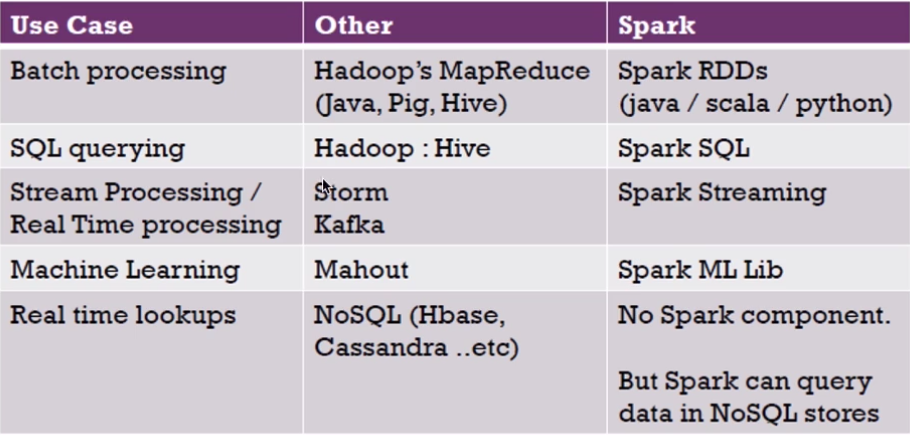
注意:在对实时的查询来说,Spark只是一个快速的分布式计算框架,所以没有存储的框架,但是可以连接多个存储的数据源
Hadoop与Spark对比
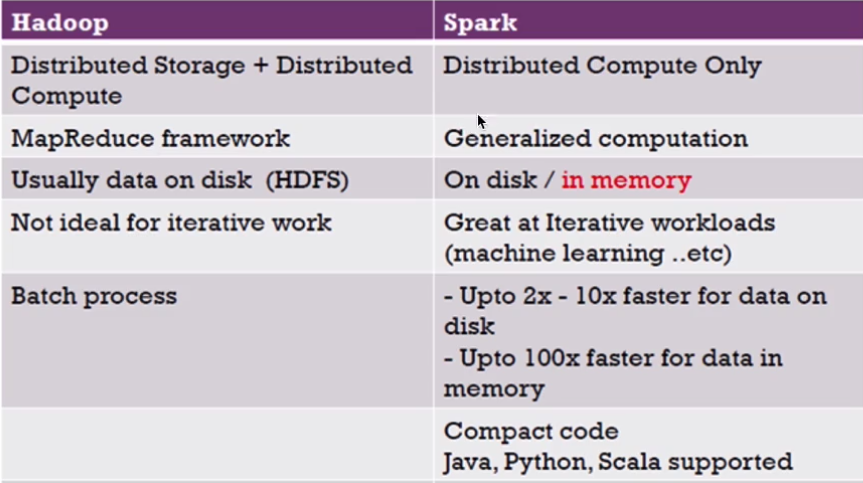
MapReduce与Spark对比:
MapReduce:若进行多次计算,MP则需要将上一次执行结果写入到磁盘,叫做数据落地
Spark:直接将存储在内存中的结果拿来使用,没有数据落地

Spark与Hadoop的协作性
Spark概述和与Hadoop对比
Spark环境搭建(五)-----------Spark生态圈概述与Hadoop对比的更多相关文章
- Hive On Spark环境搭建
Spark源码编译与环境搭建 Note that you must have a version of Spark which does not include the Hive jars; Spar ...
- Spark环境搭建(上)——基础环境搭建
Spark摘说 Spark的环境搭建涉及三个部分,一是linux系统基础环境搭建,二是Hadoop集群安装,三是Spark集群安装.在这里,主要介绍Spark在Centos系统上的准备工作--linu ...
- 分布式计算框架-Spark(spark环境搭建、生态环境、运行架构)
Spark涉及的几个概念:RDD:Resilient Distributed Dataset(弹性分布数据集).DAG:Direct Acyclic Graph(有向无环图).SparkContext ...
- Spark学习进度-Spark环境搭建&Spark shell
Spark环境搭建 下载包 所需Spark包:我选择的是2.2.0的对应Hadoop2.7版本的,下载地址:https://archive.apache.org/dist/spark/spark-2. ...
- 大数据学习系列之六 ----- Hadoop+Spark环境搭建
引言 在上一篇中 大数据学习系列之五 ----- Hive整合HBase图文详解 : http://www.panchengming.com/2017/12/18/pancm62/ 中使用Hive整合 ...
- 4.Spark环境搭建和使用方法
一.安装Spark spark和Hadoop可以部署在一起,相互协作,由Hadoop的HDFS.HBase等组件复制数据的存储和管理,由Spark负责数据的计算. Linux:CentOS Linux ...
- 学习Spark——环境搭建(Mac版)
大数据情结 还记得上次跳槽期间,与很多猎头都有聊过,其中有一个猎头告诉我,整个IT跳槽都比较频繁,但是相对来说,做大数据的比较"懒"一些,不太愿意动.后来在一篇文中中也证实了这一观 ...
- Spark环境搭建(六)-----------sprk源码编译
想要搭建自己的Hadoop和spark集群,尤其是在生产环境中,下载官网提供的安装包远远不够的,必须要自己源码编译spark才行. 环境准备: 1,Maven环境搭建,版本Apache Maven 3 ...
- Spark环境搭建(四)-----------数据仓库Hive环境搭建
Hive产生背景 1)MapReduce的编程不便,需通过Java语言等编写程序 2) HDFS上的文缺失Schema(在数据库中的表名列名等),方便开发者通过SQL的方式处理结构化的数据,而不需要J ...
随机推荐
- 关于js dtGrid报错长度的问题
错误js截图 Uncaught TypeError: Cannot read property 'length' of undefined 翻译:Uncaught TypeError:无法读取未定义的 ...
- 提取 linux 文件目录结构
提取 linux 文件的目录结构 find /home/user1/ -type d |while read line ;do mkdir -p /home/user2/$line;done
- php、apache、nginx、线程、进程
最近在学swoole,发现里面设计好多操作系统里面的概念,这些基础知识正是自己欠缺的.根基不牢的高楼大厦,犹如空中楼阁,随时都要崩塌,早发现早治疗哈哈^_^. 一.概念 1) 进程:是指正在运行的一个 ...
- python序列化与反序列化(json与pickle)
在python中,序列化可以理解为将python中对象的编码格式转换为json(pickle)格式的字符串,而反序列化可以 理解为将json(pickle)格式的字符串转换为python中对象的编码格 ...
- Doom HDU - 5239 (找规律+线段树)
题目链接: D - Doom HDU - 5239 题目大意:首先是T组测试样例,然后n个数,m次询问,然后每一次询问给你一个区间,问你这个这段区间的加上上一次的和是多少,查询完之后,这段区间里 ...
- Python爬虫之selenium各种注意报错
刚刚写完第一个selenuim+BeautifulSoup实战爬虫 爬淘宝.发现代码写完后不加for 翻页的时候没什么问题 解析 操作 都没问题 也就是说第一页 的内容 完好 pagebtn=wait ...
- IntelliJ Idea 第一次使用
概括 程序员每次电脑重新安装或者新的电脑上进行开发时都会安装一些开发软件,这时候基本都是去官网下载,然后破解(中国程序员啊哈哈)进行快乐使用,为了让自己方便小编也写一个,不用去别人那里找来找去 安装I ...
- Iterator接口(迭代器)
目录 前言 原理 方法 异常 Iterator接口(迭代器) 前言 一般遍历数组都是采用for循环或者增强for,这两个方法也可以用在集合框架,但是还有一种方法是采用迭代器遍历集合框架,它是一个对象, ...
- 使用SpringSecurity体验OAuth2 (入门2)
本文继续使用SpringSecurity从实战角度对OAuth2进行体验,上一篇 搭建了项目环境,并对配置做了初步分析,分析发现会有两套配置可能在影响OAuth,一个是由授权服务的启动类上的注解@En ...
- Vue报错——“Trailing spaces not allowed”
在VSCode中开发Vue 报错:“Trailing spaces not allowed” 这是空格多了,删除多余的空格就可以了