
EurekaServer集群配置
一、程序配置
1、pom添加依赖:
<dependency>

            <groupId>org.springframework.cloud</groupId>

            <artifactId>spring-cloud-starter-netflix-eureka-server</artifactId>

</dependency>
(这里因为在pom中通过dependencyManagement配置将spring-cloud-dependencies import进来,所以不需要写版本号)
或者在是使用Spring Initializr创建SpringBoot项目时,添加上起步依赖Eureka Server (路径:Cloud Discovery -- Eureka Server)。
完整pom为:
<?xml version="1.0" encoding="UTF-8"?>

<project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"

    xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd">

    <modelVersion>4.0.0</modelVersion>

    <groupId>com.example</groupId>

    <artifactId>microservice-discovery-eureka-ha</artifactId>

    <version>0.0.1-SNAPSHOT</version>

    <packaging>jar</packaging>

    <name>microservice-discovery-eureka-ha</name>

    <description>Demo project for Spring Boot</description>

    <parent>

        <groupId>org.springframework.boot</groupId>

        <artifactId>spring-boot-starter-parent</artifactId>

        <version>2.1.1.RELEASE</version>

        <relativePath/> <!-- lookup parent from repository -->

    </parent>

    <properties>

        <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>

        <project.reporting.outputEncoding>UTF-8</project.reporting.outputEncoding>

        <java.version>1.8</java.version>

        <spring-cloud.version>Greenwich.M3</spring-cloud.version>

    </properties>

    <dependencies>

        <dependency>

            <groupId>org.springframework.cloud</groupId>

            <artifactId>spring-cloud-starter-netflix-eureka-server</artifactId>

        </dependency>

        <dependency>

            <groupId>org.springframework.boot</groupId>

            <artifactId>spring-boot-starter-test</artifactId>

            <scope>test</scope>

        </dependency>

    </dependencies>

    <dependencyManagement>

        <dependencies>

            <dependency>

                <groupId>org.springframework.cloud</groupId>

                <artifactId>spring-cloud-dependencies</artifactId>

                <version>${spring-cloud.version}</version>

                <type>pom</type>

                <scope>import</scope>

            </dependency>

        </dependencies>

    </dependencyManagement>

    <build>

        <plugins>

            <plugin>

                <groupId>org.springframework.boot</groupId>

                <artifactId>spring-boot-maven-plugin</artifactId>

            </plugin>

        </plugins>

    </build>

    <repositories>

        <repository>

            <id>spring-milestones</id>

            <name>Spring Milestones</name>

            <url>https://repo.spring.io/milestone</url>

            <snapshots>

                <enabled>false</enabled>

            </snapshots>

        </repository>

    </repositories>

</project>
2、在SpringBoot启动类上添加注释@EnableEurekaServer
3、配置application.yml或application.properties
spring:

  application:

    name: microservice-discovery-eureka-ha

---

spring:

  profiles: peer1

server:

  port: 8761

eureka:

  instance:

    hostname: peer1

  client:

    service-url:

      defaultZone: http://peer2:8762/eureka/

    register-with-eureka: false #作为对比,这里表示不将peer1注册到Eureka Server集群中,peer2中默认为true

    fetch-registry: false  #作为对比,这里表示peer1不会从Eureka Server集群获取注册表信息

---

spring:

  profiles: peer2

server:

  port: 8762

eureka:

  instance:

    hostname: peer2

  client:

    service-url:

      defaultZone: http://peer1:8761/eureka/
例子程序的github地址是:https://github.com/zjianliu/Eureka-Server
二、程序运行
将程序打包后,执行jar包:
java -jar xxx.jar --spring.profiles.active=peer1

java -ajr xxx.jar --spring.profiles.active=peer2
通过spring.profiles.active指定使用application.yml中配置的哪一个profile启动程序。
三、程序截图
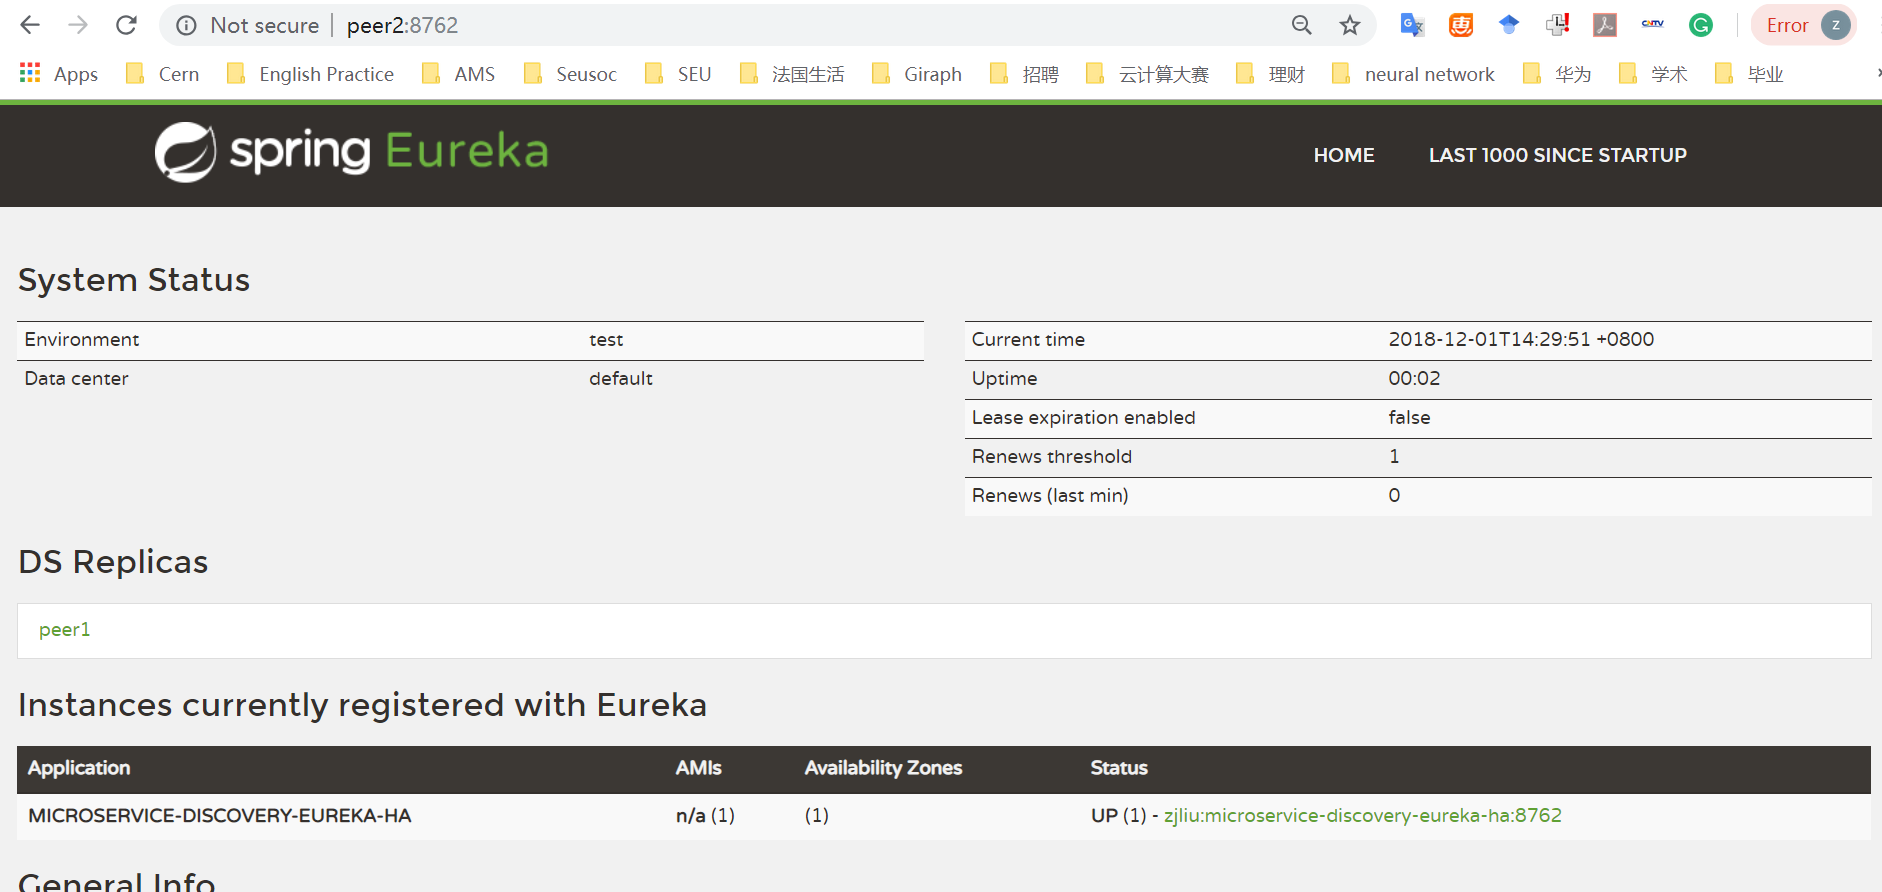
我们可以看到,peer2将自身注册到Eureka Server集群中了,而peer1没有。
Eureka Server配置启动好之后,我们就可以写微服务,并通过配置将其注册到Eureka Server集群中了

EurekaServer集群配置的更多相关文章
- SpringCloud学习笔记(四):Eureka服务注册与发现、构建步骤、集群配置、Eureka与Zookeeper的比较
简介 Netflix在设计Eureka时遵守的就是AP原则 拓展: 在分布式数据库中的CAP原理 CAP原则又称CAP定理,指的是在一个分布式系统中,Consistency(一致性). Availab ...
- 【一起学源码-微服务】Nexflix Eureka 源码十二:EurekaServer集群模式源码分析
前言 前情回顾 上一讲看了Eureka 注册中心的自我保护机制,以及里面提到的bug问题. 哈哈 转眼间都2020年了,这个系列的文章从12.17 一直写到现在,也是不容易哈,每天持续不断学习,输出博 ...
- Ubuntu 14.04中Elasticsearch集群配置
Ubuntu 14.04中Elasticsearch集群配置 前言:本文可用于elasticsearch集群搭建参考.细分为elasticsearch.yml配置和系统配置 达到的目的:各台机器配置成 ...
- Redis 3.0 Cluster集群配置
Redis 3.0 Cluster集群配置 安装环境依赖 安装gcc:yum install gcc 安装zlib:yum install zib 安装ruby:yum install ruby 安装 ...
- MongoDB高可用集群配置的方案
>>高可用集群的解决方案 高可用性即HA(High Availability)指的是通过尽量缩短因日常维护操作(计划)和突发的系统崩溃(非计划)所导致的停机时间,以提高系统和应用的可用性. ...
- MySQL Cluster 7.3.5 集群配置实例(入门篇)
一.环境说明: CentOS6.3(32位) + MySQL Cluster 7.3.5,规划5台机器,资料如下: 节点分布情况: MGM:192.168.137. NDBD1:192.168.137 ...
- MySQL Cluster 7.3.5 集群配置参数优化(优化篇)
按照前面的教程:MySQL Cluster 7.3.5 集群配置实例(入门篇),可快速搭建起基础版的MySQL Cluster集群,但是在生成环境中,还是有很多问题的,即配置参数需要优化下, 当前生产 ...
- 关于ActiveMQ的几种集群配置
ActiveMQ的几种集群配置. Queue consumer clusters 此集群让多个消费者同时消费一个队列,若某个消费者出问题无法消费信息,则未消费掉的消息将被发给其他正常的消费者,结构图如 ...
- solrCloud+tomcat+zookeeper集群配置
solrcolud安装solrCloud+tomcat+zookeeper部署 转载请出自出处:http://eksliang.iteye.com/blog/2107002 http://eksli ...
随机推荐
- JVM常见配置
堆设置 -Xms:初始堆大小 -Xmx:最大堆大小 -XX:NewSize=n:设置年轻代大小 -XX:NewRatio=n:设置年轻代和年老代的比值.如:为3,表示年轻代与年老代比值为1:3,年轻代 ...
- 本地矩阵(Local Matrix)
本地矩阵具有整型的行.列索引值和双精度浮点型的元素值,它存储在单机上.MLlib支持稠密矩阵DenseMatrix和稀疏矩阵Sparse Matrix两种本地矩阵,稠密矩阵将所有元素的值存储在一个列优 ...
- git branch 分支与合并
在使用 git 进行分支开发与合并的时候需要用到这些命令.其他基本 git 命令参考 Git 简易食用指南 git branch 查看分支 git branch 查看当前分支情况 创建分支 git b ...
- 剑指offer-字符串的排列26
题目描述 输入一个字符串,按字典序打印出该字符串中字符的所有排列.例如输入字符串abc,则打印出由字符a,b,c所能排列出来的所有字符串abc,acb,bac,bca,cab和cba. 输入描述: 输 ...
- 论文笔记:Attentional Correlation Filter Network for Adaptive Visual Tracking
Attentional Correlation Filter Network for Adaptive Visual Tracking CVPR2017 摘要:本文提出一种新的带有注意机制的跟踪框架, ...
- ElasticSearch 论坛搜索查询语句
概述 研究论坛搜索如何综合时间和TF/IDF权重. 自定义权重计算的效率问题 数据结构 假设有一个论坛的搜索 字段包括: subject:标题 message:内容 dateline:发布时间 tag ...
- javascript打开新窗口
一.window.open()支持环境: JavaScript1.0+/JScript1.0+/Nav2+/IE3+/Opera3+ 二.基本语法: window.open(pageURL,name, ...
- Java经典问题
1.JAVA初学者都应该搞懂的问题 对于这个系列里的问题,每个学Java的人都应该搞懂.当然,如果只是学Java玩玩就无所谓了.如果你认为自己已经超越初学者了,却不很懂这些问题,请将你自己重归初学者行 ...
- Python面向对象-类成员
类的成员可以分为三大类:字段.方法和属性: 注:所有成员中,只有普通字段的内容保存对象中,即:根据此类创建了多少对象,在内存中就有多少个普通字段.而其他的成员,则都是保存在类中,即:无论对象的多少,在 ...
- HTMLTestRunner解决UnicodeDecodeError: ‘ascii’ codec can’t decode byte 0xe5 in position 108: ordinal not in range(128)
其中HTML和数据库都是设置成utf-8格式编码,插入到数据库中是正确的,但是当读取出来的时候就会出错,原因就是python的str默认是ascii编码,和unicode编码冲突,就会报这个标题错误. ...