
目标检测 | Spatially Sparse Convolution
Spatially Sparse Convolution
导言
为什么需要稀疏化?
在3D表示中,除了点云(Point Cloud)和网格模型(Mesh),我们常常还会使用到一种称为体素(Voxel)的表示方式。类似于像素(Pixel),这种表示方式将空间均匀地切割为一个个方块,TSDF和占据网格(Occupancy Network)都可以视为体素的一种变形。
最朴素的体素表示方式,这是一种稠密(Dense)的表示形式,我们给定一个\(L\times W\times H\)的包围盒,体素尺寸为\(1\times 1\times 1\),那么我们将得到一个\(L\times W\times H\)的\(bool\)矩阵:
\begin{cases}
1 & \text{if voxel } (x, y, z) \text{ is occupied.}, \\
0 & otherwise.
\end{cases}
\\
\text{where } 0 \leq x < L, \ 0 \leq y < W, \ 0 \leq z < H
\]
那么假设我们有一个\(70.4m\times80m\times4m\)的室外点云场景(KITTI点云格式的感知范围),给定每个体素大小为\(0.16m\times0.16m\times4m\)(PointPillar将点云体素化的参数),那么将得到一个大小为\(440\times 500\times1=220,000\)的体素网格,而最终有效的体素数量不会超过\(40,000\)个,即利用率不会超过\(18\%\),稠密表示形式下,有\(80\%\)的存储空间是被浪费的。
我们在模拟器中简单采集一帧点云做个实验就可以看到,当体素大小为\(0.05m\)时,基本保留原始点云的细节,但此时占用率不足千分之一。
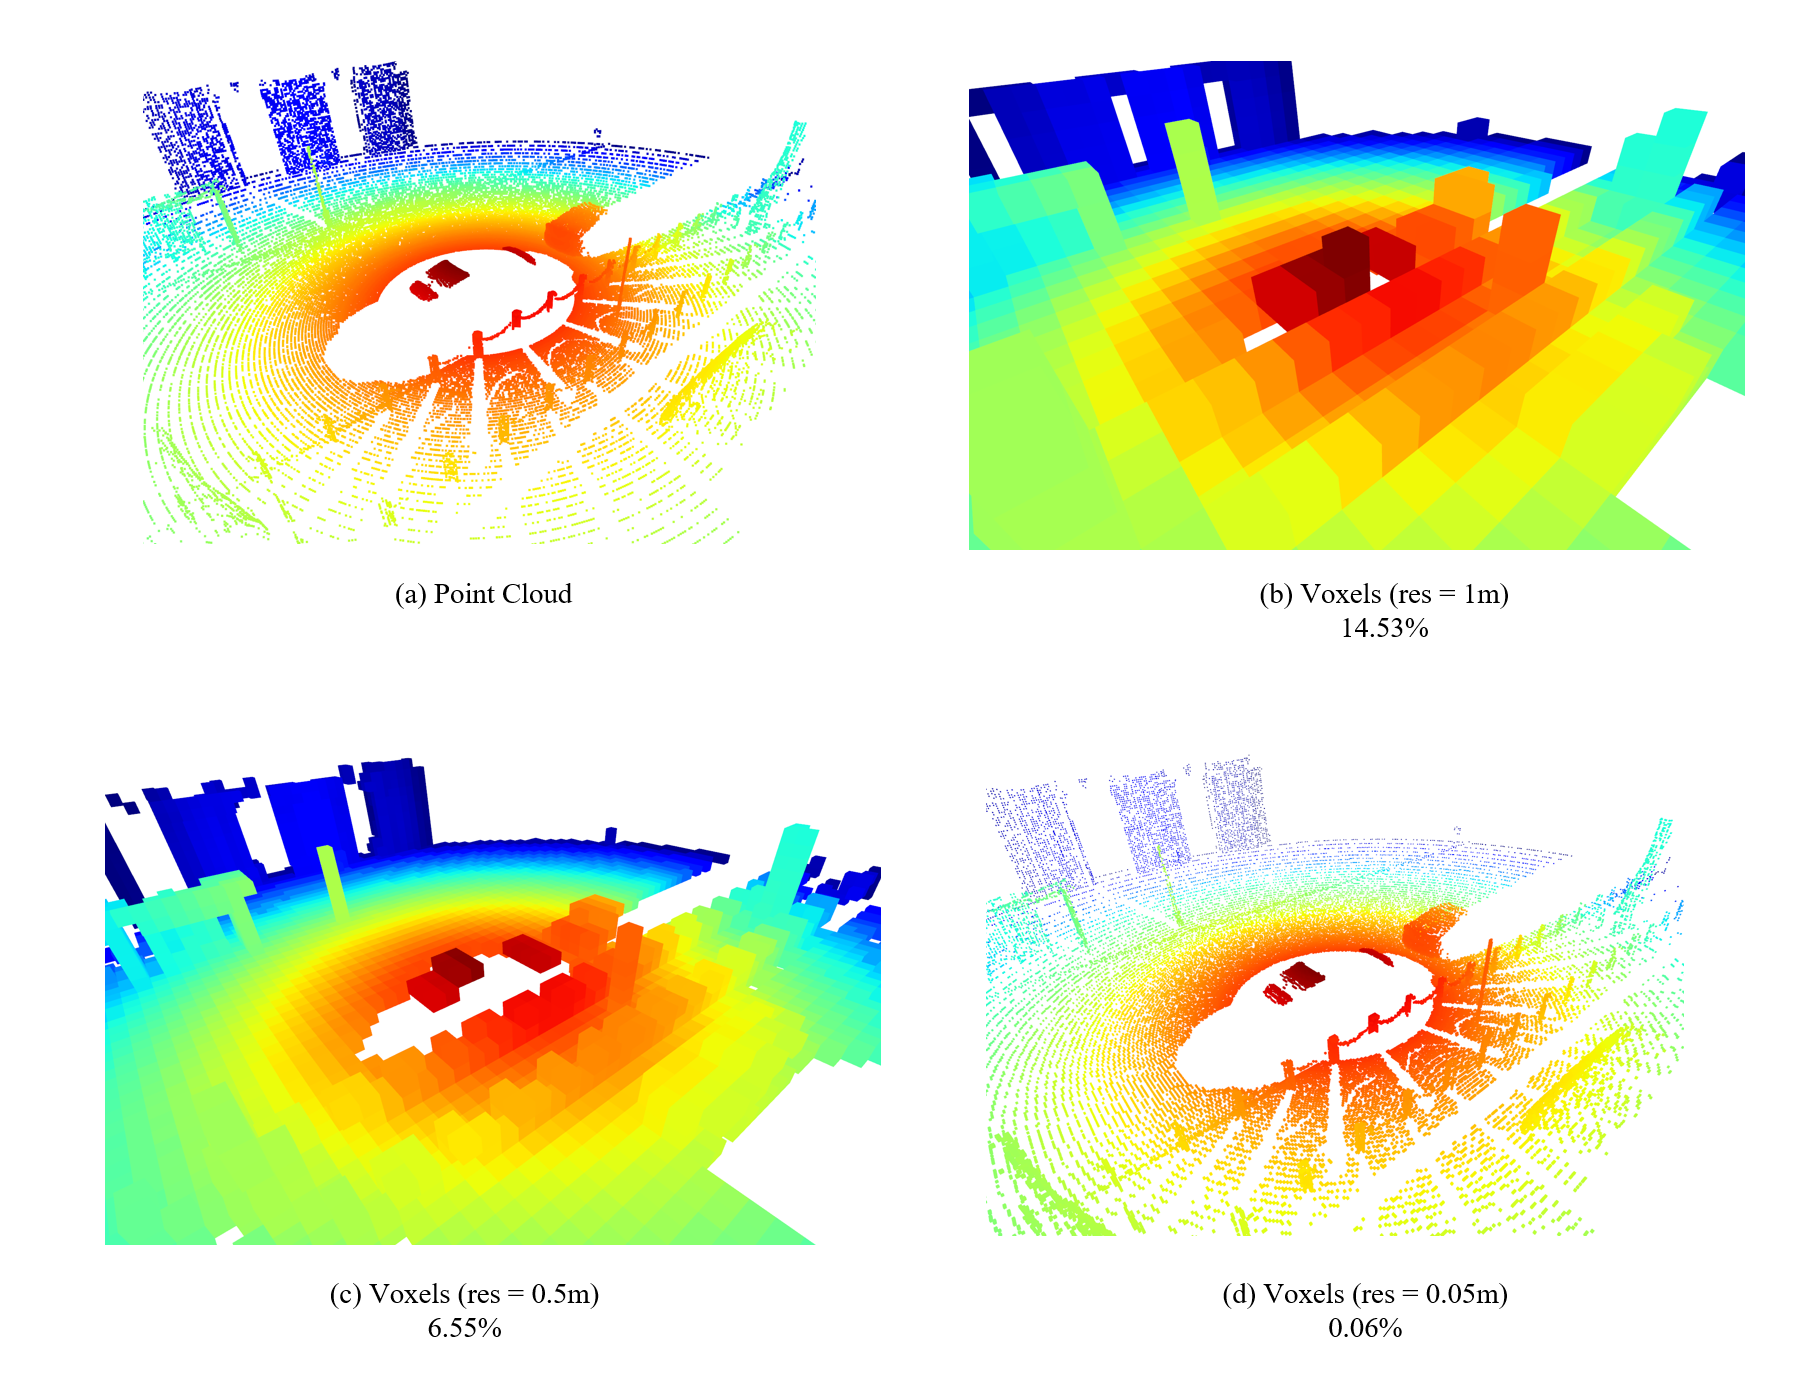
所以只表示有效体素的稀疏化表示就这样提出了,这种表示有效降低了内存的冗余,并加速了对体素的处理。
稀疏卷积
最常用的稀疏卷积分为Spatially Sparse Convolution(SparseConv)和Submanifold Sparse Convolution(SubMConv),前者是常规卷积操作的稀疏化版本,后者是保证不破坏特征图稀疏度的卷积操作。
现代通用版本的SparseConv实现出自于SECOND: Sparsely Embedded Convolutional Detection
SubMConv出自于3D Semantic Segmentation with Submanifold Sparse Convolutional Networks
稀疏卷积主要分为四个步骤:
- 张量稀疏化
- 建立indice pair
- 稀疏特征收集
- 稀疏卷积计算
稀疏卷积
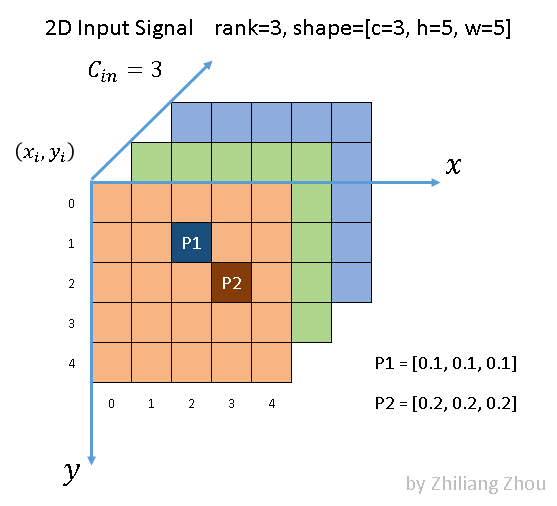
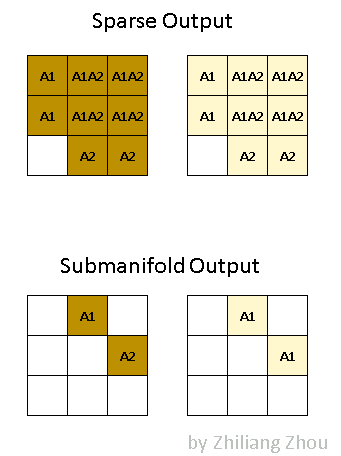
我们给出一个简单的稀疏卷积例子
如下图所示,P1与P2两个输入分别在SparseConv与SubMConv所关联的输出为A1与A2
张量稀疏化
张量稀疏化就是顾名思义将一个张量从稠密表示形式变换为稀疏表示形式,我们给出常用的COO内存的定义,给定一个张量\(\mathbf X\in \mathbf{R}^{N_1\times N_2\times\cdots \times N_m}\)与稀疏维度\(d\ge1\),得到一个索引\(\mathbf{I}\in\mathbf{R}^{n\times d}\)以及值\(\mathbf{V}\in\mathbf{R}^{n\times N_{d+1}\times\cdots \times N_m}\),其中\(n\ge 0\)为张量中的非\(0\)量的数量
- 给定\(\mathbf X\in\mathbf{R}^{2\times 2} = \begin{bmatrix} 0 & 2 \\ 3 & 0 \end{bmatrix}\),\(d=2\),得到\(\mathbf I\in{2\times 2} =\text{[[0, 1], [1, 0]]}\)以及\(\mathbf{V}\in\mathbf{R}^{2}=\text{[2., 3.]}\)
- 给定\(\mathbf X\in\mathbf{R}^{2\times 2\times 2} = \begin{bmatrix} \begin{bmatrix} 0 & 0 \\ 1 & 2 \end{bmatrix} \\ \begin{bmatrix} 0 & 0 \\ 3 & 4 \end{bmatrix} \end{bmatrix}\),\(d=2\),得到\(\mathbf I\in{2\times 2} =\text{[[0, 1], [1, 1]]}\)以及\(\mathbf{V}\in\mathbf{R}^{2\times2}=\text{[[1., 2.],[3., 4.]]}\)
五种内存管理形式
建立indice pair
在输入中,稀疏矩阵中非空量我们称为active input (actIn),那么每个actIn在输出中存在关联的量称为active output (actOut)
indice pair是一个\(k\times n\)的表结构,每个元素是一个索引对\((i, j)\),表示的是\(\text{actIn}[i]\)乘以卷积核中的第\(k\)个权重,其结果输出到\(\text{actOut}[j]\)中,建立indice pair如下进行:
初始化actOut
计算actIn所关联的每个actOut
给定一个\(\text{actIn}[i]=(x,y)\),可以算出每个输出坐标\((x^\prime,y^\prime)\)以及其对应卷积核位移\(k\)
在actOut寻找\((x^\prime,y^\prime)\)是否存在,没有就开辟一个新空间,返回其索引\(j\)
建立索引indicePair[k].append(i,j)
可以如下写成伪代码形式:
vector[K] get_indice_pair(act_in: vector, act_out: vector) {

    initialize indice_pair = vector[K];

    for i in enumerate(act_in.length()) {

        pos_act_In = act_in[i];

        for k, {x, y} in get_valid_out_pos(pos_act_In) {

            j = act_out.find({x, y});

            if(j == -1) {

                j = act_out.length();

                act_out.append({x, y});

            }

            indice_pair[k].append({i, j});

        }

    }

    return indice_pair;

}
如果是SubMConv操作,在get_valid_out_pos中检查输出坐标在输入所对应的坐标中是否为actIn,否则过滤掉即可
注意:这里只是为了方便理解把indice pair写成了\(k\times n\)的表,实际indice pair一般都是一张\(2\times k\times n\)的表,其中\(\text{indice_pair}(0,k,n)=i,\ \text{indice_pair}(1,k,n)=j\),这样在特征收集与计算阶段就只需要读入半张表,提高性能
稀疏特征收集
这一步的目的在于通过indice_pair收集读入指定位置的特征feats,用于下一步的卷积计算。我们可以用公式表示:
\]
稀疏卷积计算
稀疏卷积计算分为两步:相乘与求和
相乘阶段
相乘阶段的目的在于将特征feats与指定位置的权重相乘
\[\text{feats}^\prime\in \mathbf{R}^{k\times n\times f} = \text{feats} \in\mathbf{R}^{k\times n\times f} \odot \text{kernal}\in \mathbf{R}^{k}
\]其中$\odot $是逐元素乘积
求和阶段
将上一阶段相乘的特征进行求和
\[\mathbf I = \text{actOut},\mathbf{V}(j)=\sum_{k}\text{feats}^\prime(k,n) \\\text{where}\ \text{indice_pair}[n]=\{i, j\}
\]可以如下写成伪代码形式:
vector[K] sparse_scatter_add_cpu(act_out: vector[N], indice_pair: vector[K], feats: Tensor[k, n, f], kernal[k]) {

    feats = feats * kernal; \\Tensor[k, n, f]

    value = tensor::zeros((act_out.length(), feats.size(2))); \\Initialize a full 0 Tensor with size [N, f]

    for k in range(K) {

        for index in range(indice_pair[k].length()) {

            {i, j} = indice_pair[k, index];

            value[j] += feats[k, index];

    	}

    }

    return value;

}
并行版本的稀疏卷积
参考文献
目标检测 | Spatially Sparse Convolution的更多相关文章
- QueryDet: Cascaded Sparse Query for Accelerating High-Resolution Small Object Detection(QueryDet:用于加速高分辨率小目标检测的级联稀疏查询)
QueryDet: Cascaded Sparse Query for Accelerating High-Resolution Small Object Detection(QueryDet:用于加 ...
- CVPR2020论文解读:3D Object Detection三维目标检测
CVPR2020论文解读:3D Object Detection三维目标检测 PV-RCNN:Point-Voxel Feature Se tAbstraction for 3D Object Det ...
- 目标检测----ImageAI使用
1.开源项目 github地址 https://github.com/OlafenwaMoses/ImageAI 2.目标检测(Object Detection)入门概要 3.Pycharm中无法 ...
- (转)如何用TensorLayer做目标检测的数据增强
数据增强在机器学习中的作用不言而喻.和图片分类的数据增强不同,训练目标检测模型的数据增强在对图像做处理时,还需要对图片中每个目标的坐标做相应的处理.此外,位移.裁剪等操作还有可能使得一些目标在处理后只 ...
- 目标检测网络之 R-FCN
R-FCN 原理 R-FCN作者指出在图片分类网络中具有平移不变性(translation invariance),而目标在图片中的位置也并不影响分类结果;但是检测网络对目标的位置比较敏感.因此Fas ...
- 从YOLOv1到YOLOv3,目标检测的进化之路
https://blog.csdn.net/guleileo/article/details/80581858 本文来自 CSDN 网站,作者 EasonApp. 作者专栏: http://dwz.c ...
- 目标检测算法—YOLO-V1
为什么会叫YOLO呢? YOLO:you only look once.只需要看一眼,就可以检测识别出目标,主要是突出这个算法 快 的特点.(原文:Yolo系列之前的文章:主要是rcnn系列的,他们的 ...
- [转]CNN目标检测(一):Faster RCNN详解
https://blog.csdn.net/a8039974/article/details/77592389 Faster RCNN github : https://github.com/rbgi ...
- [DeeplearningAI笔记]卷积神经网络3.1-3.5目标定位/特征点检测/目标检测/滑动窗口的卷积神经网络实现/YOLO算法
4.3目标检测 觉得有用的话,欢迎一起讨论相互学习~Follow Me 3.1目标定位 对象定位localization和目标检测detection 判断图像中的对象是不是汽车--Image clas ...
- 语义分割(semantic segmentation) 常用神经网络介绍对比-FCN SegNet U-net DeconvNet,语义分割,简单来说就是给定一张图片,对图片中的每一个像素点进行分类;目标检测只有两类,目标和非目标,就是在一张图片中找到并用box标注出所有的目标.
from:https://blog.csdn.net/u012931582/article/details/70314859 2017年04月21日 14:54:10 阅读数:4369 前言 在这里, ...
随机推荐
- 小程序 构建npm
1. 在项目文件夹下 打开cmd 窗口,输入: npm init 一直回车即可 2. 安装模板 npm i @vant/weapp -S --production 3. 在微信开发者工具,左上角工具中 ...
- JEP 457 Java 22:Class-File API
查看 Java 22:Class-File API | 作者:Ben Weidig | 2024 年 4 月 | Medium 终于有一个和 DLR 相当的官方库了.
- Docker封装Java环境镜像(Alpine+OpenJDK)
在给Java程序封装镜像时,使用的基础镜像动辄上百M,还需要每次部署的时候挂载时区等问题,不如自己封装一个镜像,供之后使用. 这里使用Alpine Linux(3.9) 安装OpenJDK 1.8及部 ...
- unsupported message type: DefaultFullHttpResponse (expected: ByteBuf, FileRegion) 原因以及解决办法
使用netty做http服务器的时候 用android链接 会出现这个错误 原因是http-aggregator顺序有问题 (ps:目前大部分国内博客都是这个排序有点坑爹): 官方文档说明:For c ...
- Qt编写视频监控系统78-视频推流到流媒体服务器
一.前言 视频推流作为独立的模块,目前并没有集成到视频监控系统中,目前是可以搭配监控系统一起使用,一般是将添加好的摄像头通道视频流地址打开后,读取视频流重新推到流媒体服务器,然后第三方可以从流媒体服务 ...
- Qt编写地图综合应用45-路径规划
一.前言 路径规划一般是根据起始点坐标经纬度和结束点坐标经纬度,查询出合适的路线.关于起始坐标和结束坐标,最开始做的是直接传入具体中文地址即可,后面百度地图不再开放此功能,貌似变成了收费功能,但是经纬 ...
- 基于AT89C51的数字时钟课程设计
摘要:单片微型计算机简称单片机,又称为微控制器,是将CPU.RAM.ROM.定时/计数器.I/O接口电路集成到一块电路芯片上构成的微型计算机.本次设计的系统由单片机系统.数码管显示系统.键盘.蜂鸣器等 ...
- 直播预览层(AVCaptureVideoPreviewLayer)底层实现
分析sampleBuffer(帧数据) 通过设置AVCaptureVideoDataOutput的代理,就能获取捕获到一帧一帧数据 [videoOutput setSampleBufferDelega ...
- biancheng-NumPy教程
目录http://c.biancheng.net/numpy/ 1NumPy是什么2NumPy下载与安装3NumPy ndarray对象4NumPy数据类型5NumPy数组属性6Numpy创建数组7N ...
- HElib
什么是HElib? HElib是一个基于C++语言的同态加密开源软件库,底层依赖于NTL数论运算库和GMP多精度运算库实现,主要开发者为IBM的Halevi,目前最新版本为1.0.2,实现了支持&qu ...