
flink 1.10.0源码编译
1.安装git
yum -y install git
2.安装maven
安装了3.3以下低版本的maven会有提示升级,这里安装3.6.3
tar zxvf apache-maven-3.6.3-bin.tar.gz
cd apache-maven-3.6.3/
vi conf/settings.xml
增加以下mirror,下载依赖会快很多
<mirror>

    <id>nexus-aliyun</id>

    <mirrorOf>*,!jeecg,!jeecg-snapshots,!mapr-releases</mirrorOf>

    <name>nexus aliyun</name>

    <url>https://maven.aliyun.com/nexus/content/groups/public</url>

</mirror>

<mirror>

    <id>mapr-aliyun</id>

    <mirrorOf>mapr-releases</mirrorOf>

    <name>mapr-releases</name>

    <url>https://maven.aliyun.com/repository/content/mapr-public</url>

</mirror>
3.拉代码
git clone https://github.com/apache/flink.git
进入到 flink目录后,切换到需要打包的分支
git checkout release-1.10.0
mvn clean install -DskipTests -Dhadoop.version=2.6.5 -Dmaven.javadoc.skip=true -DCheckStyle.skip=true -Drat.skip=true -Dscala.version=2.11.8
然后就开始编译了
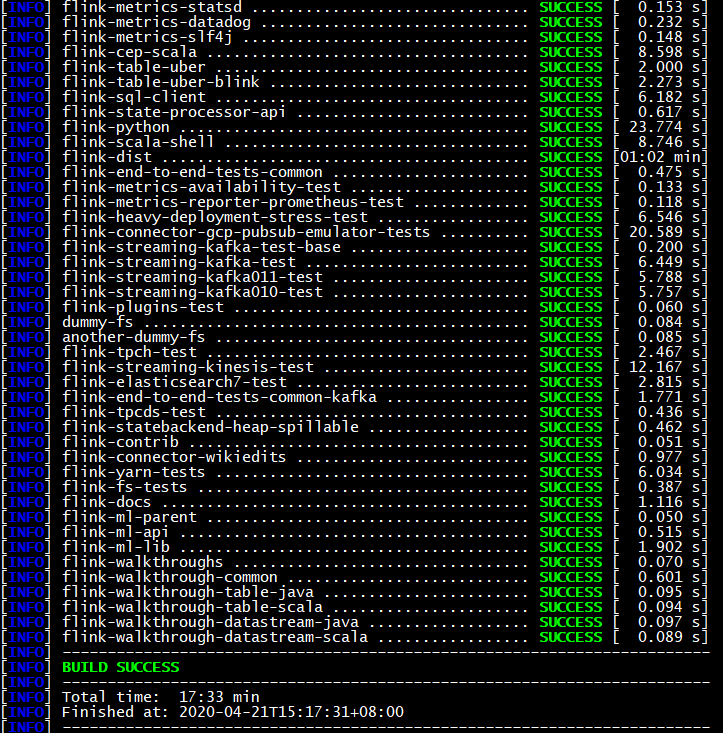
第一次编译,如果运气好,半个小时左右能完成,但是通常会遇到各种各样的问题,在解决问题后编译成功花费了17多分钟
问题解决
1.报错缺少kafka-schema-registry-client-3.3.1.jar 包
[ERROR] Failed to execute goal on project flink-avro-confluent-registry: Could not resolve dependencies for project org.apache.flink:flink-avro-confluent-registry:jar:1.6.2: Could not find artifact io.confluent:kafka-schema-registry-client:jar:3.3.1 in nexus-osc (http://maven.aliyun.com/nexus/content/repositories/central) -> [Help 1]
手动下载kafka-schema-registry-client-3.3.1.jar包,下载地址如下:
将下载的kafka-schema-registry-client-3.3.1.jar上传至主节点的目录下/home/tmp/
手动安装缺少的kafka-schema-registry-client-3.3.1.jar包
mvn install:install-file -DgroupId=io.confluent -DartifactId=kafka-schema-registry-client -Dversion=3.3.1 -Dpackaging=jar -Dfile=/home/tmp/kafka-schema-registry-client-3.3.1.jar
1.安装git
yum -y install git
2.安装maven
安装了3.3以下低版本的maven会有提示升级,这里安装3.6.3
tar zxvf apache-maven-3.6.3-bin.tar.gz
cd apache-maven-3.6.3/
vi conf/settings.xml
增加以下mirror,下载依赖会快很多
<mirror> <id>nexus-aliyun</id> <mirrorOf>*,!jeecg,!jeecg-snapshots,!mapr-releases</mirrorOf> <name>nexus aliyun</name></mirror><mirror> <id>mapr-aliyun</id> <mirrorOf>mapr-releases</mirrorOf> <name>mapr-releases</name></mirror> |
3.拉代码
git clone http://gitlab.xxx.com/dataplatform/flink-1.10.git
输入用户名和密码
切换到需要打包的分支
git checkout dev
mvn clean install -DskipTests -Dhadoop.version=2.6.5 -Dmaven.javadoc.skip=true -DCheckStyle.skip=true -Drat.skip=true -Dscala.version=2.11.8
然后就开始编译了
第一次编译,如果运气好,半个小时左右能完成,但是通常会遇到各种各样的问题,在解决问题后编译成功花费了17多分钟
flink 1.10.0源码编译的更多相关文章
- Spark1.0.0 源码编译和部署包生成
问题导读:1.如何对Spark1.0.0源码编译?2.如何生成Spark1.0的部署包?3.如何获取包资源? Spark1.0.0的源码编译和部署包生成,其本质只有两种:Maven和SBT,只不过针对 ...
- hadoop-1.2.0源码编译
以下为在CentOS-6.4下hadoop-1.2.0源码编译步骤. 1. 安装并且配置ant 下载ant,将ant目录下的bin文件夹加入到PATH变量中. 2. 安装git,安装autoconf, ...
- hadoop-2.6.0源码编译问题汇总
在上一篇文章中,介绍了hadoop-2.6.0源码编译的一般流程,因个人计算机环境的不同, 编译过程中难免会出现一些错误,下面是我编译过程中遇到的错误. 列举出来并附上我解决此错误的方法,希望对大家有 ...
- ambari 2.5.0源码编译安装
参考:https://www.ibm.com/developerworks/cn/opensource/os-cn-bigdata-ambari/index.html Ambari 是什么 Ambar ...
- hadoop-2.0.0-mr1-cdh4.2.0源码编译总结
准备编译hadoop-2.0.0-mr1-cdh4.2.0的同学们要谨慎了.首先看一下这篇文章: Hadoop作业提交多种方案 http://www.blogjava.net/dragonHadoop ...
- Ubantu16.04进行Android 8.0源码编译
参考这篇博客 经过测试,8.0源码下载及编译之后,占用100多G的硬盘空间,尽量给ubantu系统多留一些硬盘空间,如果后续需要在编译好的源码上进行开发,需要预留更多的控件,为了防止后续出现文件权限问 ...
- Spark2.0.0源码编译
Hive默认使用MapReduce作为执行引擎,即Hive on mr,Hive还可以使用Tez和Spark作为其执行引擎,分别为Hive on Tez和Hive on Spark.由于MapRedu ...
- Tomcat8.0源码编译
最近打算开始研究一下Tomcat的工作原理,拜读一下源码.所以先从编译源码开始了.尽管网上有那么多的资料,但是总是觉得,自己研究一遍,写一遍,在动手做一遍能够让我们更加深入的了解.现在整个社会都流行着 ...
- 使用Maven将Hadoop2.2.0源码编译成Eclipse项目
编译环境: OS:RHEL 6.3 x64 Maven:3.2.1 Eclipse:Juno SR2 Linux x64 libprotoc:2.5.0 JDK:1.7.0_51 x64 步骤: 1. ...
- jmeter4.0 源码编译 二次开发
准备: 1.jmeter4.0源码 - apache-jmeter-4.0_src.zip 2.IDE Eclipse - Oxygen.3 Release (4.7.3) 3.JDK - 1.8.0 ...
随机推荐
- 【随笔记】Littlevgl 8.x 踩过的坑
在多线程并发使用的时候,总是在运行过程中莫名其妙的 crash,后面才意识到 LVGL 本身不支持并发,加了互斥锁解决了. 在引入矢量字库时(freetype),又有启动时会概率性 crash 的问题 ...
- c++ 递推算法
各位大佬不妨先点个赞再看文章! 递推法是一种重要的数学方法,在数学的各个领域中都有广泛的运用,也是计算机用于数值计算的一个重要算法.这种算法特点是:一个问题的求解需一系列的计算,在已知条件和所求问题之 ...
- 聊聊JUC包下的底层支撑类-AbstractQueuedSynchronizer(AQS)
聊聊JUC包下的底层支撑类-AbstractQueuedSynchronizer(AQS) juc包下的一堆并发工具类是我们日常开发特别是面试中常被拿来问的八股文之一,为了工作也好,为了面试也罢,今天 ...
- Python学习常见问题及其解决方案(1)
1.ModuleNotFoundError: No module named 'urllib2' 解决方案: 1)https://blog.csdn.net/weixin_45598506/artic ...
- 【TS】函数和函数类型
在使用函数的时候,通常会给函数传值,或者给函数一个返回值调用,这个时候就会涉及到函数类型. 函数类型分为两个方面: 1.函数参数 2.函数返回值 语法: function 函数名( 参数 : 参数类型 ...
- JZOJ 1082. 【GDOI2005】选址
\(\text{Problem}\) 很久以前,在世界的某处有一个形状为凸多边形的小岛,岛上的居民们决定建一个祭坛,居民们任务祭坛的位置离岛的顶点处越远越好. 你的任务是求凸多边形内一点,使其与各顶点 ...
- AKS for Gitpod
------实习期间做的一个小项目 距今一个多月两个月----------------- 1.First Week local k8s 命令行:kubectl 运行Kubernetes: kind,m ...
- 图文指南 篇二:虚拟机ESXi6.7安装黑群晖教程
转载:什么值得买 (ESXI虚拟机是非常好用的多开虚拟机是VM系列非常强的) https://post.smzdm.com/p/agd8l34w/#:~:text=7%E5%AE%89%E8%A3%8 ...
- Windows下小狼毫配置五笔拼音方案
Windows下小狼毫配置五笔拼音方案 目录 Windows下小狼毫配置五笔拼音方案 1 下载并安装小狼毫rime 2 配置五笔.五笔拼音方案 3 安装设置五笔拼音混合输入 4 设置输入方案 1 下载 ...
- vue data为什么是函数
vue data是函数的原因: 1.防止data复用: 2.data独立性: 3.作用域: 4.js的特性. 总结来说,如果data是一个函数的话,这样每复用一次组件,就会返回一份新的data(类似于 ...