
java.net.ConnectException: Your endpoint configuration is wrong; For more details see: http://wiki.apache.org/hadoop/UnsetHostnameOrPort
今天使用在hive中建表,并在hive中将查询到的语句插入到新表中时,一直开在如图所示位置不动
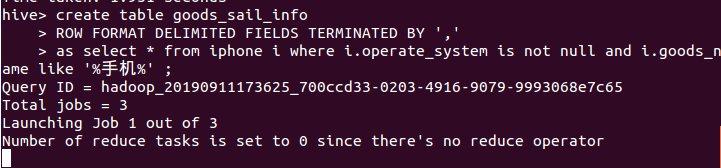
等待了20多分钟,然后报了这么个错
java.net.ConnectException: Your endpoint configuration is wrong; For more details see: http://wiki.apache.org/hadoop/UnsetHostnameOrPort
   at sun.reflect.GeneratedConstructorAccessor49.newInstance(Unknown Source)

    at sun.reflect.DelegatingConstructorAccessorImpl.newInstance(DelegatingConstructorAccessorImpl.java:45)

    at java.lang.reflect.Constructor.newInstance(Constructor.java:423)

    at org.apache.hadoop.net.NetUtils.wrapWithMessage(NetUtils.java:824)

    at org.apache.hadoop.net.NetUtils.wrapException(NetUtils.java:750)

    at org.apache.hadoop.ipc.Client.getRpcResponse(Client.java:1497)

    at org.apache.hadoop.ipc.Client.call(Client.java:1439)

    at org.apache.hadoop.ipc.Client.call(Client.java:1349)

    at org.apache.hadoop.ipc.ProtobufRpcEngine$Invoker.invoke(ProtobufRpcEngine.java:227)

    at org.apache.hadoop.ipc.ProtobufRpcEngine$Invoker.invoke(ProtobufRpcEngine.java:116)

    at com.sun.proxy.$Proxy77.getNewApplication(Unknown Source)

    at org.apache.hadoop.yarn.api.impl.pb.client.ApplicationClientProtocolPBClientImpl.getNewApplication(ApplicationClientProtocolPBClientImpl.java:262)

    at sun.reflect.GeneratedMethodAccessor5.invoke(Unknown Source)

    at sun.reflect.DelegatingMethodAccessorImpl.invoke(DelegatingMethodAccessorImpl.java:43)

    at java.lang.reflect.Method.invoke(Method.java:498)

    at org.apache.hadoop.io.retry.RetryInvocationHandler.invokeMethod(RetryInvocationHandler.java:422)

    at org.apache.hadoop.io.retry.RetryInvocationHandler$Call.invokeMethod(RetryInvocationHandler.java:165)

    at org.apache.hadoop.io.retry.RetryInvocationHandler$Call.invoke(RetryInvocationHandler.java:157)

    at org.apache.hadoop.io.retry.RetryInvocationHandler$Call.invokeOnce(RetryInvocationHandler.java:95)

    at org.apache.hadoop.io.retry.RetryInvocationHandler.invoke(RetryInvocationHandler.java:359)

    at com.sun.proxy.$Proxy78.getNewApplication(Unknown Source)

    at org.apache.hadoop.yarn.client.api.impl.YarnClientImpl.getNewApplication(YarnClientImpl.java:236)

    at org.apache.hadoop.yarn.client.api.impl.YarnClientImpl.createApplication(YarnClientImpl.java:244)

    at org.apache.hadoop.mapred.ResourceMgrDelegate.getNewJobID(ResourceMgrDelegate.java:193)

    at org.apache.hadoop.mapred.YARNRunner.getNewJobID(YARNRunner.java:265)

    at org.apache.hadoop.mapreduce.JobSubmitter.submitJobInternal(JobSubmitter.java:159)

    at org.apache.hadoop.mapreduce.Job$11.run(Job.java:1570)

    at org.apache.hadoop.mapreduce.Job$11.run(Job.java:1567)

    at java.security.AccessController.doPrivileged(Native Method)

    at javax.security.auth.Subject.doAs(Subject.java:422)

    at org.apache.hadoop.security.UserGroupInformation.doAs(UserGroupInformation.java:1889)

    at org.apache.hadoop.mapreduce.Job.submit(Job.java:1567)

    at org.apache.hadoop.mapred.JobClient$1.run(JobClient.java:576)

    at org.apache.hadoop.mapred.JobClient$1.run(JobClient.java:571)

    at java.security.AccessController.doPrivileged(Native Method)

    at javax.security.auth.Subject.doAs(Subject.java:422)

    at org.apache.hadoop.security.UserGroupInformation.doAs(UserGroupInformation.java:1889)

    at org.apache.hadoop.mapred.JobClient.submitJobInternal(JobClient.java:571)

    at org.apache.hadoop.mapred.JobClient.submitJob(JobClient.java:562)

    at org.apache.hadoop.hive.ql.exec.mr.ExecDriver.execute(ExecDriver.java:423)

    at org.apache.hadoop.hive.ql.exec.mr.MapRedTask.execute(MapRedTask.java:149)

    at org.apache.hadoop.hive.ql.exec.Task.executeTask(Task.java:205)

    at org.apache.hadoop.hive.ql.exec.TaskRunner.runSequential(TaskRunner.java:97)

    at org.apache.hadoop.hive.ql.Driver.launchTask(Driver.java:2664)

    at org.apache.hadoop.hive.ql.Driver.execute(Driver.java:2335)

    at org.apache.hadoop.hive.ql.Driver.runInternal(Driver.java:2011)

    at org.apache.hadoop.hive.ql.Driver.run(Driver.java:1709)

    at org.apache.hadoop.hive.ql.Driver.run(Driver.java:1703)

    at org.apache.hadoop.hive.ql.reexec.ReExecDriver.run(ReExecDriver.java:157)

    at org.apache.hadoop.hive.ql.reexec.ReExecDriver.run(ReExecDriver.java:218)

    at org.apache.hadoop.hive.cli.CliDriver.processLocalCmd(CliDriver.java:239)

    at org.apache.hadoop.hive.cli.CliDriver.processCmd(CliDriver.java:188)

    at org.apache.hadoop.hive.cli.CliDriver.processLine(CliDriver.java:402)

    at org.apache.hadoop.hive.cli.CliDriver.executeDriver(CliDriver.java:821)

    at org.apache.hadoop.hive.cli.CliDriver.run(CliDriver.java:759)

    at org.apache.hadoop.hive.cli.CliDriver.main(CliDriver.java:683)

    at sun.reflect.NativeMethodAccessorImpl.invoke0(Native Method)

    at sun.reflect.NativeMethodAccessorImpl.invoke(NativeMethodAccessorImpl.java:62)

    at sun.reflect.DelegatingMethodAccessorImpl.invoke(DelegatingMethodAccessorImpl.java:43)

    at java.lang.reflect.Method.invoke(Method.java:498)

    at org.apache.hadoop.util.RunJar.run(RunJar.java:239)

    at org.apache.hadoop.util.RunJar.main(RunJar.java:153)

Caused by: java.net.ConnectException: 拒绝连接

    at sun.nio.ch.SocketChannelImpl.checkConnect(Native Method)

    at sun.nio.ch.SocketChannelImpl.finishConnect(SocketChannelImpl.java:717)

    at org.apache.hadoop.net.SocketIOWithTimeout.connect(SocketIOWithTimeout.java:206)

    at org.apache.hadoop.net.NetUtils.connect(NetUtils.java:531)

    at org.apache.hadoop.ipc.Client$Connection.setupConnection(Client.java:687)

    at org.apache.hadoop.ipc.Client$Connection.setupIOstreams(Client.java:790)

    at org.apache.hadoop.ipc.Client$Connection.access$3500(Client.java:411)

    at org.apache.hadoop.ipc.Client.getConnection(Client.java:1554)

    at org.apache.hadoop.ipc.Client.call(Client.java:1385)

    ... 55 more

Job Submission failed with exception 'java.net.ConnectException(Your endpoint configuration is wrong; For more details see:  http://wiki.apache.org/hadoop/UnsetHostnameOrPort)'

FAILED: Execution Error, return code 1 from org.apache.hadoop.hive.ql.exec.mr.MapRedTask. Your endpoint configuration is wrong; For more details see:  http://wiki.apache.org/hadoop/UnsetHostnameOrPort
在百度的过程中我参考了一篇博客,他的说法是由于没有启动historyserver引起的,于是我就按照他的方法修改了mapred-site.xml,结果还是不行,
于是我就想到了我之前配置过yarn,在开启Hadoop的时候我输入的命令是./sbin/start-dfs.sh,并没有输入./sbin/start-all.sh
于是我就开启了yarn,结果就可以正常的查询插入了。
参考博客:https://www.cnblogs.com/cac2020/p/10274979.html
yarn基本概念:https://baike.baidu.com/item/yarn/16075826?fr=aladdin
java.net.ConnectException: Your endpoint configuration is wrong; For more details see: http://wiki.apache.org/hadoop/UnsetHostnameOrPort的更多相关文章
- 异常: Call From * 9000 failed on connection exception: java.net.ConnectException: Connection refused: no further information; For more details see: http://wiki.apache.org/hadoop/ConnectionRefused
场景: eclipse链接不上阿里云hadoop解决: 将hadoop的配置文件中的ip改为内网IP即可
- exception: java.net.ConnectException: Connection refused; For more details see: http://wiki.apache.org/hadoop/ConnectionRefused
1.虽然,不是大错,还说要贴一下,由于我运行run-example streaming.NetworkWordCount localhost 9999的测试案例,出现的错误,第一感觉就是Spark没有 ...
- java.net.ConnectException: Call From slaver1/192.168.19.128 to slaver1:8020 failed on connection exception: java.net.ConnectException: Connection refused; For more details see: http://wiki.apache.org
1:练习spark的时候,操作大概如我读取hdfs上面的文件,然后spark懒加载以后,我读取详细信息出现如下所示的错误,错误虽然不大,我感觉有必要记录一下,因为错误的起因是对命令的不熟悉造成的,错误 ...
- Exception in thread “main“ java.net.ConnectException: Call From
问题描述:#报错语句:FileSystem fs = FileSystem.get(new URI("hdfs://hadoop000:8020"),new Configurati ...
- Caused by: java.net.ConnectException: Call From master/192.168.199.130 to master:9000 failed on connection exception: java.net.ConnectException: Connection refused; For more details see: http://wiki.
1:安装好hive,准备启动的时候出现下面的错误(由于hive是基于Hadoop的,所以必须先将你的集群启动起来,我就是没有启动集群,直接启动hive导致的错误): [root@master bin] ...
- Call From master/192.168.128.135 to master:8485 failed on connection exception: java.net.ConnectException: Connection refused
hadoop集群搭建了ha,初次启动正常,最近几天启动时偶尔发现,namenode1节点启动后一段时间(大约10几秒-半分钟左右),namenode1上namenode进程停掉,查看日志: -- :: ...
- error: not found: value sqlContext/import sqlContext.implicits._/error: not found: value sqlContext /import sqlContext.sql/Caused by: java.net.ConnectException: Connection refused
1.今天启动启动spark的spark-shell命令的时候报下面的错误,百度了很多,也没解决问题,最后想着是不是没有启动hadoop集群的问题 ,可是之前启动spark-shell命令是不用启动ha ...
- hadoop报错:java.io.IOException(java.net.ConnectException: Call From xxx/xxx to xxx:10020 failed on connection exception: java.net.ConnectException: 拒绝连接
任务一直报错 现象比较奇怪,部分任务可以正常跑,部分问题报错 报错信息如下: Ended Job = job_1527476268558_132947 with exception 'java.io. ...
- ls: Call From hdoop2/192.168.18.87 to hdoop2:8020 failed on connection exception: java.net.ConnectException: 拒绝连接; For more details see
场景: 预发环境中,同事已经搭建了一套hadoop集群,由于版本与所需不符,所以需要替换版本 问题描述: 在配置文件都准确的情况下,启动hadoop,出现以下报错: 启动之前初始化: 初始化目录 ...
- Error: java.net.ConnectException: Call From tuge1/192.168.40.100 to tuge2:8032 failed on connection exception
先看解决方案,再看唠嗑,唠嗑可以忽略. 解决方案: 使用start yarn.sh启动yarn就可以了. 唠嗑: 今天学习Spark基于Yarn部署.然后总以为Yarn是让Spark启动的,提交程序的 ...
随机推荐
- avalonia实现自定义小弹窗
对于使用avalonia的时候某些功能需要到一些提示,比如异常或者成功都需要对用户进行提示,所以需要单独实现弹窗功能,并且可以自定义内部组件,这一期将手动实现一个简单的小弹窗,并且很容易自定义 创建项 ...
- Typora软件的使用、编程与编程语言、计算机基础、五大组成部分、三大核心硬件、操作系统
目录 一.Typora软件的下载与使用 (1).软件下载 (2).markdown语法 二.编程与编程语言 (1).什么是语言 (2).什么是编程 (3).什么是编程语言 三.计算机本质 四.计算机五 ...
- 高精度计算模板 -感谢acwing
高精度加 1 // C = A + B, A >= 0, B >= 0 2 vector<int> add(vector<int> &A, vector&l ...
- 重学SpringBoot. step7 高并发 秒杀
高并发 高并发最容易出现的问题就是数据安全能不能得到保障. 你需要保证速度,又需要保证数据安全,那么速度也必然会有所下降. 所以最简单的办法就是提升硬件.或者把Mysql换成MongoDB,加个Red ...
- 我让 ChatGPT 写了个 ChatGPT
这家伙实在是火得过头了,索性讲个它的故事. 去年11月份,OpenAI 推出了 ChatGPT. 这里就不赘述这个家喻户晓玩意的常识了. 要说刚开始也没多少人在意,一个聊天机器人-- 谁稀罕呐. 但 ...
- .NET 中的并发编程
今天我们购买的每台电脑都有一个多核心的 CPU,允许它并行执行多个指令.操作系统通过将进程调度到不同的内核来发挥这个结构的优点.然而,还可以通过异步 I/O 操作和并行处理来帮助我们提高单个应用程序的 ...
- 【OpenWrt】N1刷机过程及旁路由设置(通用)
最近买了个N1盒子,从源系统刷到OpenWrt,总结一下整体过程,大部分都来源于网络教程和自己实践,如有错误欢迎指出! N1盒子刷机 固件准备 最著名的应该是F大的吧,原贴地址:[2023-2-14] ...
- 10分钟了解MVVM,实现简易MVVM
MVVM 是 Model-View-ViewModel 缩写,也就是把 MVC 中的 Controller 演变成 ViewModel.Model 层代表数据模型,View 代表 UI 组件,View ...
- Ubuntu18.04编译ZLMediakit支持webrtc
背景 最近在做流媒体相关的一些东西, 比较了一些开源的流媒体服务, 目前 srs 和 ZlmediaKit 项目是评价比较高的, 今天主要在 Ubuntu18.04 上编译 ZlmediaKit, 并 ...
- Java 如何通过JDBC 操作数据库
JDBC 是Java 数据库连接,即 Java DataBase Connectivity.JDBC 可让Java 通过程序操作关系型数据库,可基于驱动程序实现与数据库的连接与操作.JDBC 有统一的 ...