
跟我一起hadoop(1)-hadoop2.6安装与使用
伪分布式
hadoop的三种安装方式:
安装之前需要
$ sudo apt-get install ssh
$ sudo apt-get install rsync
详见:http://hadoop.apache.org/docs/stable/hadoop-project-dist/hadoop-common/SingleCluster.html
伪分布式配置
Configuration
修改下边:
etc/hadoop/core-site.xml:
<configuration>

    <property>

        <name>fs.defaultFS</name>

        <value>hdfs://localhost:9000</value>

    </property>

</configuration>
etc/hadoop/hdfs-site.xml:
<configuration>

    <property>

        <name>dfs.replication</name>

        <value>1</value>

    </property>

</configuration>
配置ssh
  $ ssh-keygen -t dsa -P '' -f ~/.ssh/id_dsa

  $ cat ~/.ssh/id_dsa.pub >> ~/.ssh/authorized_keys
如果想运行在yarn上
需要执行下边的步骤:
- Configure parameters as follows:
etc/hadoop/mapred-site.xml:
<configuration>

    <property>

        <name>mapreduce.framework.name</name>

        <value>yarn</value>

    </property>

</configuration>
etc/hadoop/yarn-site.xml:
<configuration>

    <property>

        <name>yarn.nodemanager.aux-services</name>

        <value>mapreduce_shuffle</value>

    </property>

</configuration> - Start ResourceManager daemon and NodeManager daemon:
$ sbin/start-yarn.sh
- Browse the web interface for the ResourceManager; by default it is available at:
- ResourceManager - http://localhost:8088/
- Run a MapReduce job.
- When you're done, stop the daemons with:
$ sbin/stop-yarn.sh
输入:
可以看到
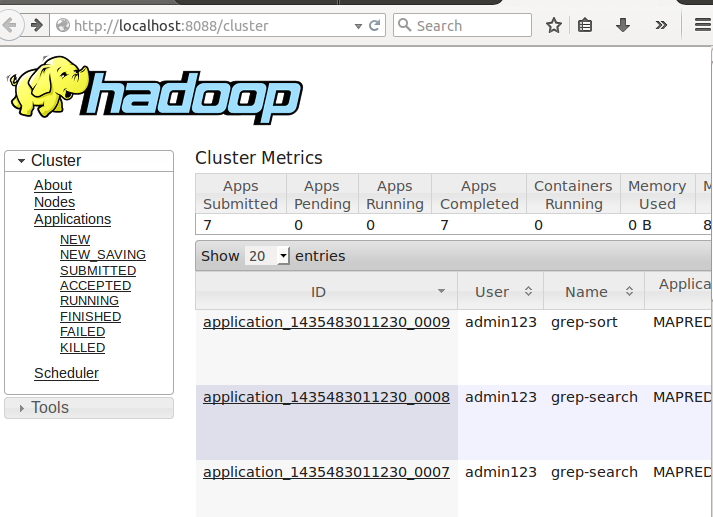
启动yarn后
- Format the filesystem:
$ bin/hdfs namenode -format
- Start NameNode daemon and DataNode daemon:
$ sbin/start-dfs.sh
The hadoop daemon log output is written to the $HADOOP_LOG_DIR directory (defaults to $HADOOP_HOME/logs).
- Browse the web interface for the NameNode; by default it is available at:
- NameNode - http://localhost:50070/
输入后得到:
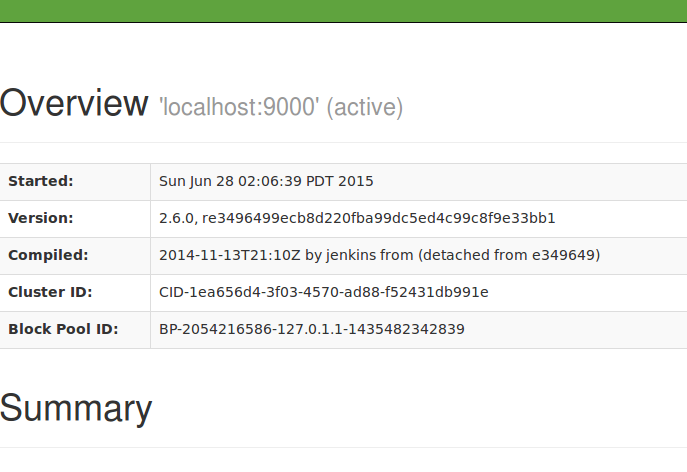
然后执行测试
- Make the HDFS directories required to execute MapReduce jobs:
  $ bin/hdfs dfs -mkdir /user

$ bin/hdfs dfs -mkdir /user/<username> - Copy the input files into the distributed filesystem:
$ bin/hdfs dfs -put etc/hadoop input
- Run some of the examples provided:
$ bin/hadoop jar share/hadoop/mapreduce/hadoop-mapreduce-examples-2.6.0.jar grep input output 'dfs[a-z.]+'
- Examine the output files:
Copy the output files from the distributed filesystem to the local filesystem and examine them:
  $ bin/hdfs dfs -get output output

  $ cat output/*
or
View the output files on the distributed filesystem:
$ bin/hdfs dfs -cat output/*
看运行的情况:
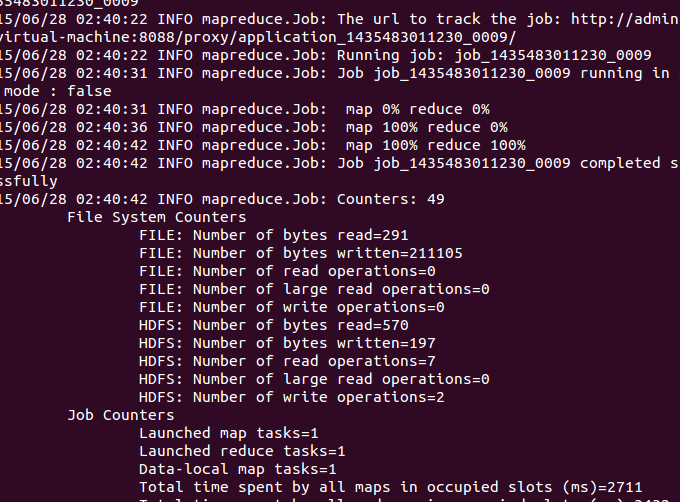
查看结果
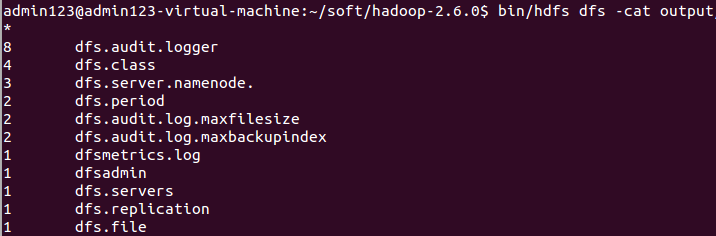
测试执行成功,可以编写本地代码了。
eclipse hadoop2.6插件使用
下载源码:
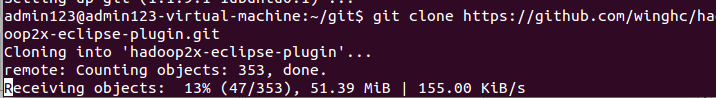
git clone https://github.com/winghc/hadoop2x-eclipse-plugin.git
下载过程:
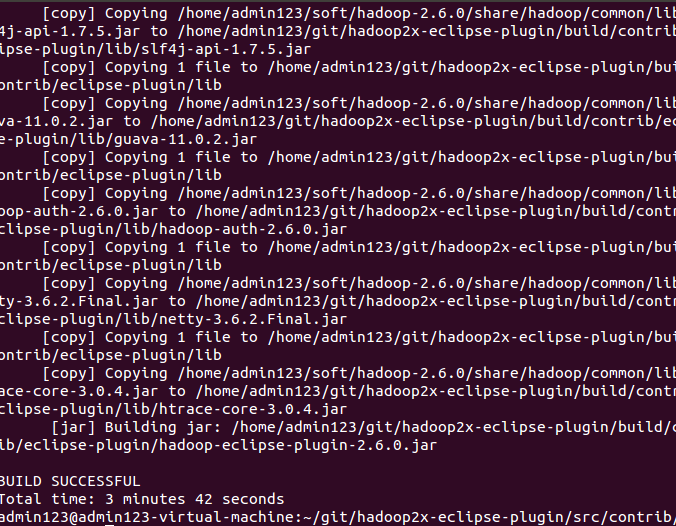
编译插件:
cd src/contrib/eclipse-plugin
ant jar -Dversion=2.6.0 -Declipse.home=/usr/local/eclipse -Dhadoop.home=/usr/local/hadoop-2.6.0 //路径根据自己的配置
- 复制编译好的jar到eclipse插件目录,重启eclipse
- 配置 hadoop 安装目录
window ->preference -> hadoop Map/Reduce -> Hadoop installation directory
- 配置Map/Reduce 视图
window ->Open Perspective -> other->Map/Reduce -> 点击“OK”
windows → show view → other->Map/Reduce Locations-> 点击“OK”
- 控制台会多出一个“Map/Reduce Locations”的Tab页
在“Map/Reduce Locations” Tab页 点击图标<大象+>或者在空白的地方右键,选择“New Hadoop location…”,弹出对话框“New hadoop location…”,配置如下内容:将ha1改为自己的hadoop用户
注意:MR Master和DFS Master配置必须和mapred-site.xml和core-site.xml等配置文件一致。
打开Project Explorer,查看HDFS文件系统。
- 新建Map/Reduce任务
File->New->project->Map/Reduce Project->Next
编写WordCount类:记得先把服务都起来
/**

 *

 */

package com.zongtui;

/**

 * ClassName: WordCount <br/>

 * Function: TODO ADD FUNCTION. <br/>

 * date: Jun 28, 2015 5:34:18 AM <br/>

 *

 * @author zhangfeng

 * @version

 * @since JDK 1.7

 */

import java.io.IOException;

import java.util.Iterator;

import java.util.StringTokenizer;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.LongWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapred.FileInputFormat;

import org.apache.hadoop.mapred.FileOutputFormat;

import org.apache.hadoop.mapred.JobClient;

import org.apache.hadoop.mapred.JobConf;

import org.apache.hadoop.mapred.MapReduceBase;

import org.apache.hadoop.mapred.Mapper;

import org.apache.hadoop.mapred.OutputCollector;

import org.apache.hadoop.mapred.Reducer;

import org.apache.hadoop.mapred.Reporter;

import org.apache.hadoop.mapred.TextInputFormat;

import org.apache.hadoop.mapred.TextOutputFormat;

public class WordCount {

    public static class Map extends MapReduceBase implements

            Mapper<LongWritable, Text, Text, IntWritable> {

        private final static IntWritable one = new IntWritable(1);

        private Text word = new Text();

        public void map(LongWritable key, Text value,

                OutputCollector<Text, IntWritable> output, Reporter reporter)

                throws IOException {

            String line = value.toString();

            StringTokenizer tokenizer = new StringTokenizer(line);

            while (tokenizer.hasMoreTokens()) {

                word.set(tokenizer.nextToken());

                output.collect(word, one);

            }

        }

    }

    public static class Reduce extends MapReduceBase implements

            Reducer<Text, IntWritable, Text, IntWritable> {

        public void reduce(Text key, Iterator<IntWritable> values,

                OutputCollector<Text, IntWritable> output, Reporter reporter)

                throws IOException {

            int sum = 0;

            while (values.hasNext()) {

                sum += values.next().get();

            }

            output.collect(key, new IntWritable(sum));

        }

    }

    public static void main(String[] args) throws Exception {

        JobConf conf = new JobConf(WordCount.class);

        conf.setJobName("wordcount");

        conf.setOutputKeyClass(Text.class);

        conf.setOutputValueClass(IntWritable.class);

        conf.setMapperClass(Map.class);

        conf.setReducerClass(Reduce.class);

        conf.setInputFormat(TextInputFormat.class);

        conf.setOutputFormat(TextOutputFormat.class);

        FileInputFormat.setInputPaths(conf, new Path(args[0]));

        FileOutputFormat.setOutputPath(conf, new Path(args[1]));

        JobClient.runJob(conf);

    }

}
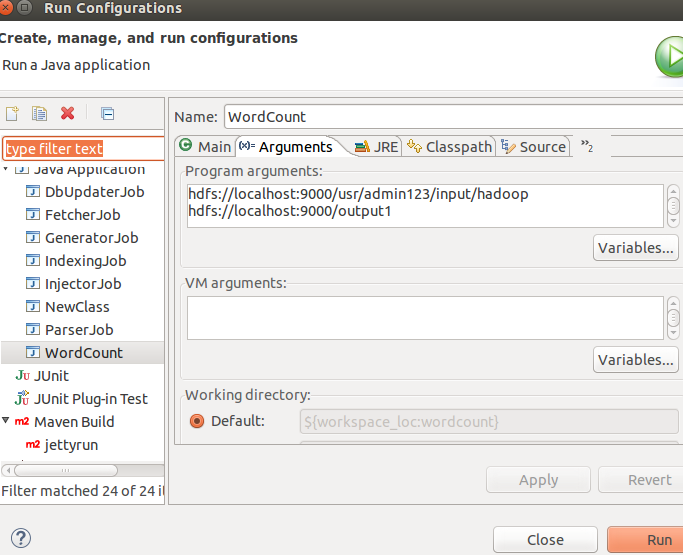
user/admin123/input/hadoop是你上传在hdfs的文件夹(自己创建),里面放要处理的文件。ouput1放输出结果
将程序放在hadoop集群上运行:右键-->Runas -->Run on Hadoop,最终的输出结果会在HDFS相应的文件夹下显示。至此,ubuntu下hadoop-2.6.0 eclipse插件配置完成。
遇到异常
Exception in thread "main" org.apache.hadoop.mapred.FileAlreadyExistsException: Output directory hdfs://localhost:9000/output already exists

    at org.apache.hadoop.mapred.FileOutputFormat.checkOutputSpecs(FileOutputFormat.java:132)

    at org.apache.hadoop.mapreduce.JobSubmitter.checkSpecs(JobSubmitter.java:564)

    at org.apache.hadoop.mapreduce.JobSubmitter.submitJobInternal(JobSubmitter.java:432)

    at org.apache.hadoop.mapreduce.Job$10.run(Job.java:1296)

    at org.apache.hadoop.mapreduce.Job$10.run(Job.java:1293)

    at java.security.AccessController.doPrivileged(Native Method)

    at javax.security.auth.Subject.doAs(Subject.java:415)

    at org.apache.hadoop.security.UserGroupInformation.doAs(UserGroupInformation.java:1628)

    at org.apache.hadoop.mapreduce.Job.submit(Job.java:1293)

    at org.apache.hadoop.mapred.JobClient$1.run(JobClient.java:562)

    at org.apache.hadoop.mapred.JobClient$1.run(JobClient.java:557)

    at java.security.AccessController.doPrivileged(Native Method)

    at javax.security.auth.Subject.doAs(Subject.java:415)

    at org.apache.hadoop.security.UserGroupInformation.doAs(UserGroupInformation.java:1628)

    at org.apache.hadoop.mapred.JobClient.submitJobInternal(JobClient.java:557)

    at org.apache.hadoop.mapred.JobClient.submitJob(JobClient.java:548)

    at org.apache.hadoop.mapred.JobClient.runJob(JobClient.java:833)

    at com.zongtui.WordCount.main(WordCount.java:83)

1、改变输出路径。
2、删除重新建。
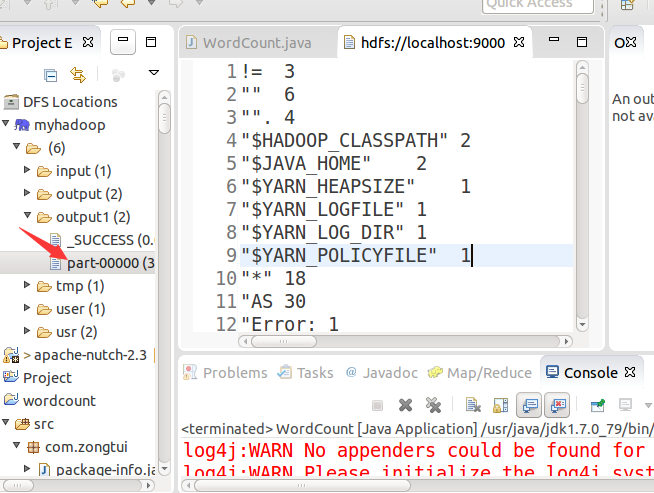
运行完成后看结果:
跟我一起hadoop(1)-hadoop2.6安装与使用的更多相关文章
- hadoop入门-centos7.2安装hadoop2.8
1. 安装准备 (1)必须安装jdk: 因为hadoop是基于Java实现的,所有必须安装jdk 是JDK不是jre jdk1.7 jdk1.8 (2)系统位数 (3)创建专用用户 useradd h ...
- Hadoop集群搭建安装过程(三)(图文详解---尽情点击!!!)
Hadoop集群搭建安装过程(三)(图文详解---尽情点击!!!) 一.JDK的安装 安装位置都在同一位置(/usr/tools/jdk1.8.0_73) jdk的安装在克隆三台机器的时候可以提前安装 ...
- 【原】Hadoop伪分布模式的安装
Hadoop伪分布模式的安装 [环境参数] (1)Host OS:Win7 64bit (2)IDE:Eclipse Version: Luna Service Release 2 (4.4.2) ( ...
- 完全分布式Hadoop2.3安装与配置
一.Hadoop基本介绍 Hadoop优点 1.高可靠性:Hadoop按位存储和处理数据 2.高扩展性:Hadoop是在计算机集群中完成计算任务,这个集群可以方便的扩展到几千台 3.高效性:Hadoo ...
- Hadoop集群环境安装
转载请标明出处: http://blog.csdn.net/zwto1/article/details/45647643: 本文出自:[zhang_way的博客专栏] 工具: 虚拟机virtual ...
- 基于zookeeper的高可用Hadoop HA集群安装
(1)hadoop2.7.1源码编译 http://aperise.iteye.com/blog/2246856 (2)hadoop2.7.1安装准备 http://aperise.iteye.com ...
- Hadoop分布式HA的安装部署
Hadoop分布式HA的安装部署 前言 单机版的Hadoop环境只有一个namenode,一般namenode出现问题,整个系统也就无法使用,所以高可用主要指的是namenode的高可用,即存在两个n ...
- hadoop完全分布式的安装
下载地址: centos 7.5 下载地址 清华 http://mirrors.tuna.tsinghua.edu.cn/centos/7/isos/x86_64/CentOS-7-x86_64-DV ...
- [转] Hadoop 2.0 详细安装过程
1. 准备 创建用户 useradd hadoop passwd hadoop 创建相关的目录 定义代码及工具存放的路径 mkdir -p /home/hadoop/source mkdir -p / ...
随机推荐
- 关于DOM的操作以及性能优化问题-重绘重排
写在前面: 大家都知道DOM的操作很昂贵. 然后贵在什么地方呢? 一.访问DOM元素 二.修改DOM引起的重绘重排 一.访问DOM 像书上的比喻:把DOM和JavaScript(这里指ECMScri ...
- ASP.NET Aries 入门开发教程6:列表数据表格的格式化处理及行内编辑
前言: 为了赶进度,周末也写文了! 前几篇讲完查询框和工具栏,这节讲表格数据相关的操作. 先看一下列表: 接下来我们有很多事情可以做. 1:格式化 - 键值的翻译 对于“启用”列,已经配置了格式化 # ...
- 来,给Entity Framework热热身
先来看一下Entity Framework缓慢的初始化速度给我们更新程序带来的一种痛苦. 我们手动更新程序时通常的操作步骤如下: 1)把Web服务器从负载均衡中摘下来 2)更新程序 3)预热(发出一个 ...
- 猫哥网络编程系列:HTTP PEM 万能调试法
注:本文内容较长且细节较多,建议先收藏再阅读,原文将在 Github 上维护与更新. 在 HTTP 接口开发与调试过程中,我们经常遇到以下类似的问题: 为什么本地环境接口可以调用成功,但放到手机上就跑 ...
- C#学习资源
# 视频 C#程序设计 Cousera(推荐) # 文档 C#教程 MSDN Microsoft API 和参考目录
- [原][Docker]特性与原理解析
Docker特性与原理解析 文章假设你已经熟悉了Docker的基本命令和基本知识 首先看看Docker提供了哪些特性: 交互式Shell:Docker可以分配一个虚拟终端并关联到任何容器的标准输入上, ...
- CSharpGL(33)使用uniform块来优化对uniform变量的读写
CSharpGL(33)使用uniform块来优化对uniform变量的读写 +BIT祝威+悄悄在此留下版了个权的信息说: Uniform块 如果shader程序变得比较复杂,那么其中用到的unifo ...
- 微软开源代码编辑器monaco-editor
官网上给出:”The Monaco Editor is the code editor that powers VS Code. A good page describing the code edi ...
- iOS 多线程之GCD的使用
在iOS开发中,遇到耗时操作,我们经常用到多线程技术.Grand Central Dispatch (GCD)是Apple开发的一个多核编程的解决方法,只需定义想要执行的任务,然后添加到适当的调度队列 ...
- Princeton Algorithms week3 Assignment
这周编程作业是实现检测点共线的算法.和排序算法有关系的地方在于,对斜率排序后可以很快的检测出来哪些点是共线的,另外这个算法的瓶颈也在于排序的性能. 一点收获: java传参数时传递的是值,这很多人都知 ...