
Hadoop之Flume 记录
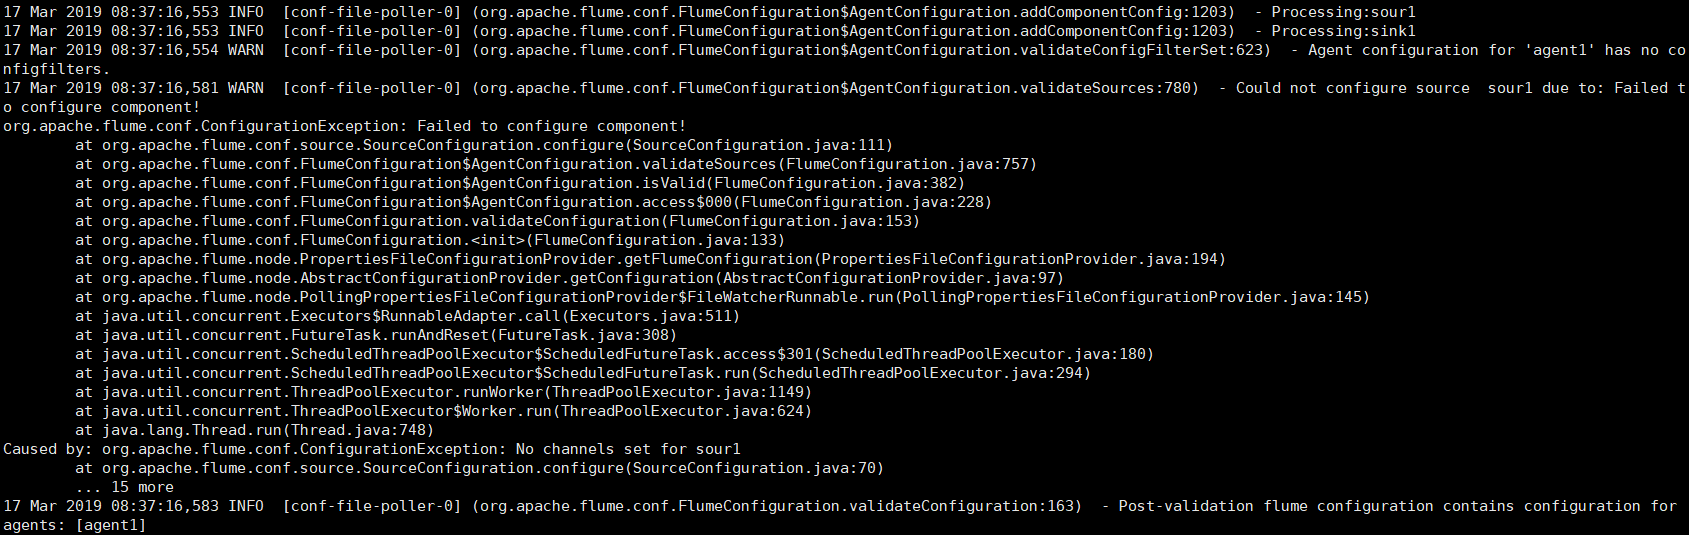
出现这个错误是自己的粗心大意,解决:
在配置flume-conf.properties文件时,source和channel的对应关系是:
myAgentName.sources.mySourceName.channels = myChannelName
myAgentName.sinks.mySinkName.channel = myChannelName
注意其中的后缀,带s和不带s后缀。
这也恰好说明
source可以“流向”多个channel,而sink只能接收一个channel的“流入”。
从channel的角度看:channel既可以接收多个source的“流入”,又可以“流向”多个sink
例如多对多关系:
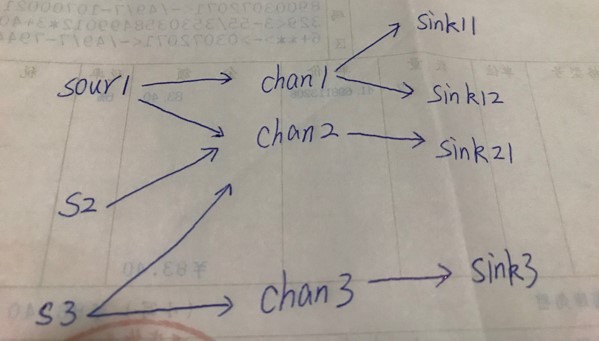
对应的配置如下:
 # example.conf: A single-node Flume configuration

 # Name the components on this agent

 agent1.sources=sour1 s2 s3

 agent1.sinks=sink1 sink12 sink21 sink3

 agent1.channels=chan1 chan2 chan3

 # Describe/configure the source

 agent1.sources.sour1.type=netcat

 agent1.sources.sour1.bind=localhost

 agent1.sources.sour1.port=44444

 agent1.sources.s2.type=netcat

 agent1.sources.s2.bind=localhost

 agent1.sources.s2.port=44445

 agent1.sources.s3.type=netcat

 agent1.sources.s3.bind=localhost

 agent1.sources.s3.port=44446

 # Describe the sink

 agent1.sinks.sink1.type=logger

 agent1.sinks.sink12.type=logger

 agent1.sinks.sink21.type=logger

 agent1.sinks.sink3.type=logger

 # Use a channel which buffers events in memory

 agent1.channels.chan1.type=memory

 agent1.channels.chan1.capacity=1000

 #agent1.channels.chan1.transactionCapacity=100

 agent1.channels.chan2.type=memory

 agent1.channels.chan2.capacity=1000

 agent1.channels.chan3.type=memory

 agent1.channels.chan3.capacity=1000

 # Bind the source and sink to the channel

 agent1.sources.sour1.channels=chan1 chan2

 agent1.sources.s2.channels=chan2

 agent1.sources.s3.channels=chan2 chan3

 agent1.sinks.sink1.channel=chan1

 agent1.sinks.sink12.channel=chan1

 agent1.sinks.sink21.channel=chan2

 agent1.sinks.sink3.channel=chan3
Hadoop之Flume 记录的更多相关文章
- Hadoop生态圈-Flume的主流source源配置
Hadoop生态圈-Flume的主流source源配置 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 本篇博客只是配置的是Flume主流的Source,想要了解更详细的配置信息请参 ...
- Hadoop生态圈-Flume的组件之自定义拦截器(interceptor)
Hadoop生态圈-Flume的组件之自定义拦截器(interceptor) 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 本篇博客只是举例了一个自定义拦截器的方法,测试字节传输速 ...
- Hadoop生态圈-Flume的组件之自定义Sink
Hadoop生态圈-Flume的组件之自定义Sink 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 本篇博客主要介绍sink相关的API使用两个小案例,想要了解更多关于API的小技 ...
- Hadoop生态圈-Flume的组件之sink处理器
Hadoop生态圈-Flume的组件之sink处理器 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一. 二.
- Hadoop生态圈-Flume的组件之拦截器与选择器
Hadoop生态圈-Flume的组件之拦截器与选择器 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 本篇博客只是配置的是Flume主流的Interceptors,想要了解更详细 ...
- Hadoop生态圈-Flume的主流Channel源配置
Hadoop生态圈-Flume的主流Channel源配置 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一. 二. 三.
- Hadoop生态圈-Flume的主流Sinks源配置
Hadoop生态圈-Flume的主流Sinks源配置 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 本篇博客只是配置的是Flume主流的Sinks,想要了解更详细的配置信息请参考官 ...
- Hadoop生态圈-flume日志收集工具完全分布式部署
Hadoop生态圈-flume日志收集工具完全分布式部署 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 目前为止,Hadoop的一个主流应用就是对于大规模web日志的分析和处理 ...
- Hadoop运维记录系列
http://slaytanic.blog.51cto.com/2057708/1038676 Hadoop运维记录系列(一) Hadoop运维记录系列(二) Hadoop运维记录系列(三) Hado ...
随机推荐
- Hadoop系列(一):Hadoop集群搭建
环境:CentOS 7 JDK: 1.7.0_80 hadoop:2.8.5 两台机器:master(192.168.56.101) slave(192.168.56.102) 配置基础环境 1. ...
- Keras 获取中间某一层输出
1.使用函数模型API,新建一个model,将输入和输出定义为原来的model的输入和想要的那一层的输出,然后重新进行predict. #coding=utf-8 import seaborn as ...
- 【C++】GSL(GNU Scientific Library) 的安装及在 Visual Studio 2017 中的使用
GSL 是 GNU 开发并维护的科学计算的库,其中包括: 复数 多项式的根 特殊函数 向量和矩阵 排列 排序 BLAS支持 线性代数 Eigensystems 快速傅立叶变换 正交 随机数 准随机序列 ...
- BZOJ5261 Rhyme--广义SAM+拓扑排序
原题链接,不是权限题 题目大意 有\(n\)个模板串,让你构造一个尽量长的串,使得这个串中任意一个长度为\(k\)的子串都是至少一个模板串的子串 题解 可以先看一下这道题 [POI2000]病毒 虽然 ...
- ajax+json
ajax学习: 1.ajax的概念 局部刷新技术.不是一门新技术,是多种技术的组合,是浏览器端的技术 2 为什么要使用ajax? 传统的模式 是 发送请求 到 服务器 ,服务器经过 ...
- C语言 内存管理(转)
转自 https://blog.csdn.net/u011616739/article/details/61621815 C语言 内存管理 1.内存分区 C源代码进过预处理.编译.汇编和链接4步生成 ...
- 值得一学的webpack4
初识webpack webpack是帮助我们管理复杂项目的工具. 学习webpack会极大扩充前端开发视野. webpack可以实现: Tree shaking 懒加载 代码分割 webpack4速度 ...
- 基于jeesite的cms系统(七):GlobalException全局异常和部署
关于全局异常: 在业务代码中专注处理业务,而不是返回各种CodeMsg(比如这里只需要知道登录时成功还是失败,其余情况直接抛出异常),可以直接抛出异常,添加一个全局异常类,根据CodeMsg来生成异常 ...
- Spring rabbitMq 中 correlationId或CorrelationIdString 消费者获取为null的问题
问题 在用Spring boot 的 spring-boot-starter-amqp 快速启动 rabbitMq 是遇到了个坑 消费者端获取不到:correlationId或Correlatio ...
- Collection和Map类图预览与比较
类图 HashSet和TreeSet的区别:https://www.cnblogs.com/bobi1234/p/10759769.html HashSet和LinkedHashSet区别:https ...