
提升Tesseract-OCR输出的质量
https://github.com/tesseract-ocr/tesseract/wiki/ImproveQuality
如果你使用Tesseract不能获得理想的输出结果,可能会有很多原因。但是请记住,除非你使用一个非常罕见的字体,或者使用一种没有被训练过的新语言这些情况,重新训练Tesseract不会有多大效果。
图片处理
Tesseract在做真正的OCR之前,内部(使用Leptonica库)先进行了各种图片处理。一般来说,它这些准备工作做的不错,但是不可避免的还是会有不足够的地方,如果图片处理不到位的话识别准确率也不会很高。
你可以在运行Tesseract的时候,设置配置变量tessedit_write_images=true,在输出的日志中可以看到Tesseract是如何处理图片的。如果返回的tessinput.tif文件看起来有问题,那么在OCR之前不妨进行一些手动的图片处理。
修改比例(Rescaling)
如果图片的DPI有300以上,Tesseract可以处理的很棒,所以如果DPI不够,不妨调整比例。
二值化(Binarisation)
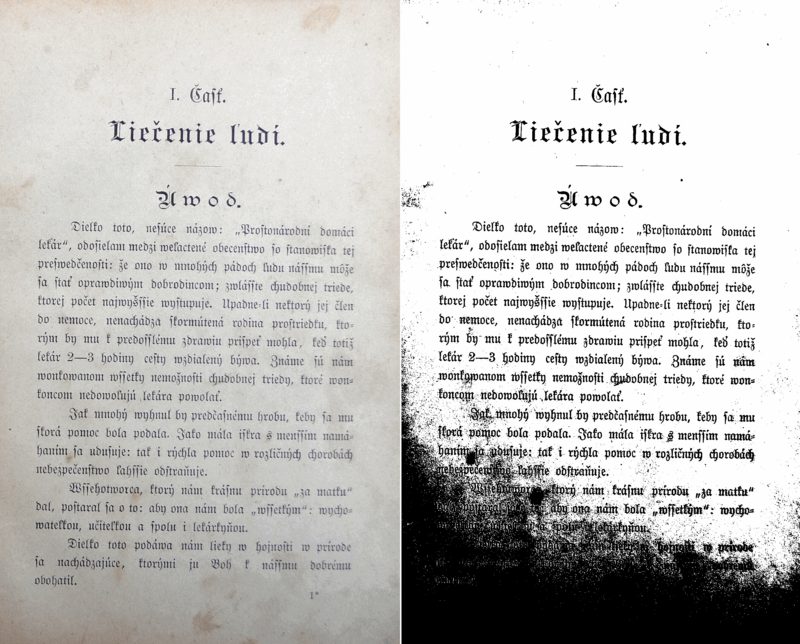 
也就是说,最好把图片变为黑白图片。Tesseract会在内部做这个事情(使用Otsu算法),但是处理结果可能不是最好的,特别是在背景颜色不算均匀暗色的时候。
如果你不能提供更好的图片,你也可以使用不同的算法。比如ImageAutoThreshold(Java), OpenCV Image Thresholding(Python), scikit-image Thresholding(Python)的文档。
去除噪点(Noise Removal)
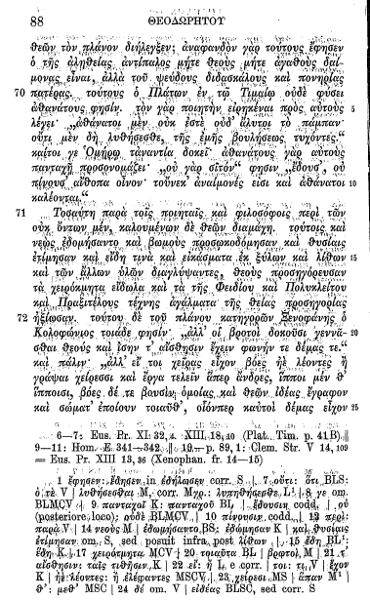 
噪点,是图片中那些随机的暗色或者彩色点,这让图片中的文字更加难以阅读。Tesseract的二值化处理步骤没有办法处理一些类型的噪点,这时候会让解析精度骤降。
旋转/偏移校正(Rotation / Deskewing)
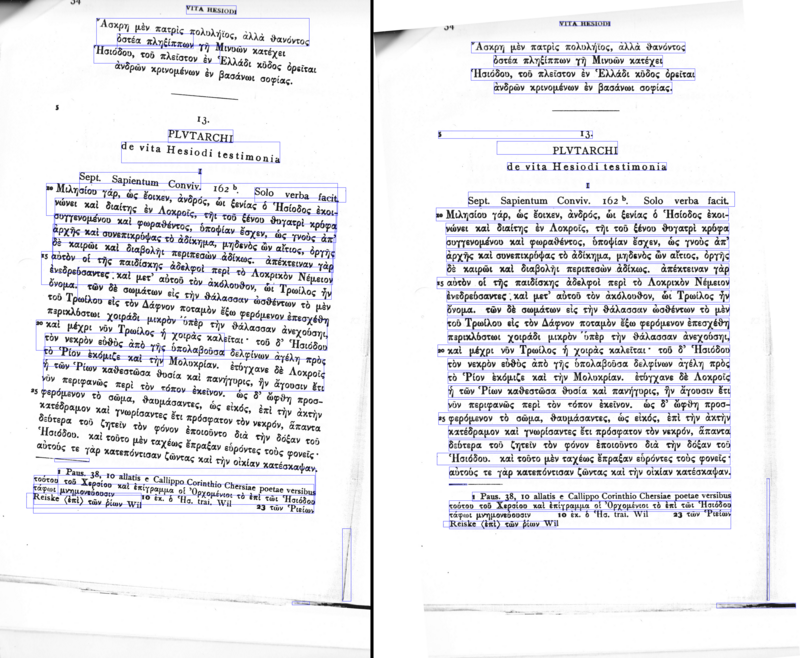 
歪曲的图片,会导致页面被扫描的时候不是笔直的。如果页面太歪曲,Tesseract的行数分割不会很准确,这也会影响OCR的最终质量。
边界(Borders)
扫描中的边界移除
 
被扫描的页面,可能会有一些暗边褶皱。这可能会导致提取一些额外的错误的字符。
缺少边界
如果你想要OCR的文本区域没有边界,Tesseract可能会碰到问题。请看这个帖子,你也可以使用ImageMagick来增加一条边界。
convert 427-1.jpg -bordercolor White -border 10x10 427-1b.jpg
透明度/Alpha通道
一些图片格式(比如png),可能使用Alpha通道来提供透明度特性。
Tesseract3.x希望用户在输入给tesseract之前移除图片的alpha通道。可以使用下面的命令:
convert input.png -alpha off output.png
Tesseract4.00开始,内部使用了leptonica的函数pixRemoveAlpha()来移除alpha通道:通过为alpha部分混入白色背景色来解决。在一些少见的情况下,这个方法可能会导致问题,用户需要手动移除alpha通道。
工具/库
例子
如果你想要知道如何使用程序来提升图片质量,可以看看下面的例子:
- OpenCV -- 旋转 -- C++例子
- Fred的ImageMagick TEXTCLEANER -- 一个bash脚本,处理文本文档,清除文本的背景色。
- rotation_spacing.py -- 一个Python脚本,自动检测图片中的旋转以及行之间的空间。
- crop_morphology.py -- 一个Python脚本,找到图片中文本区域,使用了OpenCV和numpy。
- noteshrink -- Python例子,清理待扫描的图片。还有一篇详细介绍代码的blog: 压缩以及加强手写笔记
- uproject text -- 一个Python例子,恢复了图片的透视。详细的blog: Unprojecting text with ellipses
- page_dewrap -- 一个Python例子,使用‘cubic sheet‘模型为图片进行dewrapping。详细blog: Page dewrapping
页面划分的方法
默认情况下,Tesseract会认为图片是划分好的,会识别整个图片。如果你只要对一个小块区域进行OCR,请使用--psm参数。注意,为文本加入白色的border也有用,请看issue 398.
想要知道Tesseract支持的所有页面分割模式,请使用命令tesseract -h:
0    Orientation and script detection (OSD) only.

1    Automatic page segmentation with OSD.

2    Automatic page segmentation, but no OSD, or OCR.

3    Fully automatic page segmentation, but no OSD. (Default)

4    Assume a single column of text of variable sizes.

5    Assume a single uniform block of vertically aligned text.

6    Assume a single uniform block of text.

7    Treat the image as a single text line.

8    Treat the image as a single word.

9    Treat the image as a single word in a circle.

10    Treat the image as a single character.

11    Sparse text. Find as much text as possible in no particular order.

12    Sparse text with OSD.

13    Raw line. Treat the image as a single text line,

                bypassing hacks that are Tesseract-specific.
字典,单词列表以及模式
默认情况下,Tesseract被优化为识别单词组成的句子。如果你想要识别一些其它的模式,比如收据,价格列表,或者代码。可以使用一些方法来提高识别率,比如选用合适的文本分割方法。
如果你要识别的文本都不是字典中的单词,禁用Tesseract的字典功能可以提升识别准确率。可以通过同时设定配置load_freq_dawg=false & load_system_dawg=false来禁用字典。
另外,也可以为Tesseract的单词列表加入一些新的词,来帮助提升识别准确率。或者可以加入通用的字符模式,如果你对你的输入模式有了解,这种方式可以大幅提升准确率。更多详情请参考Tesseract手册.
如果你知道,只会碰到语言中的一部分子集,比如只有数字,你可以使用配置tessedit_char_whitelist.
提升Tesseract-OCR输出的质量的更多相关文章
- Tesseract——OCR图像识别 入门篇
Tesseract——OCR图像识别 入门篇 最近给了我一个任务,让我研究图像识别,从我们项目的screenshot中识别文字信息,so我开始了学习,与大家分享下. 我看到目前OCR技术有很多,最主要 ...
- 开源图片文字识别引擎——Tesseract OCR
Tessseract为一款开源.免费的OCR引擎,能够支持中文十分难得.虽然其识别效果不是很理想,但是对于要求不高的中小型项目来说,已经足够用了. 文字识别可应用于许多领域,如阅读.翻译.文献资料的检 ...
- Tesseract Ocr引擎
Tesseract Ocr引擎 1.Tesseract介绍 tesseract 是一个google支持的开源ocr项目,其项目地址:https://github.com/tesseract-ocr/t ...
- Python下Tesseract Ocr引擎及安装介绍
1.Tesseract介绍 tesseract 是一个google支持的开源ocr项目,其项目地址:https://github.com/tesseract-ocr/tesseract,目前最新的源码 ...
- Tesseract OCR使用介绍
#Tesseract OCR使用介绍 ##目录[TOC] ##下载地址及介绍 官网介绍:http://code.google.com/p/tesseract-ocr/wiki/TrainingTess ...
- tesseract ocr文字识别Android实例程序和训练工具全部源代码
tesseract ocr是一个开源的文字识别引擎,Android系统中也可以使用.可以识别50多种语言,通过自己训练识别库的方式,可以大大提高识别的准确率. 为了节省大家的学习时间,现将自己近期的学 ...
- Tesseract ocr 3.02学习记录一
光学字符识别(OCR,Optical Character Recognition)是指对文本资料进行扫描,然后对图像文件进行分析处理,获取文字及版面信息的过程.OCR技术非常专业,一般多是印刷.打印行 ...
- selenium使用笔记(二)——Tesseract OCR
在自动化测试过程中我们经常会遇到需要输入验证码的情况,而现在一般以图片验证码居多.通常我们处理这种情况应该用最简单的方式,让开发给个万能验证码或者直接将验证码这个环节跳过.之前在技术交流群里也跟朋友讨 ...
- alfresco install in linux, and integrated with tesseract ocr
本文描述在Linux系统上安装Alfresco的步骤: 1. 下载安装文件:alfresco-community-5.0.d-installer-linux-x64.bin 2. 增加执行权限并执行: ...
随机推荐
- Pandas基本操作
pandas:数据分析 pandas是一个强大的Python数据分析的工具包. pandas是基于NumPy构建的. pandas的主要功能 具备对其功能的数据结构DataFrame.Series 集 ...
- [转帖]SAP S4 HANA 1610与ECC的比较
SAP S4 HANA 1610与ECC的比较 https://zhuanlan.zhihu.com/p/27266476 SAP S4 HANA是下一代的ERP套件,是SAP 战略的核心,相关资料也 ...
- 【NLP】Conditional Language Models
Language Model estimates the probs that the sequences of words can be a sentence said by a human. Tr ...
- [HDU5969] 最大的位或
题目类型:位运算 传送门:>Here< 题意:给出\(l\)和\(r\),求最大的\(x|y\),其中\(x,y\)在\([l,r]\)范围内 解题思路 首先让我想到了前面那题\(Bits ...
- Addrss already in user 解决方案 (linux)
Addrss already in user 解决方案 查pid netstat -lptu 查看当前用户的进程 pid kill -9 pid 杀进程 重复上面步骤一次, 因为一遍杀不死.他会换一 ...
- [AMD驱动]解决AMD驱动的1603错误
官方:https://www.amd.com/en/support/kb/faq/gpu-kb1603 其实把更改的文档 下载 音乐等默认目录恢复到C盘(或任意一个可访问的路径),就可以正常安装了.
- 洛谷 P4302 【[SCOI2003]字符串折叠】
又来填一个以前很久很久以前挖的坑 首先如果先抛开折叠的内部情况不谈,我们可以得到这样的一个经典的区间DP的式子 $ f[l][r]=min(f[l][r],f[l][k]+f[k+1][r])(l&l ...
- 洛谷 P2042 【[NOI2005]维护数列】
一直在想要做这道题,但是被那个硕大的Splay标签压垮了 好了,切入正题 这道题应该是我第二次用splay来维护区间问题 我还是太菜了QAQ 其实思路也很简单,就是以每一个位置的下标来进行维护,然后其 ...
- MySQL数据目录(data)迁移
因为系统分区的空间不足,添加了一块硬盘,挂载到/data目录下,把MySQL的数据目录(data)迁移过去. 1.停止MySQL服务: [root@zabbix mysql]# service mys ...
- antd的Tree控件实现点击展开功能
antd 的 Tree 控件没有提供点击展开的功能,只能通过左边的三角形实现展开和收起,没办法只好自己实现这个功能. 先看效果 如图实现的是类似 Mac 文件目录形式的结构,有箭头代表是个文件夹,点击 ...