
Python爬虫学习笔记(四)
Request:
Test1(基本属性:POST):
代码1:


import requests

# 发送POST请求

data = {

}

response = requests.post(url, data=data)
POST请求
Test2(auth认证):
代码2:
import requests

# 发送POST请求

data = {

}

response = requests.post(url, data=data)

#内网 => 需要认证

auth = (user, pwd)

response = requests.get(url, auth=auth)
auth认证
Test3(添加代理IP):
代码3:
import requests

# 1.请求url

url = 'http://www.baidu.com'

headers = {

    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/88.0.4324.104 Safari/537.36',

}

free_proxy = {

    'http': '58.249.55.222:9797'

}

response = requests.get(url=url, headers=headers, proxies=free_proxy)

print(response.status_code)
添加代理IP
Test4(SSL认证):
代码4:
import requests

url = 'https://www.12306.cn/'

headers = {

    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/88.0.4324.104 Safari/537.36',

}

response = requests.get(url=url, headers=headers)

data = response.content.decode()

with open('03-ssl.html', 'w', encoding='utf-8')as f:

    f.write(data)
错误示例
错误原因:
https是有第三方CA证书认证的

但12306虽然是https,但是他不是CA证书,他是自己颁布的证书

解决方法:

告诉web的服务器忽略证书访问
错误原因及解决方法
正确操作:
import requests

url = 'https://www.12306.cn/'

headers = {

    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/88.0.4324.104 Safari/537.36',

}

response = requests.get(url=url, headers=headers, verify=False)

data = response.content.decode()

with open('03-ssl.html', 'w', encoding='utf-8')as f:

    f.write(data)
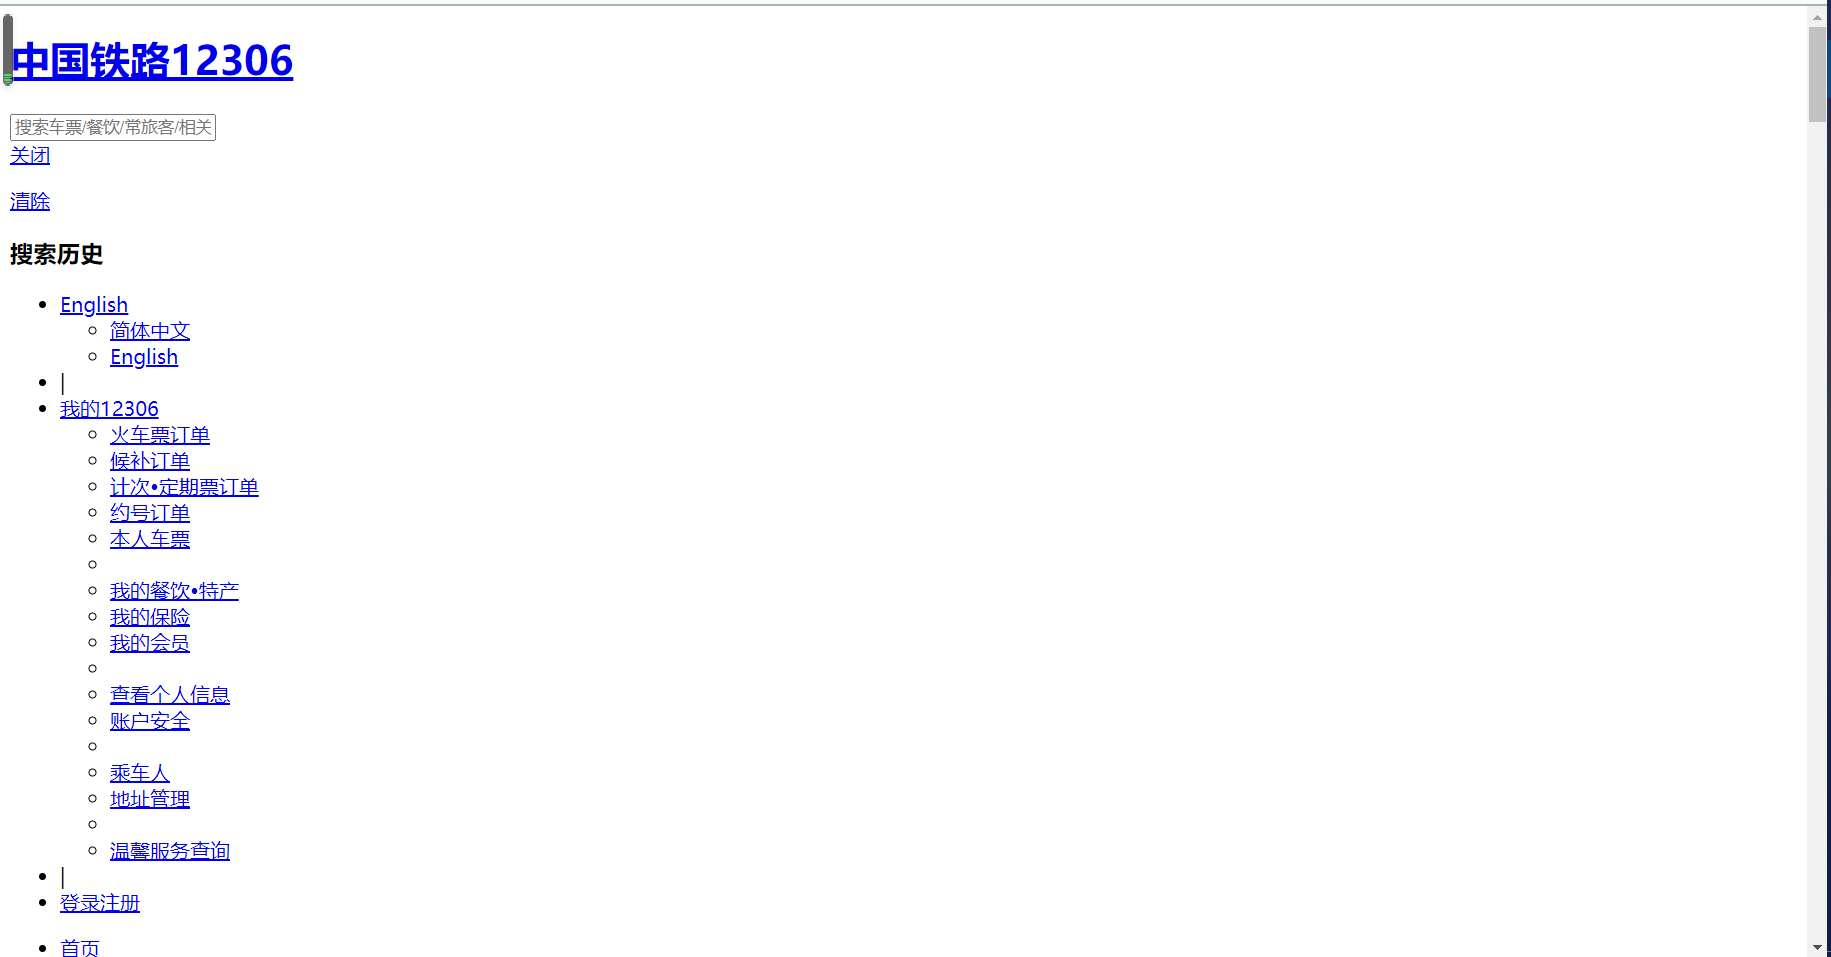
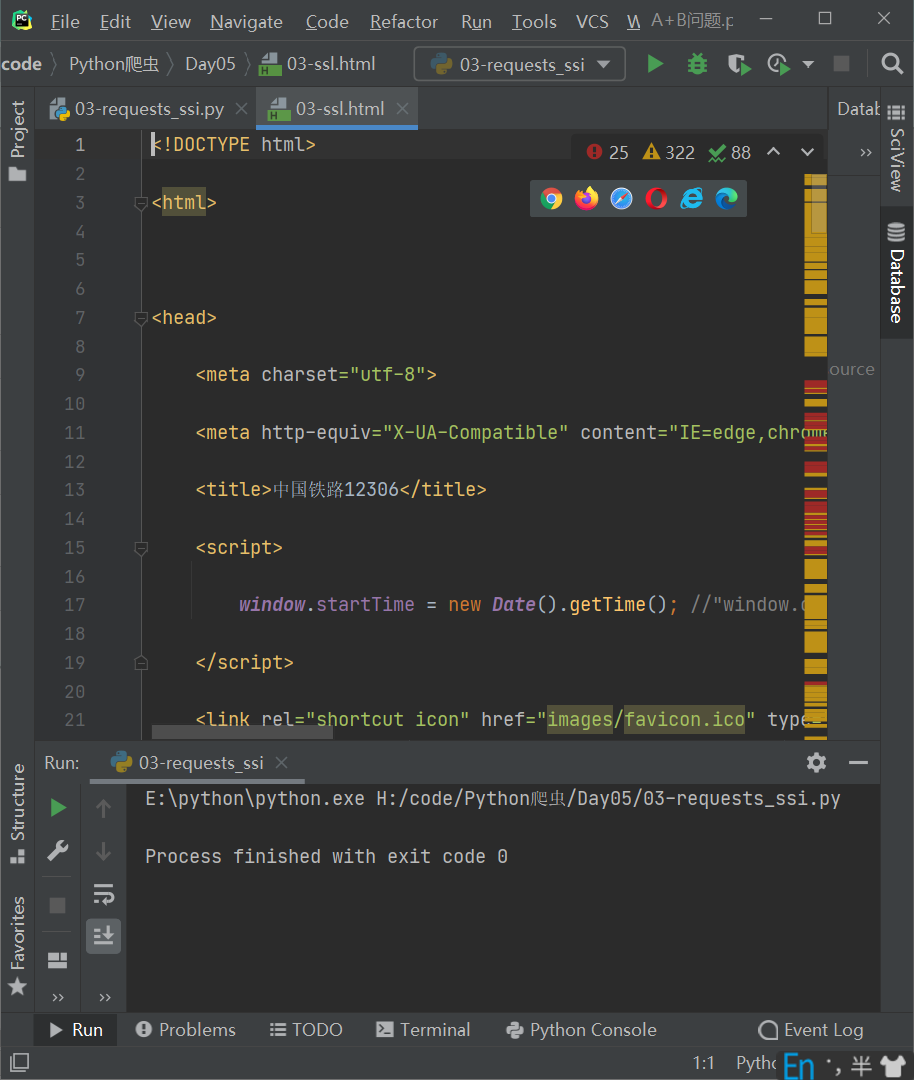
忽略证书进行SSL认证
返回:
Test5(Cookies):
以抓取https://www.yaozh.com/为例
代码5:
import requests

# 请求数据url

member_url = 'https://www.yaozh.com/mamber'

headers = {

    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/88.0.4324.104 Safari/537.36',

}

# cookies字符串

cookies = 'acw_tc=2f624a2116146683053267637e08ee667240e1e39bfc4dbbbd0b8a8f33eaa4; PHPSESSID=em18pu35k89loei7glff6tthu5; _ga=GA1.2.1727298837.1614668307; _gid=GA1.2.781607072.1614668307; _gat=1; Hm_lvt_65968db3ac154c3089d7f9a4cbb98c94=1614668307; Hm_lpvt_65968db3ac154c3089d7f9a4cbb98c94=1614668313; yaozh_logintime=1614668314; yaozh_user=1038868%09s1mpL3; yaozh_userId=1038868; yaozh_jobstatus=kptta67UcJieW6zKnFSe2JyYnoaSZ5htnZqdg26qb21rg66flM6bh5%2BscZdyVNaWz9Gwl4Ny2G%2BenofNlKqpl6XKppZVnKmflWlxg2lolJeaA7663ea03b06b64c50D898E7C9Aa493SkZSblWmHcNiemZtVq56lloN0pG2SaZ%2BGam2SbGiZnZWSmZyYaodw4g%3D%3Dc0addf8502ad2cb2f15b3ee2b0e1386b; db_w_auth=854448%09s1mpL3; UtzD_f52b_saltkey=oZ3HIEZl; UtzD_f52b_lastvisit=1614664715; UtzD_f52b_lastact=1614668315%09uc.php%09; UtzD_f52b_auth=25786v5G66Jeq3x5p14pj246attR7pdjk5X409nOsIqKeaEypUvH%2BA1LTN4dNrChFQS1hmPQNfLGoyIxAD8PRqgk4bA; yaozh_uidhas=1; yaozh_mylogin=1614668317; acw_tc=2f624a2116146683053267637e08ee667240e1e39bfc4dbbbd0b8a8f33eaa4'

# 但需要的是cookies的字典类型

cookies_dict = {

}

cookies_list = cookies.split('; ')

for cookie in cookies_list:

    cookies_dict[cookie.split('=')[0]] = cookie.split('=')[1]

response = requests.get(url=member_url, headers=headers, cookies=cookies_dict)

data = response.content.decode()

with open('05-cookie.html', 'w', encoding='utf-8')as f:

    f.write(data)
Cookies - 代码传参登陆
返回:
由返回页面可知,登录成功。

Test6(cookies - session):
以抓取https://www.yaozh.com/为例
代码6:
Cookies - 代码带着cookie去请求数据返回:
由返回页面可知,登录成功。

数据解析:
Test1(正则表达式 - 贪婪模式):
代码1:
import re

# 贪婪模式:从开头匹配到结尾

# 非贪婪模式:使用?

one = 'mdfjiefhuehfgieufn213431241234n'

pattern = re.compile('m(.*)n')

result = pattern.findall(one)

print(result)
贪婪模式
返回1:
['dfjiefhuehfgieufn213431241234']
Test2(正则表达式 - 费贪婪模式):
代码2:
import re

# 贪婪模式:从开头匹配到结尾

# 非贪婪模式:使用?

one = 'mdfjiefhuehfgieufn213431241234n'

pattern = re.compile('m(.*?)n')

result = pattern.findall(one)

print(result)
返回2:
['dfjiefhuehfgieuf']
Test3(正则表达式 - 匹配换行符):
代码3:
import re

# .除了换行符之外的匹配

one = """

    maiwgdyuwagdwyadg

    1234567612121134n

"""

pattern = re.compile('m(.*)n')

result = pattern.findall(one)

print(result)
不匹配换行符
返回3:
代码4:
import re

# .除了换行符之外的匹配

one = """

    maiwgdyuwagdwyadg

    1234567612121134n

"""

pattern = re.compile('m(.*)n', re.S)

result = pattern.findall(one)

print(result)
匹配换行符
返回4:

代码5:
import re

# .除了换行符之外的匹配

one = """

    maiwgdyuwagdwyadg

    1234567612121134N

"""

pattern = re.compile('m(.*)n', re.S | re.I)

result = pattern.findall(one)

print(result)
忽略大小写
返回5:

Test4(正则表达式 - 纯数字的正则):
代码6:
import re

# 纯数字的正则 \d 0 - 9之间的一个数

pattern = re.compile('^\d+$')

one = '1234'

# 匹配判断的方法

result = pattern.match(one)

print(result.group())
返回:
1234
Test5(正则表达式 - 范围运算):
代码7:
import re

# 范围运算 [123]  [1-9]

one = '798345'

pattern = re.compile('[1-9]')

result = pattern.findall(one)

print(result)
返回:
['7', '9', '8', '3', '4', '5']
注:
- match:从头匹配,匹配一次
- search:从任意位置,匹配一次
- findall:查找符合正则的内容
- sub:替换字符串
- split:拆分
Python爬虫学习笔记(四)的更多相关文章
- Python爬虫学习:四、headers和data的获取
之前在学习爬虫时,偶尔会遇到一些问题是有些网站需要登录后才能爬取内容,有的网站会识别是否是由浏览器发出的请求. 一.headers的获取 就以博客园的首页为例:http://www.cnblogs.c ...
- python爬虫学习笔记(一)——环境配置(windows系统)
在进行python爬虫学习前,需要进行如下准备工作: python3+pip官方配置 1.Anaconda(推荐,包括python和相关库) [推荐地址:清华镜像] https://mirrors ...
- Python爬虫学习笔记(三)
Cookies: 以抓取https://www.yaozh.com/为例 Test1(不使用cookies): 代码: import urllib.request # 1.添加URL url = &q ...
- 一入爬虫深似海,从此游戏是路人!总结我的python爬虫学习笔记!
前言 还记得是大学2年级的时候,偶然之间看到了学长在学习python:我就坐在旁边看他敲着代码,感觉很好奇.感觉很酷,从那之后,我就想和学长一样的厉害,就想让学长教我,请他吃了一周的饭,他答应了.从此 ...
- python爬虫学习笔记
爬虫的分类 1.通用爬虫:通用爬虫是搜索引擎(Baidu.Google.Yahoo等)“抓取系统”的重要组成部分.主要目的是将互联网上的网页下载到本地,形成一个互联网内容的镜像备份. 简单来讲就是尽可 ...
- Python、pip和scrapy的安装——Python爬虫学习笔记1
Python作为爬虫语言非常受欢迎,近期项目需要,很是学习了一番Python,在此记录学习过程:首先因为是初学,而且当时要求很快速的出demo,所以首先想到的是框架,一番查找选用了Python界大名鼎 ...
- 【Python爬虫学习笔记(3)】Beautiful Soup库相关知识点总结
1. Beautiful Soup简介 Beautiful Soup是将数据从HTML和XML文件中解析出来的一个python库,它能够提供一种符合习惯的方法去遍历搜索和修改解析树,这将大大减 ...
- Python爬虫学习笔记——豆瓣登陆(一)
#-*- coding:utf-8 -*- import requests from bs4 import BeautifulSoup import html5lib import re import ...
- Python爬虫学习笔记-1.Urllib库
urllib 是python内置的基本库,提供了一系列用于操作URL的功能,我们可以通过它来做一个简单的爬虫. 0X01 基本使用 简单的爬取一个页面: import urllib2 request ...
随机推荐
- zjnuSAVEZ (字符串hash)
Description There are eight planets and one planetoid in the Solar system. It is not a well known fa ...
- 【noi 2.6_747】Divisibility(DP)
这题题意与前面的"判断整除"重复了.具体解释可看我这篇的博文. http://www.cnblogs.com/konjak/p/5936738.html 1 #include< ...
- 【译】Async/Await(五)—— Executors and Wakers
原文标题:Async/Await 原文链接:https://os.phil-opp.com/async-await/#multitasking 公众号: Rust 碎碎念 翻译 by: Praying ...
- Nestjs入门学习教程
初次接触Nest,有问题欢迎指出: 简介 NestJS是一个用于构建高效.可扩展的Node.js服务器端应用程序的开发框架.简单来说是一款Node.js的后端框架. 它利用JavaScript的渐进增 ...
- 命令提示符CMD下切换用户
工作中遇到需要在windows环境中命令提示符下切换为Guest用户执行程序,类似Linux中的su操作. 操作步骤如下:1.用管理员权限运行cmd.2:执行命令:runas /user:userna ...
- 关于TCP状态TIME_WAIT的理解
1.TIME_WAIT的作用: TIME_WAIT状态存在的理由:1)可靠地实现TCP全双工连接的终止 在进行关闭连接四次挥手协议时,最后的ACK是由主动关闭端发出的,如果这个最终的ACK丢失,服务器 ...
- 由CloudStack项目引起的ESXI嵌套虚拟化引起的二级虚拟机无法被访问
关于这个问题,主要以文字描述为主,最终解决方法其实就一个步骤. 问题描述: 某客户需要部署某企业的云平台,但是由于年前没有足够的物理机资源,所以提供的资源均为虚拟机,现在让我们做技术评估. 其实观察整 ...
- C# 类 (8) - 抽象方法
抽象 抽象方法 只能 定义在抽象类 里,并且抽象方法里没有具体的代码,像这种 为啥要定义一个空空如也的函数呢?这是为了用来约束 它的派生类 的行为, 这个例子,建立了一个数组,放了cat和dog,这两 ...
- SASS CSS3 koala
CSS with superpowers Sass: Syntactically Awesome Style Sheets http://sass-lang.com/ Sass is the most ...
- 论文 公式 排版 编辑 工具 NoteExpress & MathType
1 1 论文 公式 排版 编辑 工具: NoteExpress http://www.noteexpress.net/index2.html 1 MathType http://www.dessci. ...