
2023-09-10:用go语言编写。作为项目经理,你规划了一份需求的技能清单 req_skills, 并打算从备选人员名单 people 中选出些人组成一个「必要团队」 ( 编号为 i 的备选人员
2023-09-10:用go语言编写。作为项目经理,你规划了一份需求的技能清单 req_skills,
并打算从备选人员名单 people 中选出些人组成一个「必要团队」
( 编号为 i 的备选人员 people[i] 含有一份该备选人员掌握的技能列表)。
所谓「必要团队」,就是在这个团队中,
对于所需求的技能列表 req_skills 中列出的每项技能,
团队中至少有一名成员已经掌握。可以用每个人的编号来表示团队中的成员:
例如,团队 team = [0, 1, 3] 表示掌握技能分别为
people[0],people[1],和 people[3] 的备选人员。
请你返回 任一 规模最小的必要团队,团队成员用人员编号表示。
你可以按 任意顺序 返回答案,题目数据保证答案存在。
输入:req_skills = ["java","nodejs","reactjs"], people = [["java"],["nodejs"],["nodejs","reactjs"]]。
输出:[0,2]。
来自左程云。
答案2023-09-10:
大体步骤如下:
1.首先,我们对 reqSkills 进行排序,获得排序后的技能列表。这是为了后续方便进行比较。例如,将 ["java", "nodejs", "reactjs"] 排序为 ["java", "nodejs", "reactjs"]。
2.初始化变量 n 为 reqSkills 的长度,变量 m 为 people 的长度,并创建一个长度为 m 的整数数组 statuses 用于记录每个人的技能状态。
3.对于每个人,我们通过比较技能列表和排序后的 reqSkills 列表,来确定他们掌握的技能状态。首先,将该人的技能列表排序。然后使用双指针法,一个指针指向排序后的 reqSkills 列表,另一个指针指向该人的技能列表。比较两个指针指向的技能,如果相等,则表示该人掌握了该技能,将对应的状态位置为1,并将两个指针都向后移动一位;如果 reqSkills[p1] 小于 skill[p2],则将指向 reqSkills 的指针向后移动一位;否则将指向技能列表的指针向后移动一位。重复这个过程直到其中一个指针超出范围。
4.将每个人的技能状态记录在 statuses 数组中。
5.创建一个二维数组 dp,其中 dp[i][j] 表示从第 i 个人开始,技能状态为 j 时,所需的最小团队人数。初始化 dp 数组的所有元素为 -1。
6.调用递归函数 process,该函数的参数包括:people 数组,技能列表的长度 n,当前处理的人员下标 i,当前的技能状态 status,以及 dp 数组。
7.在递归函数 process 中,首先判断当前技能状态是否已经满足所有需求,即 status 是否等于 (1<<n)-1。如果满足,则返回0表示不需要再增加人员。
8.接下来,判断是否已经遍历了所有人员,即 i 是否等于 people 数组的长度。如果是,说明无法满足所有需求,并返回一个较大的值,这里使用 1<<31-1 来表示无穷大。
9.然后,判断 dp 数组中是否已经记录了当前人员和技能状态的最小团队人数,如果是,直接返回该值。
10.在递归函数中,我们有两个递归调用,第一个是继续尝试从下一个人员开始不增加人员的情况,即调用 process(people, n, i+1, status, dp),将返回的值保存在变量 p1 中。
11.第二个递归调用是尝试从下一个人员开始增加当前人员的情况,即调用 process(people, n, i+1, status|people[i], dp),将返回的值保存在变量 p2 中。注意,这里的参数 status|people[i] 表示将当前人员的技能状态添加到当前技能状态中。
12.如果 p2 不等于 1<<31-1,说明可以满足当前需求,将 p2+1 指代的团队人数保存在变量 ans 中,否则将 ans 设置为 p1。
13.将 ans 保存在 dp 数组中以便下次使用,并返回 ans。
14.在主函数中,根据返回的最小团队人数 size,创建一个大小为 size 的整数数组 ans 和一个指示 ans 数组下标的变量 ansi。
15.初始化变量 i 为0,status 为0,用于记录当前处理的人员下标和技能状态。
16.如果 status 不等于 (1<<n)-1,即还没有满足所有需求,执行循环。在循环中,判断两个条件:如果 i+1 等于 m,说明已经遍历到了最后一个人员;如果 dp[i][status] 不等于 dp[i+1][status],表示从当前人员开始增加人员可以满足当前需求。
17.如果满足上述两个条件之一,将 i 添加到 ans 数组中,并将 ansi 自增1。然后将当前人员的技能状态添加到当前技能状态中。
18.无论是否满足条件,将 i 自增1。
19.执行完循环后,返回 ans 数组作为结果。
总的时间复杂度为O(m * (2^n)),额外空间复杂度为O(m * (2^n))。
go完整代码如下:
package main

import (

	"fmt"

	"sort"

)

func smallestSufficientTeam(reqSkills []string, people [][]string) []int {

	sort.Strings(reqSkills)

	n := len(reqSkills)

	m := len(people)

	statuses := make([]int, m)

	for i := 0; i < m; i++ {

		skillStatus := 0

		skill := people[i]

		sort.Strings(skill)

		p1, p2 := 0, 0

		for p1 < n && p2 < len(skill) {

			compare := reqSkills[p1] == skill[p2]

			if compare {

				skillStatus |= 1 << p1

				p1++

				p2++

			} else if reqSkills[p1] < skill[p2] {

				p1++

			} else {

				p2++

			}

		}

		statuses[i] = skillStatus

	}

	dp := make([][]int, m)

	for i := 0; i < m; i++ {

		dp[i] = make([]int, 1<<n)

		for j := 0; j < 1<<n; j++ {

			dp[i][j] = -1

		}

	}

	size := process(statuses, n, 0, 0, dp)

	ans := make([]int, size)

	ansi := 0

	i := 0

	status := 0

	for status != (1<<n)-1 {

		if i+1 == m || dp[i][status] != dp[i+1][status] {

			ans[ansi] = i

			ansi++

			status |= statuses[i]

		}

		i++

	}

	return ans

}

func process(people []int, n, i, status int, dp [][]int) int {

	if status == (1<<n)-1 {

		return 0

	}

	if i == len(people) {

		return 1<<31 - 1

	}

	if dp[i][status] != -1 {

		return dp[i][status]

	}

	p1 := process(people, n, i+1, status, dp)

	p2 := 1<<31 - 1

	next2 := process(people, n, i+1, status|people[i], dp)

	if next2 != 1<<31-1 {

		p2 = 1 + next2

	}

	ans := min(p1, p2)

	dp[i][status] = ans

	return ans

}

func min(a, b int) int {

	if a < b {

		return a

	}

	return b

}

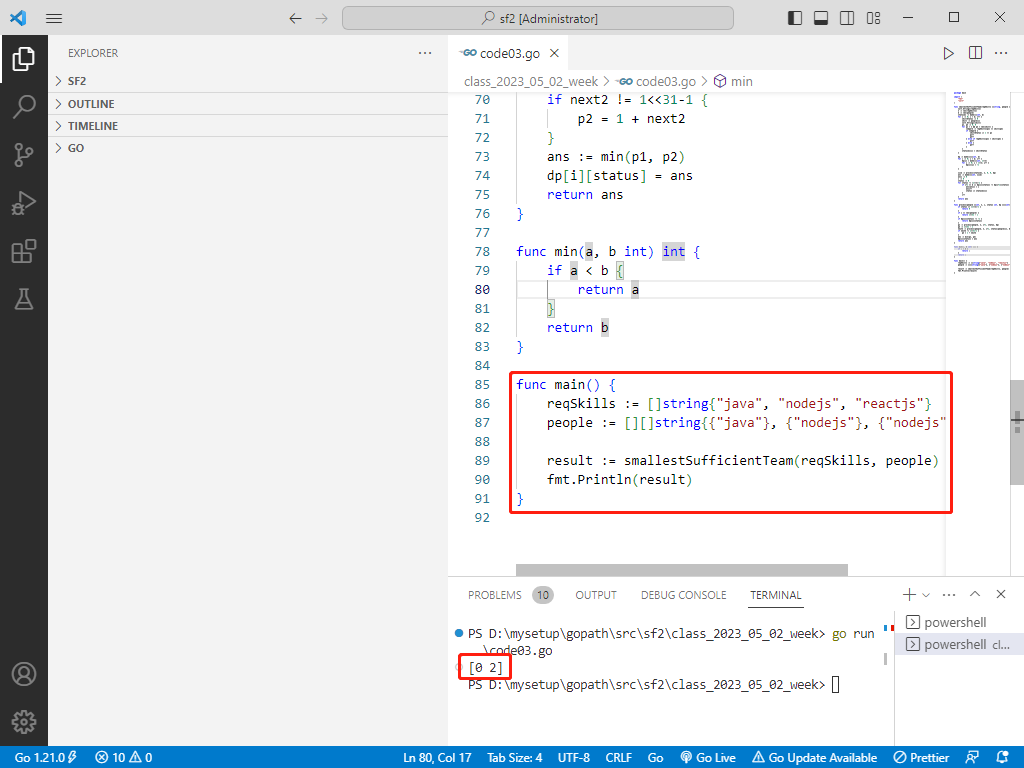
func main() {

	reqSkills := []string{"java", "nodejs", "reactjs"}

	people := [][]string{{"java"}, {"nodejs"}, {"nodejs", "reactjs"}}

	result := smallestSufficientTeam(reqSkills, people)

	fmt.Println(result)

}
rust完整代码如下:
fn smallest_sufficient_team(req_skills: Vec<String>, people: Vec<Vec<String>>) -> Vec<i32> {

    let n = req_skills.len();

    let m = people.len();

    let mut statuses = vec![0; m];

    for (i, skill) in people.iter().enumerate() {

        let mut skill_status = 0;

        let mut sorted_skill = skill.clone();

        sorted_skill.sort();

        let mut p1 = 0;

        let mut p2 = 0;

        while p1 < n && p2 < sorted_skill.len() {

            match req_skills[p1].cmp(&sorted_skill[p2]) {

                std::cmp::Ordering::Less => p1 += 1,

                std::cmp::Ordering::Greater => p2 += 1,

                std::cmp::Ordering::Equal => {

                    skill_status |= 1 << p1;

                    p1 += 1;

                    p2 += 1;

                }

            }

        }

        statuses[i] = skill_status;

    }

    let mut dp = vec![vec![-1; 1 << n]; m];

    let size = process(&statuses, n, 0, 0, &mut dp);

    let mut ans = vec![0; size as usize];

    let mut ansi = 0;

    let mut i = 0;

    let mut status: i32 = 0;

    while status != (1 << n) - 1 {

        if i + 1 == m || dp[i][status as usize] != dp[i + 1][status as usize] {

            ans[ansi] = i as i32;

            ansi += 1;

            status |= statuses[i as usize];

        }

        i += 1;

    }

    ans

}

fn process(people: &[i32], n: usize, i: usize, status: i32, dp: &mut Vec<Vec<i32>>) -> i32 {

    if status == (1 << n) - 1 {

        return 0;

    }

    if i == people.len() {

        return i32::MAX;

    }

    if dp[i][status as usize] != -1 {

        return dp[i][status as usize];

    }

    let p1 = process(people, n, i + 1, status, dp);

    let mut p2 = i32::MAX;

    let next2 = process(people, n, i + 1, status | people[i], dp);

    if next2 != i32::MAX {

        p2 = 1 + next2;

    }

    let ans = p1.min(p2);

    dp[i][status as usize] = ans;

    ans

}

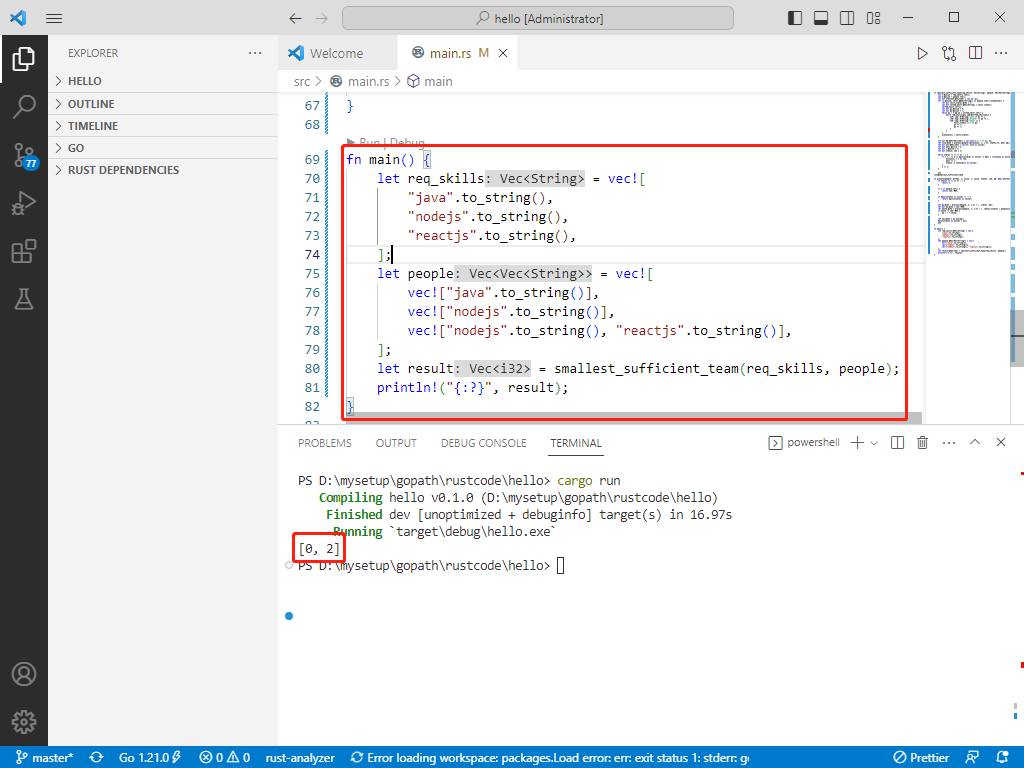
fn main() {

    let req_skills = vec![

        "java".to_string(),

        "nodejs".to_string(),

        "reactjs".to_string(),

    ];

    let people = vec![

        vec!["java".to_string()],

        vec!["nodejs".to_string()],

        vec!["nodejs".to_string(), "reactjs".to_string()],

    ];

    let result = smallest_sufficient_team(req_skills, people);

    println!("{:?}", result);

}
c++完整代码如下:
#include <iostream>

#include <vector>

#include <unordered_map>

#include <algorithm>

#include <cmath>

using namespace std;

int process(const vector<int>& people, int n, int i, int status, unordered_map<int, int>& dp) {

    if (status == (1 << n) - 1) {

        return 0;

    }

    if (i == people.size()) {

        return INT_MAX;

    }

    int key = (i << n) | status;

    if (dp.find(key) != dp.end()) {

        return dp[key];

    }

    int p1 = process(people, n, i + 1, status, dp);

    int p2 = INT_MAX;

    int next2 = process(people, n, i + 1, status | people[i], dp);

    if (next2 != INT_MAX) {

        p2 = 1 + next2;

    }

    int ans = min(p1, p2);

    dp[key] = ans;

    return ans;

}

vector<int> smallestSufficientTeam(vector<string>& req_skills, vector<vector<string>>& people) {

    unordered_map<string, int> skillMap;

    int count = 0;

    for (const string& skill : req_skills) {

        skillMap[skill] = count++;

    }

    int n = count;

    int m = people.size();

    vector<int> statuses(m);

    for (int i = 0; i < m; i++) {

        int skillStatus = 0;

        const vector<string>& skills = people[i];

        for (const string& skill : skills) {

            skillStatus |= 1 << skillMap[skill];

        }

        statuses[i] = skillStatus;

    }

    unordered_map<int, int> dp;

    int size = process(statuses, n, 0, 0, dp);

    vector<int> ans;

    int i = 0, status = 0;

    while (status != (1 << n) - 1) {

        if (i + 1 == m || dp[i << n | status] != dp[(i + 1) << n | status]) {

            ans.push_back(i);

            status |= statuses[i];

        }

        i++;

    }

    return ans;

}

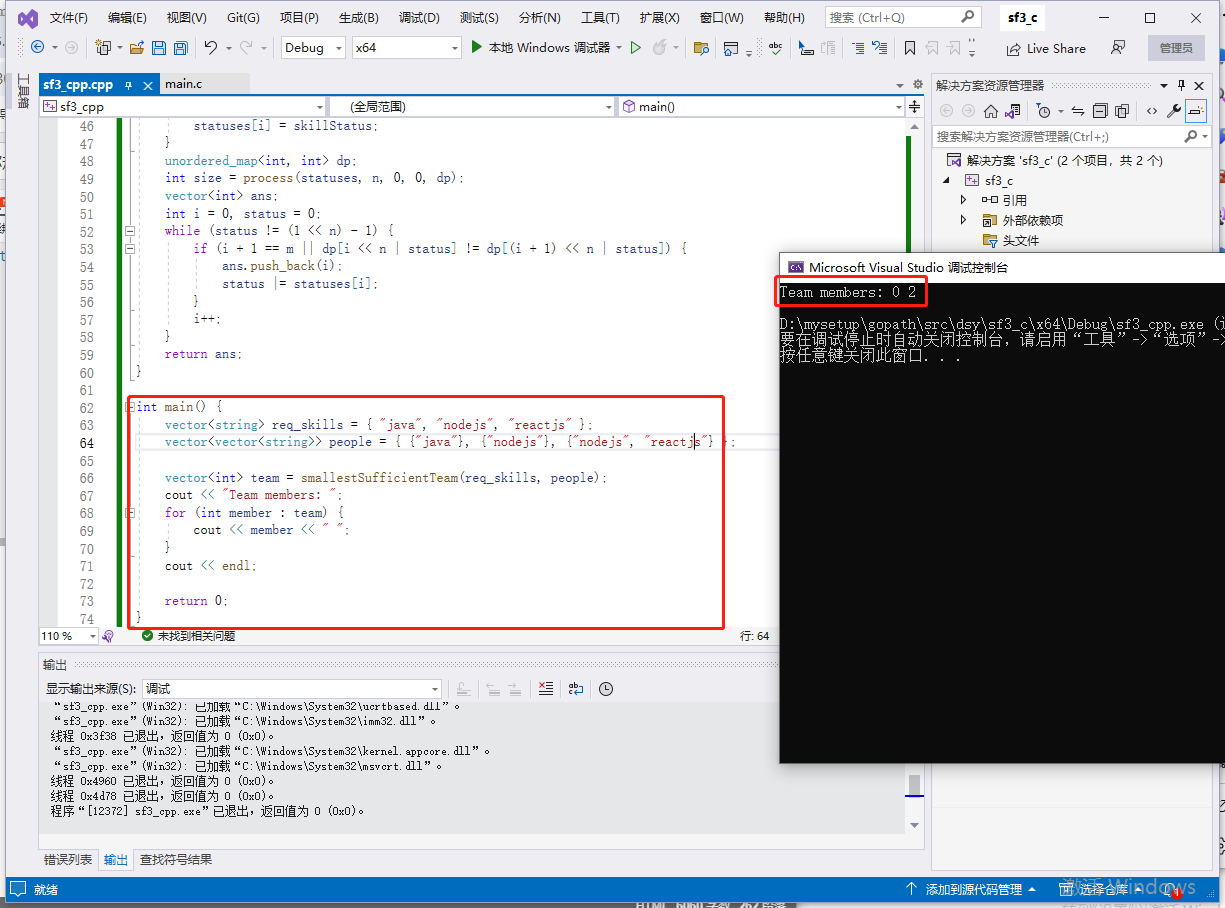
int main() {

    vector<string> req_skills = { "java", "nodejs", "reactjs" };

    vector<vector<string>> people = { {"java"}, {"nodejs"}, {"nodejs", "reactjs"} };

    vector<int> team = smallestSufficientTeam(req_skills, people);

    cout << "Team members: ";

    for (int member : team) {

        cout << member << " ";

    }

    cout << endl;

    return 0;

}
c完整代码如下:
#include <stdio.h>

#include <stdlib.h>

#include <string.h>

typedef struct {

    int* data;

    int size;

    int capacity;

} IntArray;

IntArray* createIntArray() {

    IntArray* arr = (IntArray*)malloc(sizeof(IntArray));

    arr->data = NULL;

    arr->size = 0;

    arr->capacity = 0;

    return arr;

}

void append(IntArray* arr, int value) {

    if (arr->size >= arr->capacity) {

        int newCapacity = arr->capacity == 0 ? 1 : arr->capacity * 2;

        int* newData = (int*)malloc(sizeof(int) * newCapacity);

        if (arr->data != NULL) {

            memcpy(newData, arr->data, sizeof(int) * arr->size);

            free(arr->data);

        }

        arr->data = newData;

        arr->capacity = newCapacity;

    }

    arr->data[arr->size++] = value;

}

void destroyIntArray(IntArray* arr) {

    if (arr != NULL) {

        if (arr->data != NULL) {

            free(arr->data);

        }

        free(arr);

    }

}

int findSkillIndex(char** skills, int skillsSize, char* target) {

    for (int i = 0; i < skillsSize; i++) {

        if (strcmp(skills[i], target) == 0) {

            return i;

        }

    }

    return -1;

}

void smallestSufficientTeam(char** req_skills, int req_skillsSize, char*** people, int peopleSize, int* peopleColSize, int* returnSize, int** returnArray) {

    char** skills = (char**)malloc(sizeof(char*) * req_skillsSize);

    for (int i = 0; i < req_skillsSize; i++) {

        skills[i] = _strdup(req_skills[i]);

    }

    int n = req_skillsSize;

    int m = peopleSize;

    int* statuses = (int*)malloc(sizeof(int) * m);

    for (int i = 0; i < m; i++) {

        int skillStatus = 0;

        for (int j = 0; j < peopleColSize[i]; j++) {

            int skillIndex = findSkillIndex(skills, req_skillsSize, people[i][j]);

            if (skillIndex != -1) {

                skillStatus |= 1 << skillIndex;

            }

        }

        statuses[i] = skillStatus;

    }

    int** dp = (int**)malloc(sizeof(int*) * m);

    for (int i = 0; i < m; i++) {

        dp[i] = (int*)malloc(sizeof(int) * (1 << n));

        for (int j = 0; j < (1 << n); j++) {

            dp[i][j] = -1;

        }

    }

    int size = process(statuses, n, 0, 0, dp);

    *returnSize = size;

    *returnArray = (int*)malloc(sizeof(int) * size);

    int index = 0;

    int i = 0;

    int status = 0;

    while (status != (1 << n) - 1) {

        if (i + 1 == m || dp[i][status] != dp[i + 1][status]) {

            (*returnArray)[index++] = i;

            status |= statuses[i];

        }

        i++;

    }

    for (int i = 0; i < m; i++) {

        free(dp[i]);

    }

    free(dp);

    for (int i = 0; i < req_skillsSize; i++) {

        free(skills[i]);

    }

    free(skills);

    free(statuses);

}

int process(int* people, int n, int i, int status, int** dp) {

    if (status == (1 << n) - 1) {

        return 0;

    }

    if (i == n) {

        return INT_MAX;

    }

    if (dp[i][status] != -1) {

        return dp[i][status];

    }

    int p1 = process(people, n, i + 1, status, dp);

    int p2 = INT_MAX;

    int next2 = process(people, n, i + 1, status | people[i], dp);

    if (next2 != INT_MAX) {

        p2 = 1 + next2;

    }

    int ans = p1 < p2 ? p1 : p2;

    dp[i][status] = ans;

    return ans;

}

int main() {

    char* req_skills[] = { "java", "nodejs", "reactjs" };

    int req_skillsSize = sizeof(req_skills) / sizeof(req_skills[0]);

    char** people[] = {

        (char* []) {

"java"

},

  (char* []) {

"nodejs"

},

(char* []) {

"nodejs", "reactjs"

}

    };

    int peopleSize = sizeof(people) / sizeof(people[0]);

    int peopleColSize[] = { 1, 1, 2 };

    int returnSize;

    int* returnArray;

    smallestSufficientTeam(req_skills, req_skillsSize, people, peopleSize, peopleColSize, &returnSize, &returnArray);

    printf("Smallest Sufficient Team:\n");

    for (int i = 0; i < returnSize; i++) {

        printf("%d ", returnArray[i]);

    }

    printf("\n");

    free(returnArray);

    return 0;

}

2023-09-10:用go语言编写。作为项目经理,你规划了一份需求的技能清单 req_skills, 并打算从备选人员名单 people 中选出些人组成一个「必要团队」 ( 编号为 i 的备选人员的更多相关文章
- Linux在shell中进入python敲方向键出现「^[[C^[[D」的解决办法
安装yum -y install readline-devel,然后在重新编译python
- 【转】具透 | 你可能不知道,iOS 10 有一个中国「特供」的联网权限功能
9 月底,苹果正式在北京成立了苹果中国研发中心.近几年,我们也在每年更新的 iOS 系统中不断看到,苹果对中国市场的关照.从早前的九宫格输入法,到最近的骚扰电话拦截,都照顾了国内用户的需求. 在 iO ...
- 「前端开发者」如何把握住「微信小程序」这波红利?
由于前两周一直在老家处理重要事情,虽然朋友圈被「微信小程序」刷爆了,但并没有时间深入了解. 昨天回广州之后,第一件事情就是把「微信小程序」相关的文章.开发文档.设计规范全部看了一遍,基本上明白了「微信 ...
- Mditor 发布「桌面版」了 - http://mditor.com
简单说明 Mditor 最早只有「组件版」,随着「桌面版」的发布,Mditor 目前有两个版本: 可嵌入到任意 Web 应用的 Embed 版本,这是一桌面版的基础,Repo: https://git ...
- 微服务架构之「 API网关 」
在微服务架构的系列文章中,前面已经通过文章<架构设计之「服务注册 」>介绍过了服务注册的原理和应用,今天这篇文章我们来聊一聊「 API网关 」. 「 API网关 」是任何微服务架构的重要组 ...
- 基于 Node.js 的轻量「持续集成」工具 CIZE
CIZE 是什么? CIZE 是一个「持续集成」工具,希望能让开发人员更快捷的搭建一个完整.可靠.便捷的 CI 服务. 甚至可以像 Gulp 或 Grunt 一样,仅仅通过一个 cizefile.js ...
- 分享开源 Markdown 编辑器 Mditor 的「桌面版」
简单说明 Mditor 最早只有「组件版」,随着「桌面版」的发布,Mditor 目前有两个版本: 可嵌入到任意 Web 应用的 Embed 版本,这是一桌面版的基础,Repo: https://git ...
- ERNIE:知识图谱结合BERT才是「有文化」的语言模型
自然语言表征模型最近受到非常多的关注,很多研究者将其视为 NLP 最重要的研究方向之一.例如在大规模语料库上预训练的 BERT,它可以从纯文本中很好地捕捉丰富的语义模式,经过微调后可以持续改善不同 N ...
- 转载_最值得阅读学习的10个C语言开源项目代码
"源代码面前,了无秘密",阅读优秀代码无疑是开发人员得以窥见软件堂奥而登堂入室的捷径.本文选取10个C语言优秀开源项目的代码作为范本,分别给予点评,免去东搜西罗之苦,点赞!那么问题 ...
- Windows 10 如何使用「系统还原」功能备份系统状态和配置
https://www.sysgeek.cn/windows-10-system-restore/ 在 Windows 10 系统中,「系统还原」功能旨在创建配置快照,并在检测到系统更改时将其工作状态 ...
随机推荐
- DESTOON做中英双语言(多语言)切换版本具体详解
第一次发原创好激动,该注意点什么? 在开发过程中用户有许多要求,比如这个多语言切换就是一个需求. 首先讲解一下DESTOON(DT)后台系统如何做这个中英.甚至多语言切换的这个功能. DT本身不自带多 ...
- Go 常用命令介绍
Go 常用命令 目录 Go 常用命令 一.Go 常用命令 1.1 go build 1.1.1 指定输出目录 1.1.2 常用环境变量设置编译操作系统和 CPU 架构 1.1.3 查看支持的操作系统和 ...
- 教育法学第九章单元测试MOOC
第九章单元测试 返回 本次得分为:100.00/100.00, 本次测试的提交时间为:2020-09-06, 如果你认为本次测试成绩不理想,你可以选择 再做一次 . 1 单选(5分) 作为教师最基本的 ...
- 用Rust手把手编写一个Proxy(代理), 准备篇, 动手造轮子
用Rust手把手编写一个Proxy(代理), 准备篇, 动手造轮子 wmproxy 将实现http/https代理, socks5代理, 后续将实现websocket代理, 内外网穿透等, 会将实现过 ...
- Python 在PDF中生成水印
前言 在PDF中插入水印是比较常用的一种功能.一般在生成比较重要的,或者需要注明版权.作者的文档时使用比较多. 这里我将分享一个通过python代码为PDF文档添加水印的办法(包括文本水印和图像水印) ...
- [ABP] PostgreSQL在.NET 6.0使用DateTime类型抛出异常:timestamp with time zone
今晚操起久违的 ABP 框架搭了个新项目: .NET 运行时版本:6.0.3 ABP 版本:v5.2.0-rc.2 版本. 数据库:PostgreSQL v10.x 一顿操作猛如虎,直接用 dotne ...
- MINA框架
一.小程序MINA框架分为三个部分: 有 View(视图层).App Service(逻辑层)和 Natice(系统层). 1.View(视图层) 视图层包含了小程序多个页面.每个页面都有WXML文件 ...
- java String字符串总结
这里我们将总结字符串相关的知识,除了总结String的API用法,同时我们还会总结一些相关的知识点,包括字符串常量池.StringBuffer.StringBuilder,以及equals和==的用法 ...
- Lucene和索引
全文索引的原理: 是 扫描每个词 对每个词创建索引,指明这个词在文章出现的次数和位置 全文检索的流程:对 检索的对象(文章,文档,网页内容) 预先建立 文档域 和 索引域 ,在索引域会分词创建索引,然 ...
- Redis 学习笔记1:数据类型
Redis支持五种数据类型:string(字符串),hash(哈希),list(列表),set(集合)及 zset(sorted set:有序集合). 一.Redis 数据类型-STRING 1.常用 ...