
Python+Requests+异步线程池爬取视频到本地
1、本次项目为获取梨视频中的视频,再使用异步线程池下载视频到本地
2、获取视频时,其地址中的Url是会动态变化,不播放时src值为图片的地址,播放时src值为mp4格式
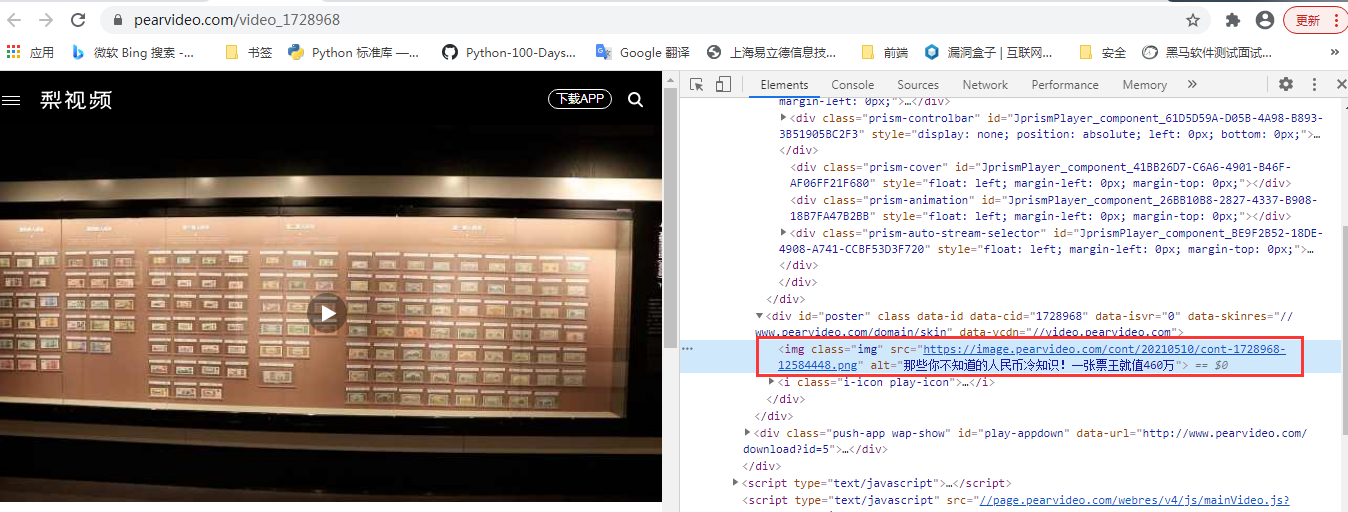

3、查看视频链接是否存在ajax,果然是存在的,但是返回的Url与真实的MP4地址存在部分不一致,此时需要使用字符串替换
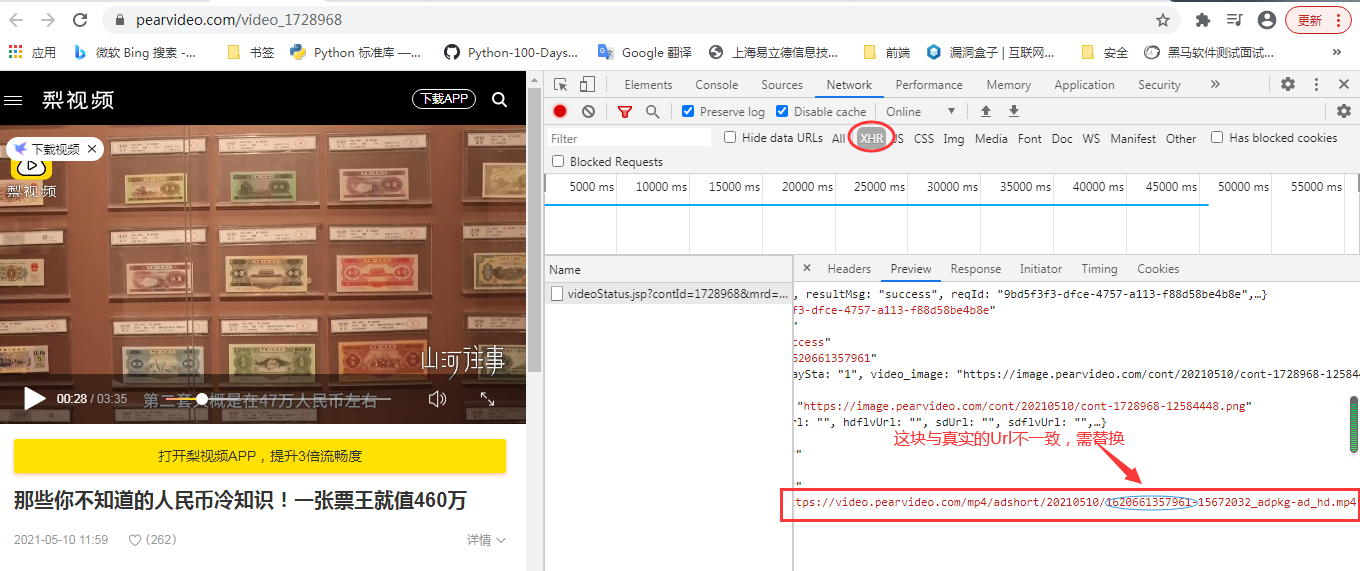
4、获取到真实的mp4视频地址后,再使用二进制流的方式进行下载到本地
5、使用Pool(4),四个线程池进行异步下载,互不干扰
6、源码如下:
import os
import requests
from lxml import etree
import random
import re
#安装fake-useragent库:pip install fake-useragent
from fake_useragent import UserAgent
#导入线程池模块
from multiprocessing.dummy import Pool

# 新建文件存储视频
if not os.path.exists('./threadFile'):
    os.makedirs('./threadFile')

session = requests.Session()
# 存储所有视频的Url及标题
video_urls = []

# 梨视频Url
url = 'https://www.pearvideo.com/'
UA = UserAgent().random

headers = {
    'User-Agent':UA
}
# 获取首页页面数据
page_text = session.get(url=url,headers=headers).text
#对获取的首页页面数据中的相关视频详情链接进行解析
tree = etree.HTML(page_text)
li_list = tree.xpath('//*[@id="vervideoTlist"]/div/ul/li')
for li in li_list:
    # 视频详情页的Url
    detail_url = 'https://www.pearvideo.com/'+li.xpath('./div/a/@href')[0]
    # 视频详情页的Title
    detail_title = li.xpath('./div/a/div[2]/div[2]/text()')[0]+'.mp4'
    page_text = session.get(url=detail_url,headers=headers).text
    # 字符串切割为value值
    value = str("".join(li.xpath('./div/a/@href')[0]).split('_')[-1])
    # 由于存在ajax则使用新的请求地址
    headers_new = {
        'User-Agent': UA,
        'Referer': 'https://www.pearvideo.com/video_{}'.format(value)
    }
    detail_url_new = "https://www.pearvideo.com/videoStatus.jsp?contId={}&mrd={}".format(value,float(random.random()))
    detail_text = session.get(url=detail_url_new,headers=headers_new)
    url = detail_text.json()['videoInfo']['videos']['srcUrl']
    ER = '//(.*?)-'
    list_url= re.findall(ER,url)
    for url1 in list_url:
        if url1.split('/')[-1] in url:
            url = url.replace(url1.split('/')[-1],'cont-{}'.format(value))
        else:
            print('替换失败')
    dic = {
        "url":url,
        "title":detail_title
    }
    video_urls.append(dic)

# 对视频链接发起请求获取视频的二进制数据,然后将视频数据返回
def get_video(dic):
    print(dic['title'],'正在下载....')
    page_content = session.get(url=dic['url'],headers=headers).content
    fileName = './threadFile/'+dic['title']
    # 持久化存储数据
    with open(fileName,'wb') as fp:
        fp.write(page_content)
        print(dic['title'], '下载完成!!!')

#实例化线程池对象
# 使用线程池对视频数据进行请求(较为耗时阻塞的操作)
pool = Pool(4)
pool.map(get_video,video_urls)

# 关闭线程池
pool.close()
pool.join()

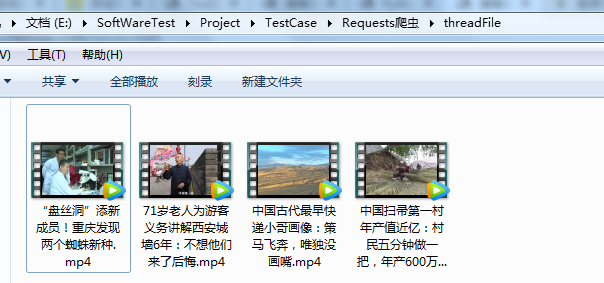
7、下载本地
Python+Requests+异步线程池爬取视频到本地的更多相关文章
- 基于requests模块的cookie,session和线程池爬取
目录 基于requests模块的cookie,session和线程池爬取 基于requests模块的cookie操作 基于requests模块的代理操作 基于multiprocessing.dummy ...
- 使用requests、BeautifulSoup、线程池爬取艺龙酒店信息并保存到Excel中
import requests import time, random, csv from fake_useragent import UserAgent from bs4 import Beauti ...
- 使用requests、re、BeautifulSoup、线程池爬取携程酒店信息并保存到Excel中
import requests import json import re import csv import threadpool import time, random from bs4 impo ...
- Python爬取视频指南
摘自:https://www.jianshu.com/p/9ca86becd86d 前言 前两天尔羽说让我爬一下菜鸟窝的教程视频,这次就跟大家来说说Python爬取视频的经验 正文 https://w ...
- py3+requests+re+urllib,爬取并下载不得姐视频
实现原理及思路请参考我的另外几篇爬虫实践博客 py3+urllib+bs4+反爬,20+行代码教你爬取豆瓣妹子图:http://www.cnblogs.com/UncleYong/p/6892688. ...
- python day 20: 线程池与协程,多进程TCP服务器
目录 python day 20: 线程池与协程 2. 线程 3. 进程 4. 协程:gevent模块,又叫微线程 5. 扩展 6. 自定义线程池 7. 实现多进程TCP服务器 8. 实现多线程TCP ...
- Python爬虫:为什么你爬取不到网页数据
前言: 之前小编写了一篇关于爬虫为什么爬取不到数据文章(文章链接为:Python爬虫经常爬不到数据,或许你可以看一下小编的这篇文章), 但是当时小编也是胡乱编写的,其实里面有很多问题的,现在小编重新发 ...
- Python网络爬虫与如何爬取段子的项目实例
一.网络爬虫 Python爬虫开发工程师,从网站某一个页面(通常是首页)开始,读取网页的内容,找到在网页中的其它链接地址,然后通过这些链接地址寻找下一个网页,这样一直循环下去,直到把这个网站所有的网页 ...
- 进程池爬取并存入mongodb
设置进程池爬取拉钩网: # coding = utf- import json import pymongo import pandas as pd import requests from lxml ...
随机推荐
- Ryzen 4000'Vermeer' CPU和Radeon RX'Big Navi'图形卡
Ryzen 4000'Vermeer' CPU和Radeon RX'Big Navi'图形卡 来自中国媒体的多篇报道表明,AMD都准备在2020年第四季度初推出其下一代Ryzen 4000'Zen 3 ...
- 如何为应用选择最佳的FPGA(下)
如何为应用选择最佳的FPGA(下) How to select an FPGA board? FPGA板的选择在很大程度上受FPGA本身的影响,也受整个板的特性和性能的影响.们已经在上面的章节中讨论了 ...
- python_selenium 之logging模块入门及调用实战
一.logging模块是什么? 是Python内置的标准模块,主要用于输出运行日志 二.日志的作用 日志是代码的必要组成部分 记录日志能显示程序当前运行状态 出问题后定位当时问题 三.python日志 ...
- sql 数据库使用注意事项
1.在对数据库表进行操作时,一定要注意当前操作的是哪一个数据库,否则很容易引起不必要的错误.对于master数据库中的数据文件,尽量不要去对其操作. 2.可通过图形方式对数据库进行备份操作,可通过数据 ...
- 在pycham中安装win32
导言:在应用import win32时,需要先在pycham 中安装pywin32 ,如下为安装步骤. 一.升级pycham中的pip为最新的版本 备注:如果pip不是最新版本,直接安装pywin3 ...
- JUC 并发编程--12, 使用AtomicInteger 实现一把锁(排队自旋锁), 代码演示
前面 使用自旋锁实现了一把锁,(请看 第5篇) volatile 三大特性: 可见性, 不保证原子性, 禁止指令重排 为了解决 volatile不保证原子性的问题, 引入了原子类, AtomicInt ...
- SpringCloud(1)生态与简绍
一:微服务架构简绍学习目标 1.技术架构的演变,怎么一步步到微服务的:2.什么是微服务,优点与缺点 :3.SOA(面向服务)与MicroServices(微服务)的区别 :4.Dubbo 与Spri ...
- .NET Core/.NET5/.NET6 开源项目汇总6:框架与架构设计(DDD、云原生/微服务/容器/DevOps/CICD等)项目
系列目录 [已更新最新开发文章,点击查看详细] 开源项目是众多组织与个人分享的组件或项目,作者付出的心血我们是无法体会的,所以首先大家要心存感激.尊重.请严格遵守每个项目的开源协议后再使用.尊 ...
- linux安装配置交叉编译器arm-linux-gnueabi-gcc
要使我们在x86架构下运行的程序迁移至ARM架构的开发板中运行时,需要通过交叉编译器将x86下编写的程序进行编译后,开发版才能运行. 在安装之前我们需要了解,什么是交叉编译器. 一.下载交叉编译器 这 ...
- zookeeper使用教程
Zookeeper 1. Zookeeper概述 1.1 概述 Zookeeper是一个开源的分布式的,为分布式应用提供协调服务的Apache项目. 1.2 特点 1)Zookeeper: ...