
Python网络爬虫与如何爬取段子的项目实例
一、网络爬虫
Python爬虫开发工程师,从网站某一个页面(通常是首页)开始,读取网页的内容,找到在网页中的其它链接地址,然后通过这些链接地址寻找下一个网页,这样一直循环下去,直到把这个网站所有的网页都抓取完为止。如果把整个互联网当成一个网站,那么网络蜘蛛就可以用这个原理把互联网上所有的网页都抓取下来。
网络爬虫(又被称为网页蜘蛛,网络机器人,在FOAF社区中间,更经常的称为网页追逐者),是一种按照一定的规则,自动的抓取万维网信息的程序或者脚本。网络爬虫另外一些不常使用的名字还有蚂蚁,自动索引,模拟程序或者蠕虫。爬虫就是自动遍历一个网站的网页,并把内容都下载下来.

搜索引擎与网络爬虫
二、通用性搜索引擎(通用爬虫)
随着网络的迅速发展,万维网成为大量信息的载体,如何有效地提取并利用这些信息成为一个巨大的挑战。搜索引擎(Search Engine),例如传统的通用搜索引擎AltaVista,Yahoo!和Google等,作为一个辅助人们检索信息的工具成为用户访问万维网的入口和指南。但是,这些通用性搜索引擎也存在着一定的局限性,如:
(1) 不同领域、不同背景的用户往往具有不同的检索目的和需求,通用搜索引擎所返回的结果包含大量用户不关心的网页。
(2)通用搜索引擎的目标是尽可能大的网络覆盖率,有限的搜索引擎服务器资源与无限的网络数据资源之间的矛盾将进一步加深。
(3)万维网数据形式的丰富和网络技术的不断发展,图片、数据库、音频、视频多媒体等不同数据大量出现,通用搜索引擎往往对这些信息含量密集且具有一定结构的数据无能为力,不能很好地发现和获取。
(4)通用搜索引擎大多提供基于关键字的检索,难以支持根据语义信息提出的查询。
为了解决上述问题,定向抓取相关网页资源的聚焦爬虫应运而生。聚焦爬虫是一个自动下载网页的程序,它根据既定的抓取目标,有选择的访问万维网上的网页与相关的链接,获取所需要的信息。与通用爬虫(general?purpose web crawler)不同,聚焦爬虫并不追求大的覆盖,而将目标定为抓取与某一特定主题内容相关的网页,为面向主题的用户查询准备数据资源。
三、聚焦爬虫实例之爬取段子的爬虫
以糗事百科为例子。
糗事百科是不需要登录的,所以也没必要用到Cookie,另外糗事百科有的段子是附图的,我们把图抓下来图片不便于显示,那么我们就尝试过滤掉有图的段子吧。
好,现在我们尝试抓取一下糗事百科的热门段子吧,每按下一次回车我们显示一个段子。
1.确定URL并抓取页面代码
首先我们确定好页面的URL是 http://www.qiushibaike.com/hot/page/1,其中最后一个数字1代表页数,我们可以传入不同的值来获得某一页的段子内容。
我们初步构建如下的代码来打印页面代码内容试试看,先构造最基本的页面抓取方式,看看会不会成功
\# -*- coding:utf-8 -*-

import urllib

import urllib2

page = 1

url = 'http://www.qiushibaike.com/hot/page/' + str(page)

try:

    request = urllib2.Request(url)

    response = urllib2.urlopen(request)

    print response.read()

except urllib2.URLError, e:

    if hasattr(e,"code"):

        print e.code

    if hasattr(e,"reason"):

        print e.reason
运行程序,哦不,它竟然报错了,真是时运不济,命途多舛啊
line 373, in _read_status

 raise BadStatusLine(line)

httplib.BadStatusLine: ''
好吧,应该是headers验证的问题,我们加上一个headers验证试试看吧,将代码修改如下
\# -*- coding:utf-8 -*-

import urllib

import urllib2

page = 1

url = 'http://www.qiushibaike.com/hot/page/' + str(page)

user_agent = 'Mozilla/4.0 (compatible; MSIE 5.5; Windows NT)'

headers = { 'User-Agent' : user_agent }

try:

    request = urllib2.Request(url,headers = headers)

    response = urllib2.urlopen(request)

    print response.read()

except urllib2.URLError, e:

    if hasattr(e,"code"):

        print e.code

    if hasattr(e,"reason"):

        print e.reason
嘿嘿,这次运行终于正常了,打印出了第一页的HTML代码,大家可以运行下代码试试看。在这里运行结果太长就不贴了。
2.提取某一页的所有段子
好,获取了HTML代码之后,我们开始分析怎样获取某一页的所有段子。
首先我们审查元素看一下,按浏览器的F12,截图如下
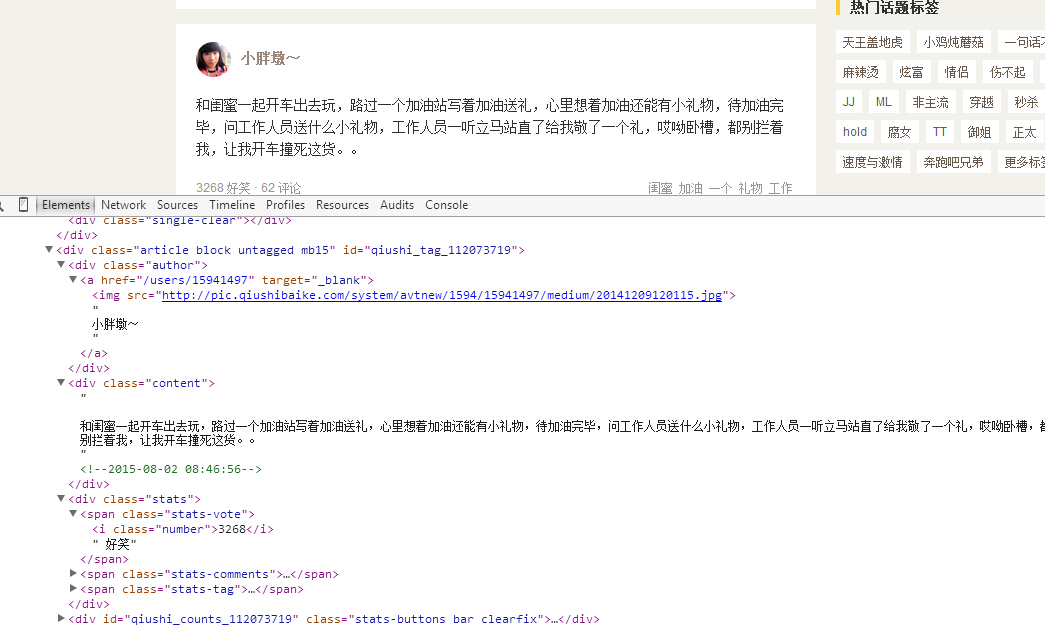
我们可以看到,每一个段子都是
content = response.read().decode('utf-8')

pattern = re.compile('<div.*?author">.*?<a.*?<img.*?>(.*?)</a>.*?<div.*?'+

                         'content">(.*?)<!--(.*?)-->.*?</div>(.*?)<div class="stats.*?class="number">(.*?)</i>',re.S)

items = re.findall(pattern,content)

for item in items:

    print item[0],item[1],item[2],item[3],item[4]
现在正则表达式在这里稍作说明
1. ? 是一个固定的搭配,.和代表可以匹配任意无限多个字符,加上?表示使用非贪婪模式进行匹配,也就是我们会尽可能短地做匹配,以后我们还会大量用到 .*? 的搭配。
2. (.?)代表一个分组,在这个正则表达式中我们匹配了五个分组,在后面的遍历item中,item[0]就代表第一个(.?)所指代的内容,item[1]就代表第二个(.*?)所指代的内容,以此类推。
3. re.S 标志代表在匹配时为点任意匹配模式,点 . 也可以代表换行符。
这样我们就获取了发布人,发布时间,发布内容,附加图片以及点赞数。
在这里注意一下,我们要获取的内容如果是带有图片,直接输出出来比较繁琐,所以这里我们只获取不带图片的段子就好了。
所以,在这里我们就需要对带图片的段子进行过滤。
我们可以发现,带有图片的段子会带有类似下面的代码,而不带图片的则没有,所以,我们的正则表达式的item[3]就是获取了下面的内容,如果不带图片,item[3]获取的内容便是空。
<div class="thumb">

<a href="/article/112061287?list=hot&s=4794990" target="_blank">

<img src="http://pic.qiushibaike.com/system/pictures/11206/112061287/medium/app112061287.jpg" alt="但他们依然乐观">

</a>

</div>
所以我们只需要判断item[3]中是否含有img标签就可以了。
好,我们再把上述代码中的for循环改为下面的样子
for item in items:

        haveImg = re.search("img",item[3])

        if not haveImg:

            print item[0],item[1],item[2],item[4]
现在,整体的代码如下
\# -*- coding:utf-8 -*-

import urllib

import urllib2

import re

page = 1

url = 'http://www.qiushibaike.com/hot/page/' + str(page)

user_agent = 'Mozilla/4.0 (compatible; MSIE 5.5; Windows NT)'

headers = { 'User-Agent' : user_agent }

try:

    request = urllib2.Request(url,headers = headers)

    response = urllib2.urlopen(request)

    content = response.read().decode('utf-8')

    pattern = re.compile('<div.*?author">.*?<a.*?<img.*?>(.*?)</a>.*?<div.*?'+

                         'content">(.*?)<!--(.*?)-->.*?</div>(.*?)<div class="stats.*?class="number">(.*?)</i>',re.S)

    items = re.findall(pattern,content)

    for item in items:

        haveImg = re.search("img",item[3])

        if not haveImg:

            print item[0],item[1],item[2],item[4]

except urllib2.URLError, e:

    if hasattr(e,"code"):

        print e.code

    if hasattr(e,"reason"):

        print e.reaso
运行一下看下效果:
这之中省去1千字。。。。。。
不要喷我,我给你们准备了最好的礼物:
尚学堂Python爬虫实战项目-如何爬取段子的视频教程。
大家可以找可爱又美丽的Teacher 唐 获取下载地址吧!
她的扣扣是2056217415 ,,17301781330
Python网络爬虫与如何爬取段子的项目实例的更多相关文章
- Python 网络爬虫 002 (入门) 爬取一个网站之前,要了解的知识
网站站点的背景调研 1. 检查 robots.txt 网站都会定义robots.txt 文件,这个文件就是给 网络爬虫 来了解爬取该网站时存在哪些限制.当然了,这个限制仅仅只是一个建议,你可以遵守,也 ...
- 【Python网络爬虫三】 爬取网页新闻
学弟又一个自然语言处理的项目,需要在网上爬一些文章,然后进行分词,刚好牛客这周的是从一个html中找到正文,就实践了一下.写了一个爬门户网站新闻的程序 需求: 从门户网站爬取新闻,将新闻标题,作者,时 ...
- 精通python网络爬虫之自动爬取网页的爬虫 代码记录
items的编写 # -*- coding: utf-8 -*- # Define here the models for your scraped items # # See documentati ...
- python网络爬虫之四简单爬取豆瓣图书项目
一.爬虫项目一: 豆瓣图书网站图书的爬取: import requests import re content = requests.get("https://book.douban.com ...
- Python 网络爬虫实战:爬取 B站《全职高手》20万条评论数据
本周我们的目标是:B站(哔哩哔哩弹幕网 https://www.bilibili.com )视频评论数据. 我们都知道,B站有很多号称“镇站之宝”的视频,拥有着数量极其恐怖的评论和弹幕.所以这次我们的 ...
- 网络爬虫之scrapy爬取某招聘网手机APP发布信息
1 引言 过段时间要开始找新工作了,爬取一些岗位信息来分析一下吧.目前主流的招聘网站包括前程无忧.智联.BOSS直聘.拉勾等等.有段时间时间没爬取手机APP了,这次写一个爬虫爬取前程无忧手机APP岗位 ...
- Python——初识网络爬虫(网页爬取)
网络爬虫(又称为网页蜘蛛,网络机器人,在FOAF社区中间,更经常的称为网页追逐者),是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本.另外一些不常使用的名字还有蚂蚁.自动索引.模拟程序或者蠕虫 ...
- python从爬虫基础到爬取网络小说实例
一.爬虫基础 1.1 requests类 1.1.1 request的7个方法 requests.request() 实例化一个对象,拥有以下方法 requests.get(url, *args) r ...
- 【Python网络爬虫三】 爬去网页新闻
学弟又一个自然语言处理的项目,需要在网上爬一些文章,然后进行分词,刚好牛客这周的是从一个html中找到正文,就实践了一下.写了一个爬门户网站新闻的程序 需求: 从门户网站爬取新闻,将新闻标题,作者,时 ...
随机推荐
- python介绍及下载
python介绍 Python是一种计算机程序设计语言.是一种面向 对象的动态类型语言,支出被设计用于编写自动化脚本(shell),随着版本的不断更新和语言新功能的添加,越来越多的被用于独立的.大型醒 ...
- 五 Zabbix全网监控
监控的作用 我们的职责 1.保障企业数据的安全可靠. 2.为客户提供7*24小时服务. 3.不断提升用户的体验.在关键时刻,提前提醒我们服务器要出问题了当出问题之后,可以便于找到问题的根源 ...
- 利用广度优先搜索(BFS)与深度优先搜索(DFS)实现岛屿个数的问题(java)
需要说明一点,要成功运行本贴代码,需要重新复制我第一篇随笔<简单的循环队列>代码(版本有更新). 进入今天的主题. 今天这篇文章主要探讨广度优先搜索(BFS)结合队列和深度优先搜索(DFS ...
- SEH exception with code 0xc0000005 thrown in the test body
在用Visual Studio时遇到这个报错.原因:访问了非法的内存地址. 这个问题不应该被忽略,通常是代码有bug. 解决办法: VS2013: 菜单->Debug->Exception ...
- 利用Skywalking-netcore监控你的应用性能
Skywalking SkyWalking开源项目由吴晟于2015年创建,同年10月在GitHub上作为个人项目开源. SkyWalking项目的核心目标,是针对微服务.Cloud Native.容器 ...
- UOJ#345. 【清华集训2017】榕树之心 贪心,动态规划
原文链接https://www.cnblogs.com/zhouzhendong/p/UOJ345.html 前言 我真的是越来越菜了,连树形DP都感觉陌生了. 题解 首先,我们来看看在不断生长叶子会 ...
- Linux学习之shell
通配符 *:表示从它所在位置开始到某个符合条件的结束符之间的任何字符 ?:表示它所在位置上的任何可能的单个字符 []:表示[]中所包含字符的任何一个 特殊键 ctrl+c #停止当前程序执行 ctr ...
- TCP/IP详解 卷一学习笔记(转载)
https://blog.csdn.net/cpcpcp123/article/details/51259498
- ssh登录远程服务器
在终端输入ssh 用户名@IP地址, 比如输入用户名和密码,进入目录,即可查看修改文件,启动服务. 这和安装xshell和filelizza,终端有什么区别? useradd guangbo pas ...
- Windows本地代码仓库使用连接教程
目录 软件安装 修改语言为中文 克隆远程仓库 文件上传教程 软件安装 安装Git(软件下载链接) 根据自己的系统选择对应版本下载安装 安装TortoiseGit(软件下载链接) 1.下载完毕解压文件夹 ...