
python中常用的九种数据预处理方法分享
Spyder Ctrl + 4/5: 块注释/块反注释
本文总结的是我们大家在python中常见的数据预处理方法,以下通过sklearn的preprocessing模块来介绍;
1. 标准化(Standardization or Mean Removal and Variance Scaling)
变换后各维特征有0均值,单位方差。也叫z-score规范化(零均值规范化)。计算方式是将特征值减去均值,除以标准差。
sklearn.preprocessing.scale(X)
一般会把train和test集放在一起做标准化,或者在train集上做标准化后,用同样的标准化器去标准化test集,此时可以用scaler
scaler = sklearn.preprocessing.StandardScaler().fit(train)

scaler.transform(train)

scaler.transform(test)
实际应用中,需要做特征标准化的常见情景:SVM
2. 最小-最大规范化
最小-最大规范化对原始数据进行线性变换,变换到[0,1]区间(也可以是其他固定最小最大值的区间)
min_max_scaler = sklearn.preprocessing.MinMaxScaler()

min_max_scaler.fit_transform(X_train)
或者
import numpy as np

a = np.random.random((2, 3, 3))

def customMinMaxScaler(X):

    return (X - X.min()) / (X.max() - X.min())

np.array([customMinMaxScaler(x) for x in a])
3.规范化(Normalization)
规范化是将不同变化范围的值映射到相同的固定范围,常见的是[0,1],此时也称为归一化。
将每个样本变换成unit norm。
X = [[ 1, -1, 2],[ 2, 0, 0], [ 0, 1, -1]]

sklearn.preprocessing.normalize(X, norm='l2')
得到:
array([[ 0.40, -0.40, 0.81], [ 1, 0, 0], [ 0, 0.70, -0.70]])
可以发现对于每一个样本都有,0.4^2+0.4^2+0.81^2=1,这就是L2 norm,变换后每个样本的各维特征的平方和为1。类似地,L1 norm则是变换后每个样本的各维特征的绝对值和为1。还有max norm,则是将每个样本的各维特征除以该样本各维特征的最大值。
在度量样本之间相似性时,如果使用的是二次型kernel,需要做Normalization
4. 特征二值化(Binarization)
给定阈值,将特征转换为0/1
binarizer = sklearn.preprocessing.Binarizer(threshold=1.1)

binarizer.transform(X)
5. 标签二值化(Label binarization)
lb = sklearn.preprocessing.LabelBinarizer()
6. 类别特征编码
有时候特征是类别型的,而一些算法的输入必须是数值型,此时需要对其编码。
enc = preprocessing.OneHotEncoder()

enc.fit([[0, 0, 3], [1, 1, 0], [0, 2, 1], [1, 0, 2]])

enc.transform([[0, 1, 3]]).toarray() #array([[ 1., 0., 0., 1., 0., 0., 0., 0., 1.]])
上面这个例子,第一维特征有两种值0和1,用两位去编码。第二维用三位,第三维用四位。
另一种编码方式
newdf=pd.get_dummies(df,columns=["gender","title"],dummy_na=True)
7.标签编码(Label encoding)
le = sklearn.preprocessing.LabelEncoder()

le.fit([1, 2, 2, 6])

le.transform([1, 1, 2, 6]) #array([0, 0, 1, 2])

#非数值型转化为数值型

le.fit(["paris", "paris", "tokyo", "amsterdam"])

le.transform(["tokyo", "tokyo", "paris"]) #array([2, 2, 1])
8.特征中含异常值时
sklearn.preprocessing.robust_scale
9.生成多项式特征
这个其实涉及到特征工程了,多项式特征/交叉特征。
poly = sklearn.preprocessing.PolynomialFeatures(2)

poly.fit_transform(X)
原始特征:
转化后: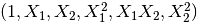
总结
以上就是为大家总结的python中常用的九种预处理方法分享,希望这篇文章对大家学习或者使用python能有一定的帮助,如果有疑问大家可以留言交流。
python中常用的九种数据预处理方法分享的更多相关文章
- python中常用的九种预处理方法
本文总结的是我们大家在python中常见的数据预处理方法,以下通过sklearn的preprocessing模块来介绍; 1. 标准化(Standardization or Mean Removal ...
- iOS中常用的四种数据持久化方法简介
iOS中常用的四种数据持久化方法简介 iOS中的数据持久化方式,基本上有以下四种:属性列表.对象归档.SQLite3和Core Data 1.属性列表涉及到的主要类:NSUserDefaults,一般 ...
- .NET中常用的几种解析JSON方法
一.基本概念 json是什么? JSON:JavaScript 对象表示法(JavaScript Object Notation). JSON 是一种轻量级的数据交换格式,是存储和交换文本信息的语法. ...
- Android中常用的五种数据存储方式
第一种: 使用SharedPreferences存储数据 适用范围: 保存少量的数据,且这些数据的格式非常简单:字符串型.基本类型的值.比如应用程序的各种配置信息(如是否打开音效.是否使用震动效果.小 ...
- iOS中常用的四种数据持久化技术
iOS中的数据持久化方式,基本上有以下四种:属性列表 对象归档 SQLite3和Core Data 1.属性列表涉及到的主要类:NSUserDefaults,一般 [NSUserDefaults st ...
- JavaScript中常用的几种类型检测方法
javascript中类型检测方法有很多: typeof instanceof Object.prototype.toString constructor duck type 1.typeof 最常见 ...
- iPhone开发 数据持久化总结(终结篇)—5种数据持久化方法对比
iPhone开发 数据持久化总结(终结篇)—5种数据持久化方法对比 iphoneiPhoneIPhoneIPHONEIphone数据持久化 对比总结 本篇对IOS中常用的5种数据持久化方法进行简单 ...
- 【转载】Python编程中常用的12种基础知识总结
Python编程中常用的12种基础知识总结:正则表达式替换,遍历目录方法,列表按列排序.去重,字典排序,字典.列表.字符串互转,时间对象操作,命令行参数解析(getopt),print 格式化输出,进 ...
- Python编程中常用的12种基础知识总结
原地址:http://blog.jobbole.com/48541/ Python编程中常用的12种基础知识总结:正则表达式替换,遍历目录方法,列表按列排序.去重,字典排序,字典.列表.字符串互转,时 ...
随机推荐
- Spring中实现多数据源事务管理
文章转自 https://www.2cto.com/kf/201507/424229.html 前言 由于项目中引入了多个数据源,并且需要对多个数据源进行写操作,那么多数据源的事务管理自然成了不可避 ...
- zabbix学习-如何部署一个agent客户端
1. 部署一个agent客户端很简单,比如监控服务器本身 yum install zabbix-agent -y 2.配置文件位置: vim /etc/zabbix/zabbix-agendt.con ...
- esp-adf Element PipeLine
audio_element: 开发基于ADF的程序软件最基本的模块就是audio_element对象.所有的编码.解码.过滤.输入流.输出流实际上都是audio_element.(这个是官方的文件我翻 ...
- 办公室的远程传文件 的命令三种方式linux
不同的Linux之间copy文件常用有3种方法: 第一种就是ftp,也就是其中一台Linux安装ftp Server,这样可以另外一台使用ftp的client程序来进行文件的copy. 第二种方法就是 ...
- mysql的聚簇索引与非聚簇索引的简短总结
[原文]https://www.jianshu.com/p/72763d47aa1a 在mysql数据库中,myisam引擎和innodb引擎使用的索引类型不同,myisam对应的是非聚簇索引,而in ...
- Bluedroid 函数分析:BTA_GATTC_Open
进行GATT 通信,首先要打开GATT 的通道.下面我们分析BTA_GATTC_Open 这个函数: 这个函数在bta_gattc_api.c 文件中定义,这个是一个接口文件,里面没有做真正的open ...
- 值类型和引用类型的区别,struct和class的区别
C#值类型和引用类型 1.简单比较 值类型的变量直接存储数据,而引用类型的变量持有的是数据的引用,数据存储在数据堆中. 值类型(value type):byte,short,int,long,floa ...
- Bash Shebang 小结
在 shell(Bash 是一种 shell) 中执行外部程序和脚本时,Linux 内核会启动一个新的进程,以便在新的进程中执行指定的程序或脚本.内核知道该如何为编译型的程序做这件事,但是对于脚本程序 ...
- 一文让你熟练掌握Linux的ncat(nc)命令
一文让你熟练掌握Linux的ncat(nc)命令 ncat 或者说 nc 是一款功能类似 cat 的工具,但是是用于网络的.它是一款拥有多种功能的 CLI 工具,可以用来在网络上读.写以及重定向数据. ...
- React Native 教程:001 - 如何运行官方控件示例 App
原文发表于我的技术博客 本文主要讲解了如何运行 React Native 官方控件示例 App,包含了一些 React Native 的基础知识以及相关环境的配置. 原文发表于我的技术博客 React ...