
用keras作CNN卷积网络书本分类(书本、非书本)
本文介绍如何使用keras作图片分类(2分类与多分类,其实就一个参数的区别。。。呵呵)
先来看看解决的问题:从一堆图片中分出是不是书本,也就是最终给图片标签上:“书本“、“非书本”,简单吧。
先来看看网络模型,用到了卷积和全连接层,最后套上SOFTMAX算出各自概率,输出ONE-HOT码,主要部件就是这些,下面的nb_classes就是用来控制分类数的,本文是2分类:
from keras.models import Sequential

from keras.layers.core import Dense, Dropout, Activation, Flatten

from keras.layers.convolutional import Convolution2D, MaxPooling2D

from keras.optimizers import SGD

def Net_model(nb_classes, lr=0.001,decay=1e-6,momentum=0.9):

    model = Sequential()

    model.add(Convolution2D(filters=10, kernel_size=(5,5),

                            padding='valid',

                            input_shape=(200, 200, 3)))

    model.add(Activation('tanh'))

    model.add(MaxPooling2D(pool_size=(2, 2)))

    model.add(Convolution2D(filters=20, kernel_size=(10,10)))

    model.add(Activation('tanh'))

    model.add(MaxPooling2D(pool_size=(2, 2)))

    model.add(Dropout(0.25))

    model.add(Flatten())

    model.add(Dense(1000))

    model.add(Activation('tanh'))

    model.add(Dropout(0.5))

    model.add(Dense(nb_classes))

    model.add(Activation('softmax'))

    sgd = SGD(lr=lr, decay=decay, momentum=momentum, nesterov=True)

    model.compile(loss='categorical_crossentropy', optimizer=sgd)

    return model
上面的input_shape=(200, 200, 3)代表图片像素大小为宽高为200,200,并且包含RGB 3通道的图片,不是灰度图片(只要1个通道)
也就是说送入此网络的图片宽高必须200*200*3;如果不是这个shape就需要resize到这个shape
下面来看看训练程序,首先肯定是要收集些照片,书本、非书本的照片,我是分别放在了0文件夹和1文件夹下了,再带个验证用途的文件夹validate:

训练程序涉及到几个地方:照片文件的读取、模型加载训练与保存、可视化训练过程中的损失函数value
照片文件的读取
import cv2

import os

import numpy as np

import keras

def loadImages():

    imageList=[]

    labelList=[]

    rootdir="d:\\books\\0"

    list =os.listdir(rootdir)

    for item in list:

        path=os.path.join(rootdir,item)

        if(os.path.isfile(path)):

            f=cv2.imread(path)

            f=cv2.resize(f, (200, 200))#resize到网络input的shape

            imageList.append(f)

            labelList.append(0)#类别0

    rootdir="d:\\books\\1"

    list =os.listdir(rootdir)

    for item in list:

        path=os.path.join(rootdir,item)

        if(os.path.isfile(path)):

            f=cv2.imread(path)

            f=cv2.resize(f, (200, 200))#resize到网络input的shape

            imageList.append(f)

            labelList.append(1)#类别1

    return np.asarray(imageList), keras.utils.to_categorical(labelList, 2)
关于(200,200)这个shape怎么得来的,只是几月前开始玩opencv时随便写了个数值,后来想利用那些图片,就适应到这个shape了
keras.utils.to_categorical函数类似numpy.onehot、tf.one_hot这些,只是one hot的keras封装
模型加载训练与保存
nb_classes = 2

nb_epoch = 30

nb_step = 6

batch_size = 3

x,y=loadImages()

from keras.preprocessing.image import ImageDataGenerator

dataGenerator=ImageDataGenerator()

dataGenerator.fit(x)

data_generator=dataGenerator.flow(x, y, batch_size, True)#generator函数,用来生成批处理数据(从loadImages中)

model=NetModule.Net_model(nb_classes=nb_classes, lr=0.0001) #加载网络模型

history=model.fit_generator(data_generator, epochs=nb_epoch, steps_per_epoch=nb_step, shuffle=True)#训练网络,并且返回每次epoch的损失value

model.save_weights('D:\\Documents\\Visual Studio 2017\\Projects\\ConsoleApp9\\PythonApplication1\\书本识别\\trained_model_weights.h5')#保存权重

print("DONE, model saved in path-->D:\\Documents\\Visual Studio 2017\\Projects\\ConsoleApp9\\PythonApplication1\\书本识别\\trained_model_weights.h5")
ImageDataGenerator构造函数有很多参数,主要用来提升数据质量,比如要不要标准化数字
lr=0.001这个参数要看经验,大了会导致不收敛,训练的时候经常由于这个参数的问题导致重复训练,这在没有GPU的情况下很是痛苦。。痛苦。。。痛苦。。。
model.save_weights是保存权重,但是不保存网络模型 ,对应的是model.load_weights方法
model.save是保存网络+权重,只是。。。。此例中用save_weights保存的h5文件是125M,但用save方法保存后,h5文件就增大为280M了。。。
上面2个save方法都能finetune,只是灵活度不一样。
可视化训练过程中的损失函数value
import matplotlib.pyplot as plt

plt.plot(history.history['loss'])

plt.show()
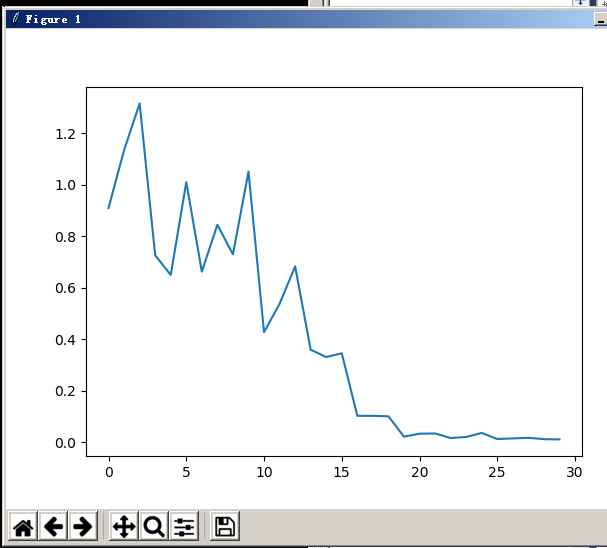
貌似没啥好补充的。。。
AND。。。。看看预测部分吧,这部分加载图片、加载模型,似乎都和训练部分雷同:
def loadImages():

    imageList=[]

    rootdir="d:\\books\\validate"

    list =os.listdir(rootdir)

    for item in list:

        path=os.path.join(rootdir,item)

        if(os.path.isfile(path)):

            f=cv2.imread(path)

            f=cv2.resize(f, (200, 200))

            imageList.append(f)

    return np.asarray(imageList)

x=loadImages()

x=np.asarray(x)

model=NetModule.Net_model(nb_classes=2, lr=0.0001)

model.load_weights('D:\\Documents\\Visual Studio 2017\\Projects\\ConsoleApp9\\PythonApplication1\\书本识别\\trained_model_weights.h5')

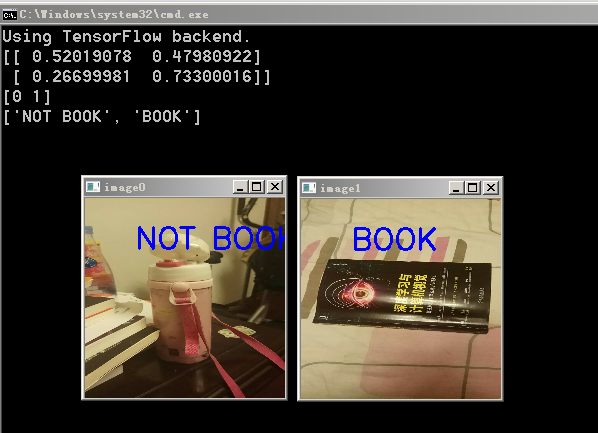
print(model.predict(x))

print(model.predict_classes(x))

y=convert2label(model.predict_classes(x))

print(y)
predict的返回其实是softmax层返回的概率数值,是<=1的float
predict_classes返回的是经过one-hot处理后的数值,此时只有0、1两种数值(最大的value会被返回称为1,其他都为0)
convert2label:
def convert2label(vector):

    string_array=[]

    for v in vector:

        if v==1:

            string_array.append('BOOK')

        else:

            string_array.append('NOT BOOK')

    return string_array
这个函数是用来把0、1转换成文本的,小插曲:
本来这里是中文的“书本”、“非书本”,后来和女儿一起调试时发现都显示成了问号,应该是中文字符问题,就改成了英文显示,和女儿一起写代码是种乐趣啊!
本来只是显示文本,感觉太无聊了,因此加上了opencv显示图片+分类文本的代码段:
for i in range(len(x)):

    cv2.putText(x[i], y[i], (50,50), cv2.FONT_HERSHEY_SIMPLEX, 1, 255, 2)

    cv2.imshow('image'+str(i), x[i])

cv2.waitKey(-1)
OK, 2018年继续学习,继续科学信仰。
用keras作CNN卷积网络书本分类(书本、非书本)的更多相关文章
- 1. CNN卷积网络-初识
1. CNN卷积网络-初识 2. CNN卷积网络-前向传播算法 3. CNN卷积网络-反向更新 1. 前言 卷积神经网络是一种特殊的深层的神经网络模型,它的特殊性体现在两个方面, 它的神经元间的连接是 ...
- 3. CNN卷积网络-反向更新
1. CNN卷积网络-初识 2. CNN卷积网络-前向传播算法 3. CNN卷积网络-反向更新 1. 前言 如果读者详细的了解了DNN神经网络的反向更新,那对我们今天的学习会有很大的帮助.我们的CNN ...
- 2. CNN卷积网络-前向传播算法
1. CNN卷积网络-初识 2. CNN卷积网络-前向传播算法 3. CNN卷积网络-反向更新 1. 前言 我们已经了解了CNN的结构,CNN主要结构有输入层,一些卷积层和池化层,后面是DNN全连接层 ...
- Deeplearning 两层cnn卷积网络详解
https://blog.csdn.net/u013203733/article/details/79074452 转载地址: https://www.cnblogs.com/sunshineatno ...
- 用keras的cnn做人脸分类
keras介绍 Keras是一个简约,高度模块化的神经网络库.采用Python / Theano开发. 使用Keras如果你需要一个深度学习库: 可以很容易和快速实现原型(通过总模块化,极简主义,和可 ...
- keras搭建密集连接网络/卷积网络/循环网络
输入模式与网络架构间的对应关系: 向量数据:密集连接网络(Dense层) 图像数据:二维卷积神经网络 声音数据(比如波形):一维卷积神经网络(首选)或循环神经网络 文本数据:一维卷积神经网络(首选)或 ...
- 用Keras搭建神经网络 简单模版(三)—— CNN 卷积神经网络(手写数字图片识别)
# -*- coding: utf-8 -*- import numpy as np np.random.seed(1337) #for reproducibility再现性 from keras.d ...
- Keras(四)CNN 卷积神经网络 RNN 循环神经网络 原理及实例
CNN 卷积神经网络 卷积 池化 https://www.cnblogs.com/peng8098/p/nlp_16.html 中有介绍 以数据集MNIST构建一个卷积神经网路 from keras. ...
- 机器学习-计算机视觉和卷积网络CNN
概述 对于计算机视觉的应用现在是非常广泛的,但是它背后的原理其实非常简单,就是将每一个像素的值pixel输入到一个DNN中,然后让这个神经网络去学习这个模型,最后去应用这个模型就可以了.听起来是不是很 ...
随机推荐
- AIO5系统中-打印样式常见问题处理
1.为什么我的报表没有数据显示? 答:请看一下报表是否有绑定数据源,有添加查询,如果这些都做了,请看下主项数据的数据源有没有绑定,这些都绑定了,就会有数据的显示. 2.为什么我做的报表分组很乱? 答: ...
- python学习笔记 map&&reduce
---恢复内容开始--- 1.map 1)map其实相当对吧运算符进行一个抽象,返回的是一个对象,但是这里不知道为什么不可以对一个map返回变量打印两次,难道是因为回收了? def f(x): ret ...
- javac 实现原理
javac 概述 javac 是jdk bin目录下的一个脚本. 用于编译 java程序的源代码,但是 其实现的本质 是基于 jdk 标准类库中的 javac类库实现,所以java的编译器实质上是一个 ...
- JavaScript学习笔记(十五)——对象之Date,RegExp
在学习廖雪峰前辈的JavaScript教程中,遇到了一些需要注意的点,因此作为学习笔记列出来,提醒自己注意! 如果大家有需要,欢迎访问前辈的博客https://www.liaoxuefeng.com/ ...
- Jrebel热部署配置完整教程(IntelliJ IDEA、Jrebel、spring boot、springboot、eclipse、Tomcat)
标签:IntelliJ IDEA.Jrebel.spring boot.springboot.eclipse.Tomcat1.安装插件并激活插件安装参考:http://blog.csdn.net/u0 ...
- Python入门 - 面向对象
python很好的支持面向对象编程,本节主讲类的定义,类的构造方法,类的继承与方法重写,类的多继承. 一.类的定义 class Myclass() : def prt(self, str) : pri ...
- VSCode 同步设置及扩展插件 实现设备上设置统一
准备工作:电脑上需安装VSCode,拥有一个github账户.实现同步的功能主要依赖于VSCode插件 "Settings Sync" Setting Sync 可同步包含的所有扩 ...
- npm install 时报错 Unexpected end of input at 1:15930
从github上clone代码后npm install,结果解决办法: npm config set registry https://registry.npm.taobao.org之后出现自动生成了 ...
- Angular自定义组件实现数据双向数据绑定
学过Angular的同学都知道,输入框通过[(ngModel)]实现双向数据绑定,那么自定义组件能不能实现双向数据绑定呢?答案是肯定的. Angular中,我们常常需要通过方括号[]和圆括号()实现组 ...
- P1378 油滴扩展
题目描述 在一个长方形框子里,最多有N(0≤N≤6)个相异的点,在其中任何一个点上放一个很小的油滴,那么这个油滴会一直扩展,直到接触到其他油滴或者框子的边界.必须等一个油滴扩展完毕才能放置下一个油滴. ...