
java爬虫学习
java尝试爬取一些简单的数据,比python复杂点
示例:爬取网站中的所有古风网名:http://www.oicq88.com/gufeng/,并储存入数据库(mysql)
jdk版本:jdk1.8
编辑器:idea
项目构建:maven
所需jar包:http://jsoup.org/packages/jsoup-1.8.1.jar
或maven依赖如下:
        <dependency>

            <groupId>org.jsoup</groupId>

            <artifactId>jsoup</artifactId>

            <version>1.7.3</version>

        </dependency>
具体代码如下:
package com.ssm.web.timed;

import java.io.IOException;

import java.util.ArrayList;

import java.util.List;

import com.ssm.commons.JsonResp;

import com.ssm.utils.ExportExcel;

import org.apache.log4j.Logger;

import org.jsoup.*;

import org.jsoup.nodes.Document;

import org.jsoup.nodes.Element;

import org.jsoup.select.Elements;

import org.springframework.web.bind.annotation.RequestMapping;

import org.springframework.web.bind.annotation.RestController;

import javax.servlet.http.HttpServletResponse;

@RequestMapping

@RestController

public class TestCrawlerTime {

    private Logger log = Logger.getLogger(this.getClass());

    //根据url从网络获取网页文本

    public static Document getHtmlTextByUrl(String url, String page) {

        Document doc = null;

        try {

            //doc = Jsoup.connect(url).timeout(5000000).get();

            int i = (int) (Math.random() * 1000); //做一个随机延时,防止网站屏蔽

            while (i != 0) {

                i--;

            }

            doc = Jsoup.connect(url + page).data("query", "Java")

                    .userAgent("Mozilla").cookie("auth", "token")

                    .timeout(300000).get();

        } catch (IOException e) {

            /*try {

                doc = Jsoup.connect(url).timeout(5000000).get();

            } catch (IOException e1) {

                e1.printStackTrace();

            }*/

            System.out.println("error: 第一次获取出错");

        }

        return doc;

    }

    //递归查找所有的名字

    public static List getAllNames(List<String> names, String url, String page){

        Document doc = getHtmlTextByUrl(url, page);

        Elements nameTags = doc.select("div[class=listfix] li p");  //名字标签

        for (Element name : nameTags){

            names.add(name.text());

        }

        Elements aTags = doc.select("div[class=page] a[class=next]");   //页数跳转标签

        for (Element aTag : aTags){

            if ("下一页".equals(aTag.text())){                         //是下一页则继续爬取

                String newUrl = aTag.attr("href");

                getAllNames(names, url, newUrl);

            }

        }

        return names;

    }

    /**

    * @Description: 导出爬取到的所有网名

    * @Param:

    * @return:

    * @Author: mufeng

    * @Date: 2018/12/11

    */

    @RequestMapping(value = "/exportNames")

    public JsonResp export(HttpServletResponse response){

        log.info("导出爬取到的所有网名");

        String target = "http://www.oicq88.com/";

        String page = "/gufeng/1.htm";

        List names = new ArrayList();

        getAllNames(names, target, page);

        System.out.println(names.size());

        List<Object[]> lists = new ArrayList<>();

        Integer i = 1;

        for (Object name : names){

            lists.add(new Object[]{i, name});

            i ++;

        }

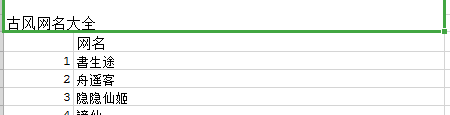
        String[] rowName = new String[]{ "", "网名"};

        ExportExcel exportExcel = new ExportExcel("古风网名大全", rowName, lists);

        try {

            exportExcel.export(response);

        } catch (Exception e) {

            e.printStackTrace();

        }

        return  JsonResp.ok();

    }

    public static void main(String[] args) {

        String target = "http://www.oicq88.com/";

        String page = "/gufeng/1.htm";

        List names = new ArrayList();

        getAllNames(names, target, page);

        System.out.println(names.size());

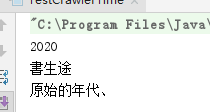
        System.out.println(names.get(0));

        System.out.println(names.get(names.size()-1));

    }

}
运行结果如下:
参考教程:https://www.cnblogs.com/Jims2016/p/5877300.html
https://www.cnblogs.com/qdhxhz/p/9338834.html
https://www.cnblogs.com/sanmubird/p/7857474.html
java爬虫学习的更多相关文章
- Java 爬虫学习
Java爬虫领域最强大的框架是JSoup:可直接解析具体的URL地址(即解析对应的HTML),提供了一套强大的API,包括可以通过DOM.CSS选择器,即类似jQuery方式来取出和操作数据.主要功能 ...
- 半途而废的Java爬虫学习经历
最近在面试,发现Java爬虫对于小数据量数据的爬取的应用还是比较广,抽空周末学习一手,留下学习笔记 Java网络爬虫 简单介绍 爬虫我相信大家都应该知道什么,有什么用,主要的用途就是通过程序自动的去获 ...
- Java爬虫学习(3)之用对象保存新浪微博博文
package com.mieba; import us.codecraft.webmagic.Page; import us.codecraft.webmagic.Site; import us.c ...
- Java爬虫学习(1)之爬取新浪微博博文
本次学习采用了webmagic框架,完成的是一个简单的小demo package com.mieba.spiader; import us.codecraft.webmagic.Page; impor ...
- Java爬虫学习(2)之用对象保存文件demo(1)
package com.mieba.spider; import java.util.ArrayList; import java.util.List; import java.util.Vector ...
- java爬虫案例学习
最近几天很无聊,学习了一下java的爬虫,写一些自己在做这个案例的过程中遇到的问题和一些体会1.学习目标 练习爬取京东的数据,图片+价格+标题等等 2.学习过程 1·开发工具 ...
- (java)Jsoup爬虫学习--获取智联招聘(老网站)的全国java职位信息,爬取10页
Jsoup爬虫学习--获取智联招聘(老网站)的全国java职位信息,爬取10页,输出 职位名称*****公司名称*****职位月薪*****工作地点*****发布日期 import java.io.I ...
- (java)Jsoup爬虫学习--获取网页所有的图片,链接和其他信息,并检查url和文本信息
Jsoup爬虫学习--获取网页所有的图片,链接和其他信息,并检查url和文本信息 此例将页面图片和url全部输出,重点不太明确,可根据自己的需要输出和截取: import org.jsoup.Jsou ...
- 学习Java爬虫文档的学习顺序整理
1.认识正则表达式(Java语言基础) https://www.toutiao.com/i6796233686455943693/ 2.正则表达式学习之简单手机号和邮箱练习 https://www.t ...
随机推荐
- java保存繁体字到数据库时就报错Incorrect string value: '\xF0\xA6\x8D\x8B\xE5\xA4...' for column 'name' at row 1
问题分析 普通的字符串或者表情都是占位3个字节,所以utf8足够用了,但是移动端的表情符号占位是4个字节,普通的utf8就不够用了,为了应对无线互联网的机遇和挑战.避免 emoji 表情符号带来的问题 ...
- 2018.11.01 NOIP训练 树的排列(树形dp)
传送门 跟这道题差不多. 只不过是让权值小的儿子做权值大的儿子的父亲而已. 代码
- vue 开发系列(一) vue 开发环境搭建
概要 目前前端开发技术越来越像后台开发了,有一站式的解决方案. 1.JS包的依赖管理像MAVEN. 2.JS代码编译打包. 3.组件式的开发. vue 是一个前端的一站式的前端解决方案,从项目的初始化 ...
- GDI基础(3):绘制图片
1.CBitmap位图类封装了Windows GDI中的位图和操作位图的成员函数.CPen.CBrush.CFont.CBitmap是常用的Windows GDI对象,和CFont一样,CBitmap ...
- Linux 安装android
---恢复内容开始---http://pan.baidu.com/s/1rvPP8 1.下载eclipse http://pan.baidu.com/s/1kTvNjmv http://www.cr1 ...
- 添加网络ADB的方法(含以太网和无线)
将下面代码添加至packages/apps/Settings/src/com/android/settings/DevelopmentSettings.java 结合之前的添加wifi adb的博客 ...
- sql计算经纬度得出最近距离的公式
sql计算经纬度得出最近距离的公式 //根据经纬度计算两点距离 mappoint //数据库已有字段,商家经纬度 实例:113.272148,23.147299 $lon = "" ...
- 上传文件夹+php
最近公司做工程项目,实现文件夹上传 网上找了很久,发现网上很多代码大都存在很多问题,不过还是让我找到了一个符合要求的项目. 对项目的文件夹上传功能做出分析,找出文件夹上传的原理,对文件夹的传输模式深入 ...
- canvas画的时钟
结合几天来学习的canvas的API,终于完成了一个时钟呵呵 html <!doctype html> <html> <head> <meta charset ...
- 转:【衬线字体与无衬线字体】font-family之Serif和Sans-Serif
CSS的font-family(字体系列)的值有许多,如Arial,Georgia,宋体,幼圆等. 一般可以分为两种,衬线字体(serif)和无衬线字体(sans-serif). 如果字体的笔画有末端 ...