
13-爬取百度贴吧中的图片(python+xpath)
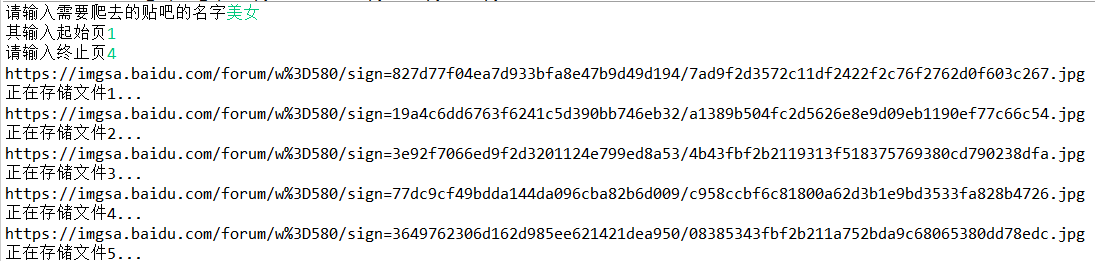
通过xpath分析页面,爬取页面中的图片:
#_*_ coding: utf-8 _*_

'''

Created on 2018年7月15日

@author: sss

function: 使用xpath还处理爬取的数据

'''

from lxml import etree

import urllib

from pip._vendor.distlib.compat import raw_input

from asyncio.tasks import sleep

class Spider:

    def __init__(self):

        self.tiebaName = raw_input('请输入需要爬去的贴吧的名字')

        self.beginPage = int(raw_input('其输入起始页'))

        self.endPage = int(raw_input('请输入终止页'))

        self.url = 'http://tieba.baidu.com/f'

        self.ua_header = {'User-Agent': 'Mozilla/5.0 (compatible; MSIE 9.0; Windows NT 6.1 Trident/5.0;'}

        #图片编号

        self.userName = 1

    #计算爬取页

    def tiebaSpider(self):

        for page in range(self.beginPage, self.endPage + 1):

            pn = (page - 1) * 50 #url中的page number

            word = {'pn': pn, 'kw': self.tiebaName}

            word = urllib.parse.urlencode(word ) #转化为url编码格式

            myUrl = self.url + '?' + word

            #调用页面处理函数load_Page

            #并获取页面的所有帖子链接

            links = self.loadPage(myUrl)

    #开始抓取每个首页所有楼主发帖的标贴连接

    def loadPage(self, url ):

        req = urllib.request.Request(url, headers=self.ua_header)

        html = urllib.request.urlopen(req).read()

        #解析html为html文档

        selector = etree.HTML(html)

        #抓取当前页面的所有帖子的url的后部分,也就是帖子的编号

        # http://tieba.baidu.com/p/4884069807里的 “p/4884069807”

        links = selector.xpath('//div[@class="threadlist_lz clearfix"]/div/a/@href')

        #links类型为etreeElementString列表

        #遍历列表,并且合并成一个帖子地址,调用图片处理函数LoadImage

        for link in links:

            link = 'http://tieba.baidu.com' + link

            self.loadImages(link )

    #抓取每个首页中对应的每个楼主的发布详细页面

    def loadImages(self, link ):

        req = urllib.request.Request(link, headers= self.ua_header)

        html = urllib.request.urlopen(req).read()

        selector = etree.HTML(html)

        #获取这个帖子里的所有图片的src路径

        imagesLinks = selector.xpath('//img[@class="BDE_Image"]/@src')

        #获取图片路径,下载保存

        for imagesLink in imagesLinks:

            self.writeImages(imagesLink)

        print('完成所有下载!')

    #保存页面中的图片

    def writeImages(self, imagesLink):

        """

                    将Images里的二进制内容存入到userNname文件中

        """

        print(imagesLink)

        #通过图片连接获取图片内容:

        images = urllib.request.urlopen(imagesLink).read()

        print('正在存储文件%d...' % self.userName)

        #写入文件:

        with open('./images/' + str(self.userName) + '.png', 'wb') as f:  #存入也该项目同级的images文件夹中

            f.write(images)

        #计数器加一

        self.userName += 1

if __name__ == '__main__':

    mySpider = Spider()

    mySpider.tiebaSpider()
13-爬取百度贴吧中的图片(python+xpath)的更多相关文章
- Python 爬虫练习: 爬取百度贴吧中的图片
背景:最近开始看一些Python爬虫相关的知识,就在网上找了一些简单已与练习的一些爬虫脚本 实现功能:1,读取用户想要爬取的贴吧 2,读取用户先要爬取某个贴吧的页数范围 3,爬取每个贴吧中用户输入的页 ...
- 使用python爬取百度贴吧内的图片
1. 首先通过urllib获取网页的源码 # 定义一个getHtml()函数 def getHtml(url): try: page = urllib.urlopen(url) # urllib.ur ...
- Python学习 —— 爬虫入门 - 爬取Pixiv每日排行中的图片
更新于 2019-01-30 16:30:55 我另外写了一个面向 pixiv 的库:pixiver 支持通过作品 ID 获取相关信息.下载等,支持通过日期浏览各种排行榜(包括R-18),支持通过 p ...
- python 爬取百度翻译进行中英互译
感谢RoyFans 他的博客地址http://www.cnblogs.com/royfans/p/7417914.html import requests def py(): url = 'http: ...
- 写一个python 爬虫爬取百度电影并存入mysql中
目标是利用python爬取百度搜索的电影 在类型 地区 年代各个标签下 电影的名字 评分 和图片连接 以及 电影连接 首先我们先在mysql中建表 create table liubo4( id in ...
- Python爬虫实例(一)爬取百度贴吧帖子中的图片
程序功能说明:爬取百度贴吧帖子中的图片,用户输入贴吧名称和要爬取的起始和终止页数即可进行爬取. 思路分析: 一.指定贴吧url的获取 例如我们进入秦时明月吧,提取并分析其有效url如下 http:// ...
- Python爬虫实战二之爬取百度贴吧帖子
大家好,上次我们实验了爬取了糗事百科的段子,那么这次我们来尝试一下爬取百度贴吧的帖子.与上一篇不同的是,这次我们需要用到文件的相关操作. 前言 亲爱的们,教程比较旧了,百度贴吧页面可能改版,可能代码不 ...
- Python爬虫实战之爬取百度贴吧帖子
大家好,上次我们实验了爬取了糗事百科的段子,那么这次我们来尝试一下爬取百度贴吧的帖子.与上一篇不同的是,这次我们需要用到文件的相关操作. 本篇目标 对百度贴吧的任意帖子进行抓取 指定是否只抓取楼主发帖 ...
- 百度图片爬虫-python版-如何爬取百度图片?
上一篇我写了如何爬取百度网盘的爬虫,在这里还是重温一下,把链接附上: http://www.cnblogs.com/huangxie/p/5473273.html 这一篇我想写写如何爬取百度图片的爬虫 ...
随机推荐
- Python [Leetcode 374]Guess Number Higher or Lower
题目描述: We are playing the Guess Game. The game is as follows: I pick a number from 1 to n. You have t ...
- HTML <meta> http-equiv Attribute 说明
1. 说明 Value Description content-type Specifies the character encoding for the document. Example: & ...
- HPPTS SSL
https加密.解密.及验证过程如下图: HTTPS怎么实现安全传输的? 建立安全传输 HTTPS中, 客户端首先打开一条到WEB服务器443端口的连接. 一旦建立了TCP连接 ,客户端和服务器就会初 ...
- nginx学习资源
在了解nginx的时候 看到的一些资源: https://www.cnblogs.com/EdwinChan/p/8350984.html http://tengine.taobao.org/book ...
- Activity小技巧
随时随地退出程序 新建一个结合类对所有活动进行管理. public class ActivityCollector{ public static List<Activity> activi ...
- appium 中swipe()方法向左滑动时
应该在UI Automator Viewer中读取到的例如ImageView [180,600][900,1320],如果要左滑,代码中应该是写为driver.swipe(900,1320,180,6 ...
- java代码关于匿名内部类和接口的方法使用
总结:主要是多个按钮实现监听时,能够响应不同的事件 以上步骤我们可以用多种方法实现.但人们通常用二种方法.第一种方法是只利用一个监听器以及多个if语句来决定是哪个组件产生的事件:第二种方法是使用多个内 ...
- 小程序中的setData的使用
小程序中的setData setData 函数用于将数据从逻辑层发送到视图层(异步),同时改变对应的 this.data 的值(同步). 直接修改 this.data 而不调用 this.setDat ...
- proc文件系统详解(原创)
Linux系统上的/proc目录是一种文件系统,即proc文件系统.与其它常见的文件系统不同的是,/proc是一种伪文件系统(也即虚拟文件系统),存储的是当前内核运行状态的一系列特殊文件,用户可以通过 ...
- verilog 之语法学习
1.使用非基数表示的十进制视为有符号数.使用基数表示的十进制被视为无符号数. 2.线网中的值被解释为无符号数,整型寄存器中的值被解释为有符号的二进制补码数,. 3.如果选择表达式的值为 x.z,或越界 ...