
大数据框架-spark
相关详细说明:https://www.csdn.net/article/2015-07-10/2825184
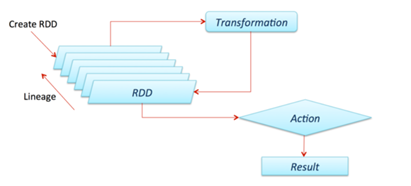
RDD:弹性分布式数据集。
Operation:Transformation 和Action,一个返回RDD,一个返回值。
Lineage:RDD之间的依赖关系,如何演变过来。
Partition:RDD分区,按block切分
narrow dependency(窄依赖) :父RDD全进入子RDD
wide dependency(宽依赖)
Application[一个spark-submit提交的程序]
Job[一个计算序列的最终结果Action操作,多个RDD以及作用于RDD之上的Operation]
stage[计算序列的中间结果]
[划分stage 的重要依据是有无shuflle (数据重组)发生,由DAGSchedule进行划分,Shuffle在Spark中是把父RDD中KV对按照Key重新分区,得到一个新的子RDD,包括这几个操作reduceByKey、groupByKey、sortByKey、countByKey、join、cogroup]
Task[每个partition在一个executor上的Operation是一个Task,即一个thread]
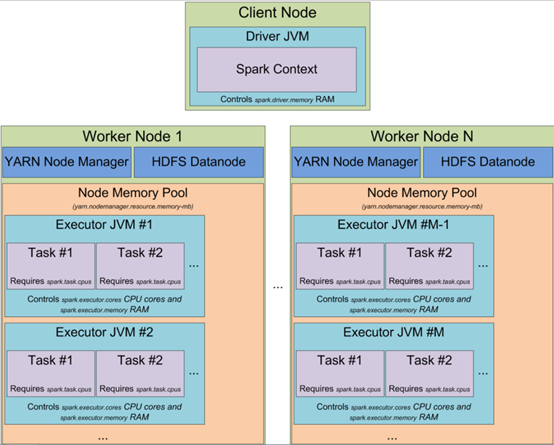
Spark(standalone模式)基本组件;
master(RM):负责资源管理,sparkonYarn模式下就是RM
worker(NM):一个worker可以有多个executor
executor(Container,可以看作资源集合、也可看作task的执行池,一个JVM进程):
当以YARN模式启动spark集群时,可以指定
executors的数量(-num-executors 或者 spark.executor.instances 参数)
executor 固有的内存大小(-executor-memory 或者 spark.executor.memory),executor使用的cpu核数(-executor-cores 或者 spark.executor.cores)
executor分配给每个task的core的数量(spark.task.cpus)
driver 上使用的内存(-driver-memory 或者 spark.driver.memory)。
driver(AppMaster):申请资源并监控任务执行状态。通过DAGScheduler划分形成TaskSet,将具体Task交给对应worker中的executor线程池执行。
大数据框架-spark的更多相关文章
- 老李分享:大数据框架Hadoop和Spark的异同 1
老李分享:大数据框架Hadoop和Spark的异同 poptest是国内唯一一家培养测试开发工程师的培训机构,以学员能胜任自动化测试,性能测试,测试工具开发等工作为目标.如果对课程感兴趣,请大家咨 ...
- 老李分享:大数据框架Hadoop和Spark的异同
poptest是国内唯一一家培养测试开发工程师的培训机构,以学员能胜任自动化测试,性能测试,测试工具开发等工作为目标.如果对课程感兴趣,请大家咨询qq:908821478,咨询电话010-845052 ...
- [转载] 2 分钟读懂大数据框架 Hadoop 和 Spark 的异同
转载自https://www.oschina.net/news/73939/hadoop-spark-%20difference 谈到大数据,相信大家对Hadoop和Apache Spark这两个名字 ...
- 大数据框架对比:Hadoop、Storm、Samza、Spark和Flink
转自:https://www.cnblogs.com/reed/p/7730329.html 今天看到一篇讲得比较清晰的框架对比,这几个框架的选择对于初学分布式运算的人来说确实有点迷茫,相信看完这篇文 ...
- 2分钟读懂大数据框架Hadoop和Spark的异同
转自:https://www.cnblogs.com/reed/p/7730313.html 谈到大数据,相信大家对Hadoop和Apache Spark这两个名字并不陌生.但我们往往对它们的理解只是 ...
- 大数据框架:Spark vs Hadoop vs Storm
大数据时代,TB级甚至PB级数据已经超过单机尺度的数据处理,分布式处理系统应运而生. 知识预热 「专治不明觉厉」之“大数据”: 大数据生态圈及其技术栈: 关于大数据的四大特征(4V) 海量的数据规模( ...
- 大数据框架对比:Hadoop、Storm、Samza、Spark和Flink——flink支持SQL,待看
简介 大数据是收集.整理.处理大容量数据集,并从中获得见解所需的非传统战略和技术的总称.虽然处理数据所需的计算能力或存储容量早已超过一台计算机的上限,但这种计算类型的普遍性.规模,以及价值在最近几年才 ...
- 【互动问答分享】第13期决胜云计算大数据时代Spark亚太研究院公益大讲堂
“决胜云计算大数据时代” Spark亚太研究院100期公益大讲堂 [第13期互动问答分享] Q1:tachyon+spark框架现在有很多大公司在使用吧? Yahoo!已经在长期大规模使用: 国内也有 ...
- 【互动问答分享】第10期决胜云计算大数据时代Spark亚太研究院公益大讲堂
“决胜云计算大数据时代” Spark亚太研究院100期公益大讲堂 [第10期互动问答分享] Q1:Spark on Yarn的运行方式是什么? Spark on Yarn的运行方式有两种:Client ...
随机推荐
- express的proxy实现前后端分离
var express = require('express') var proxy = require('http-proxy-middleware') var app = express() ap ...
- 11.1NOIP模拟赛解题报告
心路历程 预计得分:\(100 + 100 + 50\) 实际得分:\(100 + 100 + 50\) 感觉老师找的题有点水呀. 上来看T1,woc?裸的等比数列求和?然而我不会公式呀..感觉要凉 ...
- Python入门-初始面向对象
之前我们代码基本上都是面向过程的,今天我们就来初始一下python中一个重要的内容:面向对象 一.面向对象和面向过程(重点理解) 1.面向过程: 一切以事物的流程为核心. 核心是"过程&qu ...
- js获取当前日期和时间的代码
最佳答案 var myDate = new Date(); myDate.toLocaleDateString(): //获取当前日期myDate.toLocaleTimeString(); //获取 ...
- C++类继承--构造函数时先构造基类
以下说明继承类函数构造时,先构造基类: 析构基类时,若没加上virtual,只析构基类,不析构派生类: 析构派生类时,同时会析构基类: 1. 基类析构函数有virtual #include <s ...
- Shared Project
从VS2015开始支持Shared Project,挺好的,省去了单独引用的麻烦.
- Sqlite 数据库分页查询(ListView分页显示数据)
下面介绍一下我的这个demo. 流程简述: 我在raw文件夹下面放了名称为city的数据库,里面包含全国2330个城市,以及所属省,拼音简写等信息. 首先 在进入MainActivity的时候,创建数 ...
- Android 保存和恢复activity的状态数据
一般来说, 调用onPause()和onStop()方法后的activity实例仍然存在于内存中, activity的所有信息和状态数据不会消失, 当activity重新回到前台之后, 所有的改变都会 ...
- C# 3.0-c#5.0 变化
最近发现对于C#的使用水平一只停留在3.0的程度 对于4.0 5.0的新特性使用的很少,写一篇文章记录一下增加一下认识. C# 3.5 扩展方法 扩展方法所在的类和扩展方法必须是静态的 并且扩展方法第 ...
- angular自定义指令解决IE89不支持input的placeholder属性
下面代码实测通过,直接copy到本地运行即可. <!DOCTYPE html> <html> <head> <meta charset="UTF-8 ...