
DAGScheduler stage 划分算法
DAGScheduler stage 划分算法
stage划分算法很重要,对于spark开发人员来说,必须对stage划分算法很清晰,知道自己编写的spark Application被划分成了几个job,每个job被划分成了几个stage,每个stage包括哪些代码,这样当发现哪个stage报错或者执行特别慢,才能针对对应代码排查问题和性能调优
stage 划分思想:
由submitStage() 和getMissingParentStage() 组成
会从触发Action操作的那个RDD开始往前,首先为最后一个RDD创建一个stage,然后在往前,如果遇到某个RDD是宽依赖,就会为宽依赖创建一个新的stage,新的RDD就是最新的stage的最后一个RDD,然后以依次类推,继续往前,根据宽依赖或者窄依赖进行stage划分,知直到最后一个RDD遍历完为止
stage划分步骤:
1、使用出发job的最后一个RDD,创建finalStage(创建一个stage对象,并且将stage加入到DAGScheduler内部的内存缓存中)
2、使用finalStage创建一个job(这个job的最后一个stage,就是 finalStage)
3、将job加入到内存缓存中
4、使用 submitStage() 提交 finalStage
提交stage的方法(stage划分算法入口):
调用 getMissingParentStage() 获取当前这个 stage 的父 stage:
往栈中推入stage的最后一个RDD
while循环对stage的最后一个RDD,调用自己定义的visit()方法
visit():如果是窄依赖,将RDD放入栈中,如果是宽依赖,使用宽依赖的那个RDD创建一个stage,将isShuffleMap设为true
提交stage,为stage创建一批task,task数量与Partition数量相同
计算每个task对应的Partition的最佳位置(就是从stage最后一个RDD开始,去找被cache或checkpoint的RDD的Partition,task的最佳位置,就是该Partition的位置,这样task就在那个节点上执行,不需要计算之前的RDD;如果从最后一个RDD到最开始的RDD,都没有被cache或checkpoint,那么最佳位置就是Nil,就是没有最佳位置)
5.、针对stage的task,创建TaskSet对象,调用TaskScheduler的submitTask方法,提交TaskSet,提交到Excutor上去执行
总结如下:
1、从finalstage倒推,
2、通过宽依赖进行新的stage划分
3、使用递归,优先提交父stage
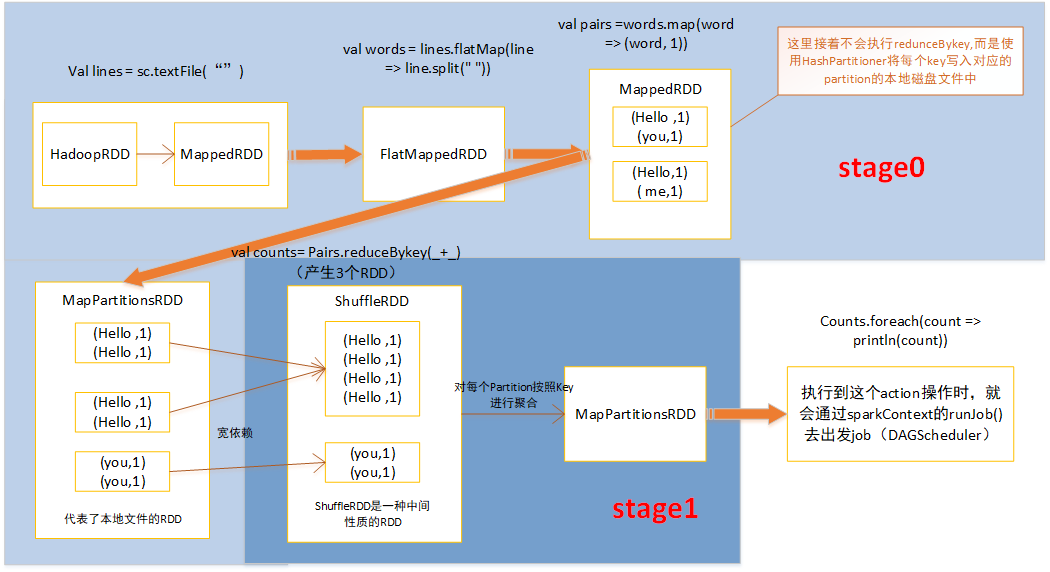
对于每一种有shuffle的操作。底层对应了三个RDD:MapPartitionsRDD、ShuffleRDD、MapPartitionsRDD
DAGScheduler stage 划分算法的更多相关文章
- 17、stage划分算法原理及DAGScheduler源码分析
一.stage划分算法原理 1.图解 二.DAGScheduler源码分析 1. ###org.apache.spark/SparkContext.scala // 调用SparkContext,之前 ...
- Spark源码剖析(八):stage划分原理与源码剖析
引言 对于Spark开发人员来说,了解stage的划分算法可以让你知道自己编写的spark application被划分为几个job,每个job被划分为几个stage,每个stage包括了你的哪些代码 ...
- [Spark内核] 第34课:Stage划分和Task最佳位置算法源码彻底解密
本課主題 Job Stage 划分算法解密 Task 最佳位置算法實現解密 引言 作业调度的划分算法以及 Task 的最佳位置的算法,因为 Stage 的划分是DAGScheduler 工作的核心,这 ...
- Stage划分和Task最佳位置算法源码彻底解密
本课主题 Job Stage 划分算法解密 Task 最佳位置算法实现解密 引言 作业调度的划分算法以及 Task 的最佳计算位置的算法,因为 Stage 的划分是DAGScheduler 工作的核心 ...
- (升级版)Spark从入门到精通(Scala编程、案例实战、高级特性、Spark内核源码剖析、Hadoop高端)
本课程主要讲解目前大数据领域最热门.最火爆.最有前景的技术——Spark.在本课程中,会从浅入深,基于大量案例实战,深度剖析和讲解Spark,并且会包含完全从企业真实复杂业务需求中抽取出的案例实战.课 ...
- 【Spark 深入学习 04】再说Spark底层运行机制
本节内容 · spark底层执行机制 · 细说RDD构建过程 · Job Stage的划分算法 · Task最佳计算位置算法 一.spark底层执行机制 对于Spark底层的运行原理,找到了一副很好的 ...
- Spark任务提交底层原理
Driver的任务提交过程 1.Driver程序的代码运行到action操作,触发了SparkContext的runJob方法.2.SparkContext调用DAGScheduler的runJob函 ...
- 一个Spark job的生命历程
一个job的生命历程 dagScheduler.runJob //(1) --> submitJob ( eventProcessLoop.post(JobSubmitted,***) //(2 ...
- Spark集群基础概念 与 spark架构原理
一.Spark集群基础概念 将DAG划分为多个stage阶段,遵循以下原则: 1.将尽可能多的窄依赖关系的RDD划为同一个stage阶段. 2.当遇到shuffle操作,就意味着上一个stage阶段结 ...
随机推荐
- java-try,return和finally相遇时的各种情况
今天碰到了这样一个问题:使用try,return和finally会碰到的各种情况1,try中有return时,执行顺序:2,try和finally中都有return时,执行顺序:3,运算代码在fina ...
- MFC中如何分割CString类型的数据
[才疏学浅,难免有纰漏,若有不正确的地方,欢迎指教] MFC中有一个库函数 Tokenize(); 函数原型:CStringT Tokenize( PCXSTR pszTokens , int& ...
- selenium学习-拖拽页面元素
一.ActionChains包 模拟鼠标的操作要首先引入ActionChains的包 from selenium.webdriver.common.action_chains import Actio ...
- Creator 2.2.0 终于等来了这款Shader组件神器!一招搞定Effect特效
先看下视频演示: ShaderHelper2支持Creator 2.2.0 视频录完后才想起,还没在微信小游戏中测试,赶紧试试,下面是在微信开发者工具中的截图. 径向模糊 探照灯 提供了一个Shade ...
- Spring MVC(1)Spring MVC的初始化和流程以及SSM的实现
一.Spring MVC概述 1.Spring MVC 的架构 对于持久层而言,随着软件的发展,迁移数据库的可能性很小,所以在大部分情况下都用不到Hibernate的HQL来满足迁移数据库的要求.与此 ...
- 设计模式(十六)Mediator模式
在实际的工作小组的交流过程是,组员向仲裁者报告,仲裁者向组员下达指示,组员之间不再互相询问和指示.Mediator模式是指,当发生麻烦事情的时候,通知仲裁者:当发生涉及全体组员的事情时,也通知仲裁者. ...
- 游图邦YOTUBANG是如何搭建生态系统的?
现在的我们最关心的一个问题就是任何一个行业,如果没有办法很好的落地,就算描绘的非常美好,那也只是空中楼阁.昙花一现而已,它无法实现长久的一个发展.互联网时代呢,就是一个流量为王的一个时代,谁拥有庞大的 ...
- python之ORM(对象关系映射)
实现了数据模型与数据库的解耦,通过简单的配置就可以轻松更换数据库,而不需要更改代码.orm操作本质上会根据对接的数据库引擎,翻译成对应的sql语句.所有使用Django开发的项目无需关心程序底层使用的 ...
- 死磕 java线程系列之线程池深入解析——未来任务执行流程
(手机横屏看源码更方便) 注:java源码分析部分如无特殊说明均基于 java8 版本. 注:线程池源码部分如无特殊说明均指ThreadPoolExecutor类. 简介 前面我们一起学习了线程池中普 ...
- 《JavaScript设计模式与开发实践》-- 发布-订阅模式
详情个人博客:https://shengchangwei.github.io/js-shejimoshi-fabudingyue/ 发布-订阅模式 1.定义 发布-订阅模式:发布-订阅模式又叫观察者模 ...