
详解三种缓存过期策略LFU,FIFO,LRU(附带实现代码)
在学操作系统的时候,就会接触到缓存调度算法,缓存页面调度算法:先分配一定的页面空间,使用页面的时候首先去查询空间是否有该页面的缓存,如果有的话直接拿出来,如果没有的话先查询,如果页面空间没有满的时候,使用新页面的时候,就释放旧的页面空间,把新页面缓存起来,以便下次使用同样的页面的时候方便调用。

缓存调度流程图
缓存机制就是上面所说的那样,但是实现的过程以及淘汰旧页面的机制不同,所以会有不同缓存调度方法,就常见的就是FIFO,LRU,LFU缓存过期策略。
1.FIFO(First In First out):先见先出,淘汰最先近来的页面,新进来的页面最迟被淘汰,完全符合队列。
2.LRU(Least recently used):最近最少使用,淘汰最近不使用的页面
3.LFU(Least frequently used): 最近使用次数最少, 淘汰使用次数最少的页面
下面详细解释三种算法是怎么实现的。下面解释转自http://blog.csdn.net/yangpl_tale/article/details/44998423
一、FIFO
按照“先进先出(First In,First Out)”的原理淘汰数据,正好符合队列的特性,数据结构上使用队列Queue来实现。
如下图:

1. 新访问的数据插入FIFO队列尾部,数据在FIFO队列中顺序移动;
2. 淘汰FIFO队列头部的数据;
二、LRU
(Least recently used,最近最少使用)算法根据数据的历史访问记录来进行淘汰数据,其核心思想是“如果数据最近被访问过,那么将来被访问的几率也更高”。
最常见的实现是使用一个链表保存缓存数据,详细算法实现如下:
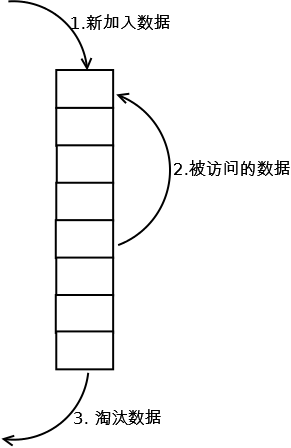
1. 新数据插入到链表头部;
2. 每当缓存命中(即缓存数据被访问),则将数据移到链表头部;
3. 当链表满的时候,将链表尾部的数据丢弃。
三、LFU
(Least Frequently Used)算法根据数据的历史访问频率来淘汰数据,其核心思想是“如果数据过去被访问多次,那么将来被访问的频率也更高”。
LFU的每个数据块都有一个引用计数,所有数据块按照引用计数排序,具有相同引用计数的数据块则按照时间排序。
具体实现如下: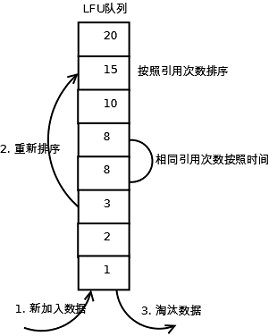
1. 新加入数据插入到队列尾部(因为引用计数为1);
2. 队列中的数据被访问后,引用计数增加,队列重新排序;
3. 当需要淘汰数据时,将已经排序的列表最后的数据块删除。
前面两种算法实现并不算难,LFU实现起来会有点麻烦,下面是我自己考虑的淘汰实现思路,来了页面的时候会发生如下情况
1.判断是否有旧的页面存在,没有则淘汰尾部元素,增加新的元素。
2.有旧页面的存在,查询旧页面的位置,然后把旧页面的元素一直上移到同等次数的页面的上一个元素。
比如说元素(a,1)代表页面为a,调用次数为1,那么在缓存里面集合为{ (f,4), (e,2), (d,2), (c,2), (b,2), (a,1) },这时候调用c页面,只需要用折半查询找到c元素的位置,把c元素存储起来,把c元素到e元素之间的元素(不包含c元素)全部后移一位,然后把c元素放到原来e元素的位置即可。
下面附上三种算法的下载地址:
详解三种缓存过期策略LFU,FIFO,LRU(附带实现代码)的更多相关文章
- 详解三种java实现多线程的方式
java中实现多线程的方法有两种:继承Thread类和实现runnable接口. 1.继承Thread类,重写父类run()方法 ? 1 2 3 4 5 6 7 8 9 10 11 12 13 14 ...
- Spring事务之详解--三种实现方式
实现购买股票案例: 一.引入JAR文件: 二.开始搭建分层架构---创建账户(Account)和股票(Stock)实体类 Account: /* * 账户 */ public class Accoun ...
- 缓存失效策略(FIFO,LRU,LFU)
当缓存需要被清理时(比如空间占用已经接近临界值了),需要使用某种淘汰算法来决定清理掉哪些数据.常用的淘汰算法有下面几种: 1. FIFO:First In First Out,先进先出.判断被存储的时 ...
- 详解GaussDB bufferpool缓存策略,这次彻底懂了!
摘要:华为云GaussDB(for mysql)是华为云自主研发的最新一代云原生数据库,采用计算存储分离.日志即数据的架构设计.具备极致可靠.极致性价比.多为扩展.完全可信等诸多特性. 一 .Gaus ...
- Python操作redis字符串(String)详解 (三)
# -*- coding: utf-8 -*- import redis #这个redis不能用,请根据自己的需要修改 r =redis.Redis(host=") 1.SET 命令用于设置 ...
- .NET4缓存过期策略摘录
以下是网上搜索的资料,仅供参考: 资料一:ASP.NET缓存中Cache过期的三种策略(转自51CTO) 我们在页面上添加三个按钮并双击按钮创建事件处理方法,三个按钮使用不同的过期策略添加ASP.NE ...
- asp.net的Context.Cache缓存过期策略
最近使用Context.Cache需要了解Cache的缓存过期策略. 文章:ASP.NET缓存中Cache过期的三种策略
- Redis详解(四)——删除策略
Redis详解(四)--删除策略 Redis中的数据特征 Redis是一种内存级数据库,所有数据均存放在内存中,内存中的数据可以通过TTL指令来获取其状态,当 key 不存在时,返回 -2 . 当 k ...
- 图文详解两种算法:深度优先遍历(DFS)和广度优先遍历(BFS)
参考网址:图文详解两种算法:深度优先遍历(DFS)和广度优先遍历(BFS) - 51CTO.COM 深度优先遍历(Depth First Search, 简称 DFS) 与广度优先遍历(Breath ...
随机推荐
- Google官方关于Android架构中MVP模式的示例续-DataBinding
基于前面的TODO示例,使用Data Binding库来显示数据并绑定UI元素的响应动作. 这个示例并未严格遵循 Model-View-ViewModel 或 Model-View-Presenter ...
- python之最强王者(8)——字典(dictionary)
1.Python 字典(Dictionary) 字典是另一种可变容器模型,且可存储任意类型对象. 字典的每个键值(key=>value)对用冒号(:)分割,每个对之间用逗号(,)分割,整个字典包 ...
- python入门-python解释器执行
最近由于公司需要,接触了python这门神奇的语言,给我的感觉就是开发快速和代码简洁. 开始还是先罗列一下解释性语言和编译性语言的差别吧0.0! 编译性语言:是在程序运行前,需要专门的一个编译过程 ...
- 高访问量WEB开发中的架构模式,学习从点滴开始
当一个Web系统从日访问量10万逐步增长到1000万,甚至超过1亿的过程中,Web系统承受的压力会越来越大,在这个过程中,我们会遇到很多的问题.为了解决这些性能压力带来问题,我们需要在Web系统架构 ...
- Struts2入门(四)——数据输入验证
一.前言 1.1.什么是输入验证?为什么需要输入验证? 在上一篇文章中,我们学习了数据类型转换,我们提到了表示层数据处理的两个方法,也提到了用户输入数据需要进行类型转换才能得到我们想要的数据,那么,我 ...
- 保持Qt GUI响应的几种方法
最开始使用Qt时就遇到过QT Gui失去响应的问题,我是用多线程的方式解决的,然而通常来说,多线程是会降低程序的运行速度. 之后,在使用QSqlQuery::execBatch()函数时,Qt Gui ...
- 转 threejs中3D视野的缩放实现
Threejs基础部分学习知道透视相机new THREE.PerspectiveCamera(fov, aspect , near,far)中. fov视野角(拍摄距离)越大,场景中的物体越小.fov ...
- wamp集成环境开启rewrite伪静态支持
wamp集成环境在安装完后,默认是没有开启伪静态的,所以有时把项目部署进去时如果源码里包含.htaccess文件的话,可能会出现500错误,这一般是因为不支持伪静态造成的,解决这个问题的办法就是开启伪 ...
- 让产品有效迭代,前端A/B Testing的简单实现
A/B Testing简介 互联网产品的迭代速度很快,往往一周一小发布,一月一大发布,产品提出的种种需求,哪些改动是提升产品体验的,哪些是阻碍产品进步的,如果没有数据可以参考,仅仅是靠拍脑袋的话,对产 ...
- DataView详解
dataview可以用于对你的datatable筛选,搜索,排序,编辑和导航.可以方便对databale的操作. 先来看一下它有哪些属性: 接下来是方法: 我们怎么使用它呢? public datat ...