
爬虫库之BeautifulSoup学习(二)
BeautifulSoup官方介绍文档:https://www.crummy.com/software/BeautifulSoup/bs4/doc/index.zh.html
四大对象种类:
BeautifulSoup 将复杂的html文件转换成一个复杂的树形结松,每个节点都是python对象。
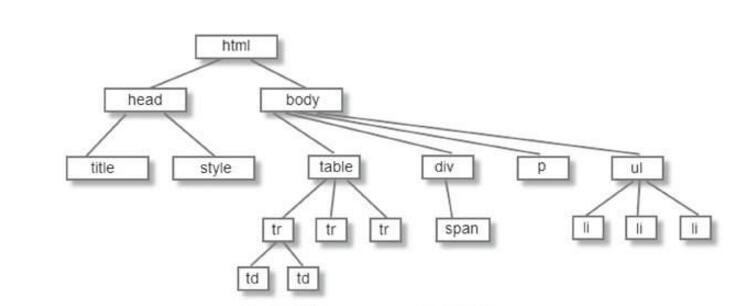
所有对象可以分下以下四类:
Tag
NavigableString
BeautifulSoup
Comment
下面进行一一介绍:
1、Tag
通俗点讲就是html中的一个个标签,例如:
<title>Hello world </title>
<a class ="test",href="http://www.baidu.com" id="link1"> Elsie </a>
上面的 title a 等等 HTML 标签加上里面包括的内容就是 Tag,下面我们来感受一下怎样用 Beautiful Soup 来方便地获取 Tags
下面每一段代码中注释部分为运行结果:
print soup.title
#<title>Hello world </title>
print soup.head
#<head><title>The Dormouse's story</title></head>
print soup.a
#<a class="sister" href="http://example.com/elsie" id="link1"><!-- Elsie --></a>
print soup.p
#<p class="title" name="dromouse"><b>The Dormouse's story</b></p>
我们可以利用 soup加标签名轻松地获取这些标签的内容,是不是感觉比正则表达式方便多了?
我们可以验证一下这些对象的类型:
print type(soup.a)
#<class 'bs4.element.Tag'>
对于tag,它有两个重要的属性,是name和attrs
name:
print soup.name
print soup.head.name
#[document]
2、NaviableString
既然我们已经得到了标签的内容,那么问题来了,我们要想获取标签内部的文字怎么办呢?很简单,用 .string 即可
print soup.p.string
#The Dormouse's story
检查一下它的类型
print type(soup.p.string)
#<class 'bs4.element.NavigableString'>
3、BeautifulSoup
对象表示的是一个文档的全部内容.大部分时候,可以把它当作 Tag 对象,是一个特殊的 Tag,我们可以分别获取它的类型,名称,以及属性来感受一下
print type(soup.name)
#<type 'unicode'>
print soup.name
#[document]
print soup.attrs
#{} 空字典
4、Comment
对象是一个特殊类型的 NavigableString 对象,其实输出的内容仍然不包括注释符号,但是如果不好好处理它,可能会对我们的文本处理造成意想不到的麻烦。
我们找一个带注释的标签
print soup.a
print soup.a.string
print type(soup.a.string)
结果如下:
<a class="sister" href="http://example.com/elsie" id="link1"><!-- Elsie --></a>
Elsie
<class 'bs4.element.Comment'>
a 标签里的内容实际上是注释,但是如果我们利用 .string 来输出它的内容,我们发现它已经把注释符号去掉了,所以这可能会给我们带来不必要的麻烦。
另外我们打印输出下它的类型,发现它是一个 Comment 类型,所以,我们在使用前最好做一下判断,判断代码如下:
if type(soup.a.string)=="bs4.element.Comment":
print soup.a.string
上面的代码中,我们首先判断了它的类型,是否为 Comment 类型,然后再进行其他操作,如打印输出。
实例应用:
import requests
from bs4 import BeautifulSoup
url = "http://www.baidu.com"
html_doc = requests.get(url).content
soup = BeautifulSoup(html_doc,'lxml')
for link in soup.find_all('a'):
print (link.get_text()) #获取tag中的文本内容
print (link.get('href')) #获取tag的属性,用get("attr")
爬虫库之BeautifulSoup学习(二)的更多相关文章
- 爬虫库之BeautifulSoup学习(一)
Beautiful Soup的简介 简单来说,Beautiful Soup是python的一个库,最主要的功能是从网页抓取数据. 官方解释如下: Beautiful Soup提供一些简单的.pytho ...
- 爬虫库之BeautifulSoup学习(五)
css选择器: 我们在写 CSS 时,标签名不加任何修饰,类名前加点,id名前加 #,在这里我们也可以利用类似的方法来筛选元素,用到的方法是 soup.select(),返回类型是 list 1)通过 ...
- 爬虫库之BeautifulSoup学习(四)
探索文档树: find_all(name,attrs,recursive,text,**kwargs) 方法搜索当前tag的所有tag子节点,并判断是否符合过滤器的条件 1.name参数,可以查找所有 ...
- 爬虫库之BeautifulSoup学习(三)
遍历文档树: 1.查找子节点 .contents tag的.content属性可以将tag的子节点以列表的方式输出. print soup.body.contents print type(soup. ...
- 【Python】在Pycharm中安装爬虫库requests , BeautifulSoup , lxml 的解决方法
BeautifulSoup在学习Python过程中可能需要用到一些爬虫库 例如:requests BeautifulSoup和lxml库 前面的两个库,用Pychram都可以通过 File--> ...
- 网页3D效果库Three.js学习[二]-了解照相机
camera 上篇大致了解了three.js ,并可以创建一个简单的可动的立方体.下来我们着重了解下camera (照相机),照相机其实就是视角,就像你的眼睛.Three.js有两种不同的相机模式:直 ...
- 使用Python爬虫库BeautifulSoup遍历文档树并对标签进行操作详解(新手必学)
为大家介绍下Python爬虫库BeautifulSoup遍历文档树并对标签进行操作的详细方法与函数下面就是使用Python爬虫库BeautifulSoup对文档树进行遍历并对标签进行操作的实例,都是最 ...
- 爬虫概念与编程学习之如何爬取视频网站页面(用HttpClient)(二)
先看,前一期博客,理清好思路. 爬虫概念与编程学习之如何爬取网页源代码(一) 不多说,直接上代码. 编写代码 运行 <!DOCTYPE html><html><head& ...
- python爬虫解析库之Beautifulsoup模块
一 介绍 Beautiful Soup 是一个可以从HTML或XML文件中提取数据的Python库.它能够通过你喜欢的转换器实现惯用的文档导航,查找,修改文档的方式.Beautiful Soup会 ...
随机推荐
- 使用excel进行数据挖掘(5)---- 应用场景分析
使用excel进行数据挖掘(5)---- 应用场景分析 在配置环境后,能够使用excel进行数据挖掘. 环境配置问题可參阅: http://blog.csdn.net/xinxing__8185/ar ...
- python(34)- 模块与包练习
创建如下目录结构 keystone/ ├── __init__.py └── auth ├── __init__.py └── plugins └── core.py ...
- 基于RFS(robot framework selenium)框架模拟POST/GET请求执行自动化接口测试
打开RIDE添加测试用例 如: Settings Library Collections Library RequestsLibrary Test Cases ...
- web前端面试系列 - js中的prototype
js中一切皆为对象,其中函数也是一种对象, 而每个函数都有一个prototype属性,其值也是一个对象. 一.prototype的作用 1. 在多个实例对象之间共享数据和方法. 2. 通过原型链实现继 ...
- Linux学习笔记——例说makefile 综合案例
0.前言 从学习C语言開始就慢慢開始接触makefile,查阅了非常多的makefile的资料但总感觉没有真正掌握makefile,假设自己动手写一个makefile总认为非常吃力.所以特意借 ...
- python中if __name__ == '__main__': 的解析(转载)
当你打开一个.py文件时,经常会在代码的最下面看到if __name__ == '__main__':,现在就来介 绍一下它的作用. 模块是对象,并且所有的模块都有一个内置属性 __name__.一个 ...
- MySQL 数据类型转换
版权个人所有,欢迎转载如转载请说明出处.(东北大亨) http://www.cnblogs.com/northeastTycoon/p/5505523.html 网络越来越达到所以带来的好处不容置疑. ...
- mysql的事务隔离级别及其使用场景
1 什么是事务隔离级别 事务隔离指的是事务之间同步关系. 2 食物隔离级别的分类 第一隔离级别,脏读级别 在脏读级别下,第一个事务修改了某个数据,但是还没有提交,第二个事务可以读取到这个未提及的数据. ...
- cocos2d-js实现 双击android后退按钮 即退出游戏
之前测了一下android自带的后退按钮,用在cocos2d-js中是没有获取到的 (可能是cocos2d-js已经把android的后退事件截取了,所以原生java代码没有用), 没办法就只能用co ...
- Machine Learning in Action(3) 朴素贝叶斯算法
贝叶斯决策一直很有争议,今年是贝叶斯250周年,历经沉浮,今天它的应用又开始逐渐活跃,有兴趣的可以看看斯坦福Brad Efron大师对其的反思,两篇文章:“Bayes'Theorem in the 2 ...