
MapReduce(二)
MapReduce(二)
mapreduce 将Text转化为对象进行处理数据。
根据一来说,将date,classname,name,subject,score变为对象属性
我的数据是:是有重复的。
package com.huhu.day02;

import java.io.DataInput;

import java.io.DataOutput;

import java.io.IOException;

import org.apache.hadoop.io.WritableComparable;

public class Score implements WritableComparable<Score> {

	private String date;

	private String classname;

	private String name;

	private String subject;

	private int score;

	public Score() {

		super();

		// TODO Auto-generated constructor stub

	}

	public Score(String date, String classname, String name, String subject, int score) {

		super();

		this.date = date;

		this.classname = classname;

		this.name = name;

		this.subject = subject;

		this.score = score;

	}

	public String getDate() {

		return date;

	}

	public void setDate(String date) {

		this.date = date;

	}

	public String getClassname() {

		return classname;

	}

	public void setClassname(String classname) {

		this.classname = classname;

	}

	public String getName() {

		return name;

	}

	public void setName(String name) {

		this.name = name;

	}

	public String getSubject() {

		return subject;

	}

	public void setSubject(String subject) {

		this.subject = subject;

	}

	public int getScore() {

		return score;

	}

	public void setScore(int score) {

		this.score = score;

	}

	@Override

	public String toString() {

		return "Score [date=" + date + ", classname=" + classname + ", name=" + name + ", subject=" + subject

				+ ", score=" + score + "]";

	}

	@Override

	public int hashCode() {

		final int prime = 31;

		int result = 1;

		result = prime * result + ((classname == null) ? 0 : classname.hashCode());

		result = prime * result + ((date == null) ? 0 : date.hashCode());

		result = prime * result + ((name == null) ? 0 : name.hashCode());

		result = prime * result + score;

		result = prime * result + ((subject == null) ? 0 : subject.hashCode());

		return result;

	}

	@Override

	public void readFields(DataInput in) throws IOException {

		this.date = in.readUTF();

		this.classname = in.readUTF();

		this.name = in.readUTF();

		this.subject = in.readUTF();

		this.score = in.readInt();

	}

	@Override

	public void write(DataOutput out) throws IOException {

		out.writeUTF(this.date);

		out.writeUTF(this.classname);

		out.writeUTF(this.name);

		out.writeUTF(this.subject);

		out.writeInt(this.score);

	}

	@Override

	public boolean equals(Object obj) {

		if (this == obj)

			return true;

		if (obj == null)

			return false;

		if (getClass() != obj.getClass())

			return false;

		Score other = (Score) obj;

		if (classname == null) {

			if (other.classname != null)

				return false;

		} else if (!classname.equals(other.classname))

			return false;

		if (date == null) {

			if (other.date != null)

				return false;

		} else if (!date.equals(other.date))

			return false;

		if (name == null) {

			if (other.name != null)

				return false;

		} else if (!name.equals(other.name))

			return false;

		if (score != other.score)

			return false;

		if (subject == null) {

			if (other.subject != null)

				return false;

		} else if (!subject.equals(other.subject))

			return false;

		return true;

	}

	@Override

	public int compareTo(Score o) {

		if (this.date.equals(o.date)) {

			if (this.classname.equals(o.classname)) {

				if (this.name.equals(o.name)) {

					if (this.subject.equals(o.subject)) {

						return this.score - o.score;

					} else {

						return this.subject.compareTo(o.subject);

					}

				} else {

					return this.name.compareTo(o.name);

				}

			} else {

				return this.classname.compareTo(o.classname);

			}

		} else {

			return this.date.compareTo(o.date);

		}

	}

}
该自定义类使用实现了WritableComparable<>类是为了序列化该类然后进入mapreduce方法中,实现compareTo是为了mapreduce根据key排序,当该int字段返回 0 证明key相同。如果返回大于1则是升序,返回小于1降序。
package com.huhu.day02;

import java.io.IOException;

import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.io.LongWritable;

import org.apache.hadoop.io.NullWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Job;

import org.apache.hadoop.mapreduce.Mapper;

import org.apache.hadoop.mapreduce.Reducer;

import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

import org.apache.hadoop.util.GenericOptionsParser;

import org.apache.hadoop.util.Tool;

import org.apache.hadoop.util.ToolRunner;

public class ScoreCount extends ToolRunner implements Tool {

	public static class MyMapper extends Mapper<LongWritable, Text, Score, NullWritable> {

		@Override

		protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException {

			String[] line = value.toString().split(" ");

			Score score = null;

			if (line.length == 5) {

				score = new Score(line[0], line[1], line[2], line[3], Integer.parseInt(line[4]));

			}

			context.write(score, NullWritable.get());

		}

	}

	public static class MyReduce extends Reducer<Score, NullWritable, Score, Text> {

		@Override

		protected void reduce(Score key, Iterable<NullWritable> values, Context context)

				throws IOException, InterruptedException {

			int count = 1;

			for (NullWritable v : values) {

				context.write(key, new Text(count + "-------" ));

				count++;

			}

		}

	}

	@Override

	public Configuration getConf() {

		return new Configuration();

	}

	@Override

	public void setConf(Configuration arg0) {

	}

	@Override

	public int run(String[] other) throws Exception {

		Job job = Job.getInstance(getConf(), "ScoreCount");

		job.setJarByClass(ScoreCount.class);

		job.setMapperClass(MyMapper.class);

		job.setMapOutputKeyClass(Score.class);

		job.setMapOutputValueClass(NullWritable.class);

		job.setReducerClass(MyReduce.class);

		job.setOutputKeyClass(Score.class);

		job.setOutputValueClass(Text.class);

		FileInputFormat.addInputPath(job, new Path(other[0]));

		FileOutputFormat.setOutputPath(job, new Path(other[1]));

		return job.waitForCompletion(true) ? 0 : 1;

	}

	public static void main(String[] args) throws Exception {

		Configuration conf = new Configuration();

		String[] other = new GenericOptionsParser(conf, args).getRemainingArgs();

		if (other.length != 2) {

			System.out.println("your input args number is fail,you need input <in> and <out>");

			System.exit(0);

		}

		ToolRunner.run(conf, new ScoreCount(), other);

	}

}
此时输出的结果是:此时equalse和compareTo方法都有

数据相同的可以认识,然后后面的计数器就赋予它原来的值,而不是累加。
让我们去掉equals方法再测试一遍。

发现并没有什么不同,好的,那我们去掉将compareto的方法的内容去掉,直接返回1;
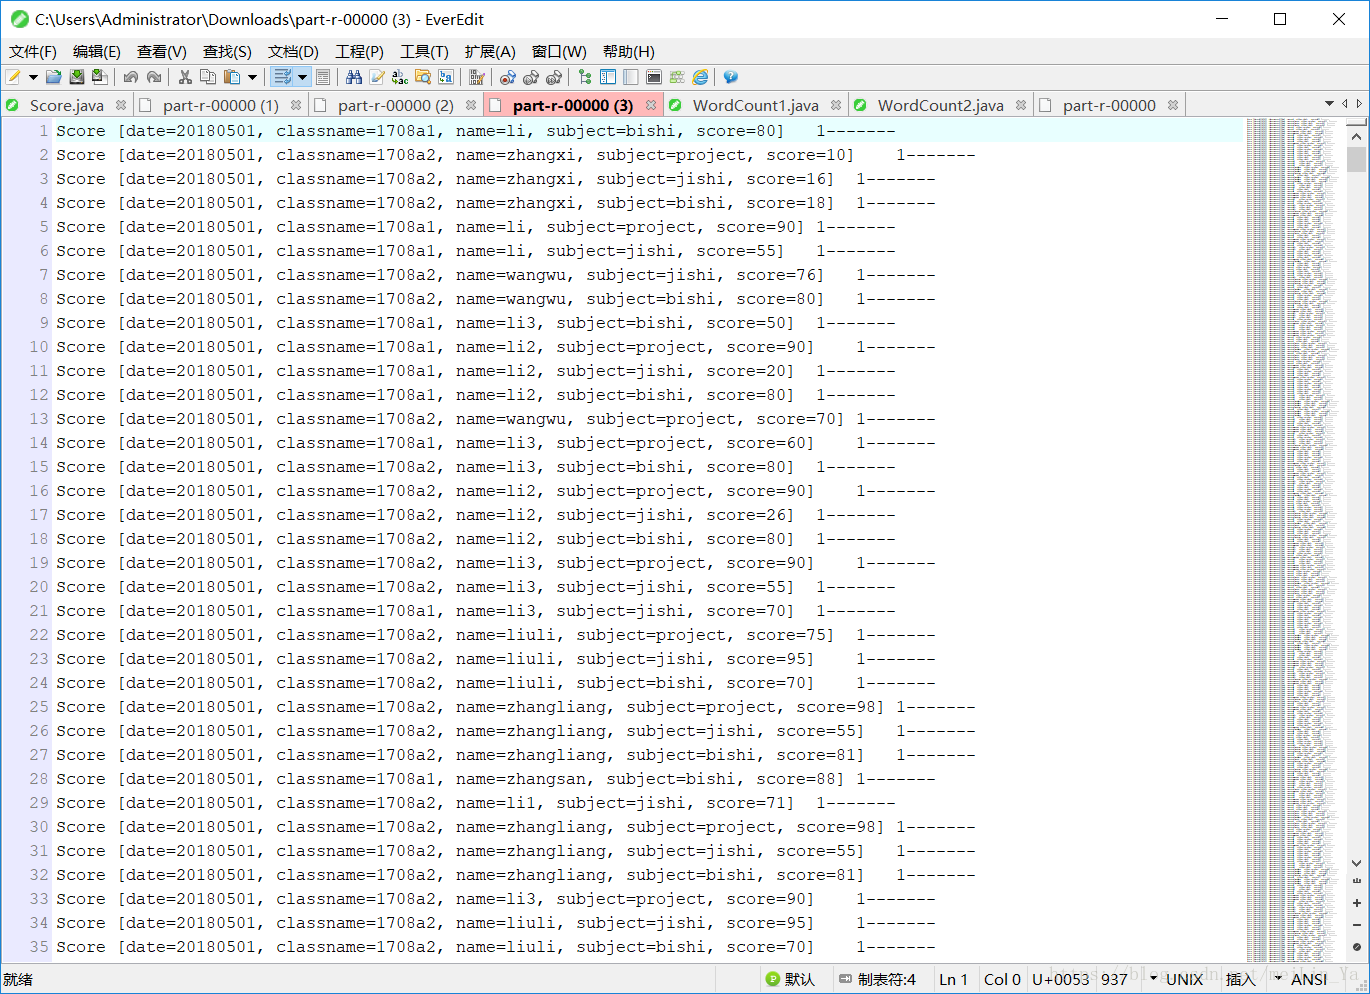
发现计数器都是1,也就是说没有一个数据是相同的,但是我的数据里面明明是相同的数据啊,是为什么,因为
此时数据按升序排列,然后我们将compareto返回值调为-1

此时数据是按降序排序。
在compareto中String字符串是将字符串转化为ascii码表的值(字符所对应的十进制值) 相加然后进行比较大小。
MapReduce
将Text文本对象化,传一个序列化对象后,利用对象属性字段取值并使用值,比切割字符串方式取值方便,并且在自定义类中使用添加方法如equalse方法和comparto方法是mapreduce中的key进行排序。从而简化yarn对的数据操作过程,利用了java的一切皆对象的思想。
MapReduce(二)的更多相关文章
- Hadoop学习笔记: MapReduce二次排序
本文给出一个实现MapReduce二次排序的例子 package SortTest; import java.io.DataInput; import java.io.DataOutput; impo ...
- (转)MapReduce二次排序
一.概述 MapReduce框架对处理结果的输出会根据key值进行默认的排序,这个默认排序可以满足一部分需求,但是也是十分有限的.在我们实际的需求当中,往往有要对reduce输出结果进行二次排序的需求 ...
- 详细讲解MapReduce二次排序过程
我在15年处理大数据的时候还都是使用MapReduce, 随着时间的推移, 计算工具的发展, 内存越来越便宜, 计算方式也有了极大的改变. 到现在再做大数据开发的好多同学都是直接使用spark, hi ...
- MapReduce二次排序
默认情况下,Map 输出的结果会对 Key 进行默认的排序,但是有时候需要对 Key 排序的同时再对 Value 进行排序,这时候就要用到二次排序了.下面让我们来介绍一下什么是二次排序. 二次排序原理 ...
- Hadoop MapReduce 二次排序原理及其应用
关于二次排序主要涉及到这么几个东西: 在0.20.0 以前使用的是 setPartitionerClass setOutputkeyComparatorClass setOutputValueGrou ...
- 关于MapReduce二次排序的一点解答
上一篇博客说明了怎么自定义Key,而且用了二次排序的例子来做测试,但没有详细的说明二次排序,这一篇说详细的说明二次排序,为了说明曾经一个思想的误区,特地做了一个3个字段的二次排序来说明.后面称其为“三 ...
- MapReduce(二) MR的高级特性-序列化、排序、分区、合并
一.序列化 (*) 核心接口:Writable接口.如果有一个类实现了Writable接口,就可以作为Map/Reduce的key和value. 举例: 读取员工数据,生成员工对象,直接存储 ...
- mapreduce二次排序详解
什么是二次排序 待排序的数据具有多个字段,首先对第一个字段排序,再对第一字段相同的行按照第二字段排序,第二次排序不破坏第一次排序的结果,这个过程就称为二次排序. 如何在mapreduce中实现二次排序 ...
- MapReduce(二)常用三大组件
mapreduce三大组件:Combiner\Sort\Partitioner 默认组件:排序,分区(不设置,系统有默认值) 一.mapreduce中的Combiner 1.什么是combiner C ...
- MapReduce 二次排序
默认情况下,Map 输出的结果会对 Key 进行默认的排序,但是有时候需要对 Key 排序的同时再对 Value 进行排序,这时候就要用到二次排序了.下面让我们来介绍一下什么是二次排序. 二次排序原理 ...
随机推荐
- 1、Python模块和包(0602)
模块.异常.运行环境.mysqldb 模块: 顶层文件:作为整个文件的程序入口,就是负责去调用其他文件中的代码来实现程序流程功能的,称为顶层程序文件, 模块文件1 模块文件2 python模块 1.可 ...
- jenkins+ant+jmeter自动化性能测试平台
jenkins+ant+jmeter自动化性能测试平台 Jmeter是性能测试的工具,java编写.开源,小巧方便,可以图形界面运行也可以在命令行下运行.网上已经有人使用ant来运行,http://w ...
- 批量Excel数据导入Oracle数据库
由于一直基于Oracle数据库上做开发,因此常常会需要把大量的Excel数据导入到Oracle数据库中,其实如果从事SqlServer数据库的开发,那么思路也是一样的,本文主要介绍如何导入Excel数 ...
- _itemmod_rate_stone
`entry`几率宝石物品ID `type` 1--合成对应_itemmod_exchange_item 2--强化对应_itemmod_exchange_item 3-附魔(除itemMask = ...
- _spellmod_aura_trigger
一.spell.dbc做一个空光环 二.配置_spellmod_aura_trigger表 comment 备注 aura 光环ID,有此光环时,才会触发下面技能 linkSpell1-3 链接的技能 ...
- hdu 3094 A tree game 树上sg
A tree game Time Limit: 2000/1000 MS (Java/Others) Memory Limit: 32768/32768 K (Java/Others) Prob ...
- leecode第八十九题(格雷编码)
class Solution { public: vector<int> grayCode(int n) { vector<int> res; res.push_back(); ...
- indexOf includes 区别
indexOf 返回数值类型 ( 索引.-1 ) includes 返回布尔类型 ( true .false ),且能区分出 NaN undefined ( 如新建空数组 ...
- JS中innerHTML、outerHTML、innerText 、outerText、value的区别与联系?jQuery中的text()、html()和val()
一.JS中innerHTML.outerHTML.innerText .outerText.value的区别与联系?jS中设置或者获取所选内容的值:①innerHTML :属性设置或返回该标签内的HT ...
- chkconfig命令参数
chkconfig命令主要用来更新(启动或停止)和查询系统服务的运行级信息.谨记chkconfig不是立即自动禁止或激活一个服务,它只是简单的改变了符号连接. 使用语法:chkconfig [--ad ...