
RNN-LSTM-GRU-BIRNN
https://blog.csdn.net/wangyangzhizhou/article/details/76651116 共三篇
RNN的模型展开后多个时刻隐层互相连接,而所有循环神经网络都有一个重复的网络模块,RNN的重复网络模块很简单,如下下图,比如只有一个tanh层。

而LSTM的重复网络模块的结构则复杂很多,它实现了三个门计算,即遗忘门、输入门和输出门。每个门负责是事情不一样,遗忘门负责决定保留多少上一时刻的单元状态到当前时刻的单元状态;输入门负责决定保留多少当前时刻的输入到当前时刻的单元状态;输出门负责决定当前时刻的单元状态有多少输出。
每个LSTM包含了三个输入,即上时刻的单元状态、上时刻LSTM的输出和当前时刻输入。

https://blog.csdn.net/thriving_fcl/article/details/73381217
主要参考的论文是Hierarchical Attention Networks for Document Classification。这里的层次Attention网络并不是只含有Attention机制的网络,而是在双向RNN的输出后加了Attention机制,层次表现在对于较长文本的分类,先将词向量通过RNN+Attention表示为句子向量,再将句子向量通过RNN+Attention表示为文档向量。两部分的Attention机制是一样的,这篇博客就不重复说明了。
BIRNN

attention
1. 原来的Encoder–Decoder
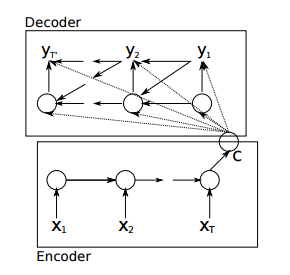
在这个模型中,encoder只将最后一个输出递给了decoder,这样一来,decoder就相当于对输入只知道梗概意思,而无法得到更多输入的细节,比如输入的位置信息。
2. 对齐问题
前面说了,只给我递来最后一个输出,不好;但如果把每个step的输出都传给我,又有一个问题了,怎么对齐?
什么是对齐?比如说英文翻译成中文,假设英文有10个词,对应的中文翻译只有6个词,那么就有了哪些英文词对哪些中文词的问题了嘛。
3. attention机制
https://www.cnblogs.com/shixiangwan/p/7573589.html
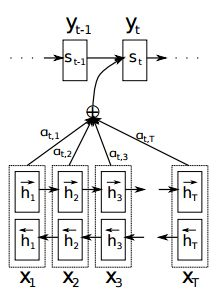
这个g可以用一个小型的神经网络来逼近,它用来计算St−1 、hj这两者的关系分数,如果分数大则说明关注度较高,注意力分布就会更加集中在这个输入单词上,这个函数在文章Neural Machine Translation by Jointly Learning to Align and Translate(2014)中称之为校准模型(alignment model),文中提到这个函数是RNN前馈网络中的一系列参数,在训练过程会训练这些参数。
把四个公式串起来看,这个attention机制可以总结为一句话:当前一步输出St应该对齐哪一步输入,主要取决于前一步输出St−1和这一步输入的encoder结果hj。
(该结论有时表述为只与encoder结果有关)
RNN-LSTM-GRU-BIRNN的更多相关文章
- RNN,LSTM,GRU基本原理的个人理解
记录一下对RNN,LSTM,GRU基本原理(正向过程以及简单的反向过程)的个人理解 RNN Recurrent Neural Networks,循环神经网络 (注意区别于recursive neura ...
- 深度学习中的序列模型演变及学习笔记(含RNN/LSTM/GRU/Seq2Seq/Attention机制)
[说在前面]本人博客新手一枚,象牙塔的老白,职业场的小白.以下内容仅为个人见解,欢迎批评指正,不喜勿喷![认真看图][认真看图] [补充说明]深度学习中的序列模型已经广泛应用于自然语言处理(例如机器翻 ...
- RNN/LSTM/GRU/seq2seq公式推导
概括:RNN 适用于处理序列数据用于预测,但却受到短时记忆的制约.LSTM 和 GRU 采用门结构来克服短时记忆的影响.门结构可以调节流经序列链的信息流.LSTM 和 GRU 被广泛地应用到语音识别. ...
- RNN - LSTM - GRU
循环神经网络 (Recurrent Neural Network,RNN) 是一类具有短期记忆能力的神经网络,因而常用于序列建模.本篇先总结 RNN 的基本概念,以及其训练中时常遇到梯度爆炸和梯度消失 ...
- RNN & LSTM & GRU 的原理与区别
RNN 循环神经网络,是非线性动态系统,将序列映射到序列,主要参数有五个:[Whv,Whh,Woh,bh,bo,h0][Whv,Whh,Woh,bh,bo,h0],典型的结构图如下: 和普通神经网 ...
- [PyTorch] rnn,lstm,gru中输入输出维度
本文中的RNN泛指LSTM,GRU等等 CNN中和RNN中batchSize的默认位置是不同的. CNN中:batchsize的位置是position 0. RNN中:batchsize的位置是pos ...
- RNN, LSTM, GRU cells
项目需要,先简记cell,有时间再写具体改进原因 RNN cell LSTM cell: GRU cell: reference: 1.https://towardsdatascience.com/a ...
- RNN,GRU,LSTM
2019-08-29 17:17:15 问题描述:比较RNN,GRU,LSTM. 问题求解: 循环神经网络 RNN 传统的RNN是维护了一个隐变量 ht 用来保存序列信息,ht 基于 xt 和 ht- ...
- 自己动手实现深度学习框架-7 RNN层--GRU, LSTM
目标 这个阶段会给cute-dl添加循环层,使之能够支持RNN--循环神经网络. 具体目标包括: 添加激活函数sigmoid, tanh. 添加GRU(Gate Recurrent U ...
- NLP教程(5) - 语言模型、RNN、GRU与LSTM
作者:韩信子@ShowMeAI 教程地址:http://www.showmeai.tech/tutorials/36 本文地址:http://www.showmeai.tech/article-det ...
随机推荐
- static与全局变量区别
作用域不同: 全局变量是不显式用static修饰的全局变量,但全局变量默认是动态的,作用域是整个工程,在一个文件内定义的全局变量,在另一个文件中,通过extern 全局变量名的声明,就可以使用全局变量 ...
- python文件管理
文件没有修改操作,修改的方式为打开文件--读取文件--内存中编辑文件--将内容写入文件 打开文件方式 with open('a.txt','w') as f: #操作系统自动关闭文件 f.write( ...
- Win10系列:VC++ Direct3D图形绘制1
通过前面的介绍,相信读者已经了解了如何新建一个用于开发Direct3D应用程序的项目模版,以及这个项目模版中用于绘制立体图形的主要函数.在本小节中,将通过一个具体的示例来介绍如何使用Visual St ...
- OO作业总结(三)
类规格设计 由于没能找到关于类规格设计的发展历史,所以结合程序设计思想的发展来谈谈规格化设计. 最早的程序设计都是采用机器语言来编写的,直接使用二进制码来表示机器能够识别和执行的指令和数 据.简单来说 ...
- vue-9-动画
transition: <div id="demo"> <button v-on:click="show = !show"> Toggl ...
- Java面向对象习题
1: 抛出异常:throw声明异常:throwsthrow用于在程序中抛出异常,throws用于在方法内抛出异常.throw抛出的异常没有被处理的话必须有throws有throws ,但是不一定必须有 ...
- tfs 2017 使用
安装完成之后,创建一个项目管理. 初始化代码库 然后下载代理 (服务器)并设置.下载代理需要FQ才可以下载成功. 想要支持 netcore2.0 必须在代理服务器上安装 vs2017 跟netcor ...
- Centos7下cratedb数据导入导出copy to copy from
crate 创建表结构: 查看表: show tables; 创建表结构: create table tablename (k1 type,k2 type,k3 type); (type = int ...
- SpringMVC学习一
先看SpringMVC的视图解析 以及 摘录自http://www.cnblogs.com/HigginCui/p/5856780.html的架构解析 1.DisPatcherServlet:前 ...
- 关于React setState的实现原理(二)
React中的Transaction 大家学过sql server的都知道我们可以批量处理sql语句,原理其实都是基于上一篇我们说的Datch Update机制.当所有的操作均执行成功,才会执行修改操 ...