
失配树学习笔记 | P5829 【模板】失配树
简介
失配树(简称 Fail 树),是基于 KMP 的算法,可以高效的解决复杂的字符串前缀后缀关系问题。
前置知识:
- KMP 算法(求失配数组)
- 最近公共祖先(LCA)
希望大家看完这篇文章后可以理解失配树。
引入
先来看一道题(校内模拟题·改)
给你一个字符串 \(S\),你需要从它的非空前缀集合 \(\operatorname{Pre}\) 中选择一些字符串组成一个集合 \(Q\),使得集合 \(Q\) 中任意两个字符串 \(A,B\),\(A\) 不是 \(B\) 的后缀。求极大的集合 \(Q\),输出 \(Q\) 中的所有字符串(可能有多组合法答案,输出其中任意一组)。
\(2 \leq |S| \leq 10^{6}\)
一个朴素的思路是,对于 \(\operatorname{Pre}\) 中的字符串,翻转后插入一个字典树中。最后找字典树的所有叶子节点即可。不难证明,这个算法是正确的。
可是这个算法是 \(O(n^2)\)的。无法通过本题。究其原因,是因为字典树中存在许多多余元素。比如字符串 abcdabghiab,建出来的字典树……
如何解决呢?我们可以考虑,跳过中间的多余元素。如何跳过?也就是说如何从 \(\operatorname{border}\) 指向包含它的字符串?当然是 \(\operatorname{KMP}\) 中的失配数组!于是我们自然的想到连边 \((\operatorname{nxt}_i,i)\)。然后找叶子。复杂度降到了 \(O(n)\)。
P5829 【模板】失配树
给定一个字符串 \(s\),
有 \(m\) 组询问,每组询问给定 \(p,q\),求 \(s\) 的 \(\boldsymbol{p}\) 前缀 和 \(\boldsymbol{q}\) 前缀 的 最长公共 \(\operatorname{border}\) 的长度。\(1\leq p,q \le |s|\leq 10^6\),\(1 \leq m \leq 10^5\),\(s_i \in [\texttt{a}, \texttt{z}]\)
先建出失配树,对于第一个样例,失配树如下:
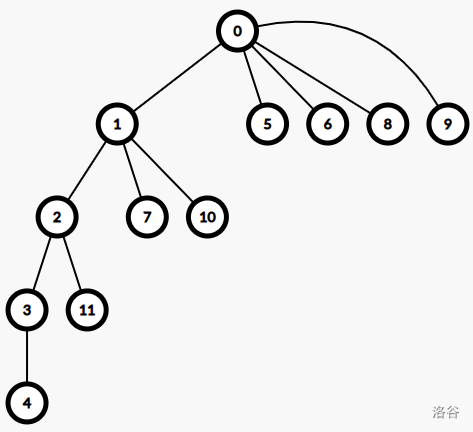
然后发现,最长公共前缀不就是在失配树上的最近公共祖先吗?
注意:
- 如果 \(\operatorname{LCA}(p,q) \in \{p,q\}\),那么答案其实是 \(\operatorname{father}(\operatorname{LCA}(p,q))\)。
- 如果你使用的是树剖求 LCA,那么记住不能以 \(0\) 为根。
参考代码
#include <bits/stdc++.h>

#define int long long

using namespace std;

const int N = 1000005;

struct edge {

	int nxt, to;

} g[N << 1];

int head[N << 1], ec;

void add(int u, int v) {

	g[++ec].nxt = head[u];

	g[ec].to = v;

	head[u] = ec;

}

int root;

int siz[N], son[N], fa[N], top[N], dep[N];

void dfs1(int u, int father, int deep) {

	dep[u] = deep;

	siz[u] = 1;

	fa[u] = father;

	for (int i = head[u]; i >= 0; i = g[i].nxt) {

		int v = g[i].to;

		dfs1(v, u, deep + 1);

		siz[u] += siz[u];

		if (siz[v] >= siz[son[u]]) {

			son[u] = v;

		}

	}

}

void dfs2(int u, int father, int t) {

	top[u] = t;

	if (son[u])dfs2(son[u], u, t);

	for (int i = head[u]; i >= 0; i = g[i].nxt) {

		int v = g[i].to;

		if (v == son[u]) {

			continue;

		}

		dfs2(v, u, v);

	}

}

int lca(int x, int y) {

	int fx = top[x], fy = top[y];

	while (fx != fy) {

		if (dep[fx] < dep[fy]){

			swap(fx, fy);

			swap(x, y);

		}

		x = fa[fx], fx = top[x];

	}

	if (dep[x] > dep[y]) {

		return y;

	}

	else return x;

}

namespace KMP{

    int nxt[1000005];

    char s[1000005];

    int n;

    void kmp(){

        n = strlen(s+1);

        add(n+1,1);

        for(int i=2,j=0;i<=n;i++){

            while(j&&s[i]!=s[j+1]){

                j=nxt[j];

            }

            if(s[i]==s[j+1]){

                j++;

            }

            nxt[i]=j;

            if(j!=0){

                add(j,i);

            }

            else{

                add(n+1,i);

            }

        }

    }

}

int m;

signed main(){

    memset(head,-1,sizeof(head));

    ec=-1;

    cin>>(KMP::s+1)>>m;

    KMP::kmp();

    dfs1(KMP::n+1,0,1);

    dfs2(KMP::n+1,0,KMP::n+1);

    while(m--){

        int p,q;

        cin>>p>>q;

        int LCA = lca(p,q);

        if(LCA == p || LCA == q){

            LCA = fa[LCA];

        }

        if(LCA==(KMP::n+1))LCA=0;

        cout<<LCA<<'\n';

    }

    return 0;

}
失配树学习笔记 | P5829 【模板】失配树的更多相关文章
- CF487E Tourists + 圆方树学习笔记(圆方树+树剖+线段树+multiset)
QWQ果然我已经什么都学不会的人了. 这个题目要求的是图上所有路径的点权和!QWQ(我只会树上啊!) 这个如果是好啊 这时候就需要 圆方树! 首先在介绍圆方树之前,我们先来一点简单的前置知识 首先,我 ...
- 线段树学习笔记(基础&进阶)(一) | P3372 【模板】线段树 1 题解
什么是线段树 线段树是一棵二叉树,每个结点存储需维护的信息,一般用于处理区间最值.区间和等问题. 线段树的用处 对编号连续的一些点进行修改或者统计操作,修改和统计的复杂度都是 O(log n). 基础 ...
- zkw线段树学习笔记
zkw线段树学习笔记 今天模拟赛线段树被卡常了,由于我自带常数 \(buff\),所以学了下zkw线段树. 平常的线段树无论是修改还是查询,都是从根开始递归找到区间的,而zkw线段树直接从叶子结点开始 ...
- SQL反模式学习笔记3 单纯的树
2014-10-11 在树形结构中,实例被称为节点.每个节点都有多个子节点与一个父节点. 最上层的节点叫做根(root)节点,它没有父节点. 最底层的没有子节点的节点叫做叶(leaf). 中间的节点简 ...
- 仙人掌&圆方树学习笔记
仙人掌&圆方树学习笔记 1.仙人掌 圆方树用来干啥? --处理仙人掌的问题. 仙人掌是啥? (图片来自于\(BZOJ1023\)) --也就是任意一条边只会出现在一个环里面. 当然,如果你的图 ...
- OpenCV 学习笔记(模板匹配)
OpenCV 学习笔记(模板匹配) 模板匹配是在一幅图像中寻找一个特定目标的方法之一.这种方法的原理非常简单,遍历图像中的每一个可能的位置,比较各处与模板是否"相似",当相似度足够 ...
- Python Flask学习笔记之模板
Python Flask学习笔记之模板 Jinja2模板引擎 默认情况下,Flask在程序文件夹中的templates子文件夹中寻找模板.Flask提供的render_template函数把Jinja ...
- JSOI2008 Blue Mary开公司 | 李超线段树学习笔记
题目链接:戳我 这相当于是一个李超线段树的模板qwqwq,题解就不多说了. 代码如下: #include<iostream> #include<cstdio> #include ...
- Treap-平衡树学习笔记
平衡树-Treap学习笔记 最近刚学了Treap 发现这种数据结构真的是--妙啊妙啊~~ 咳咳.... 所以发一发博客,也是为了加深蒟蒻自己的理解 顺便帮助一下各位小伙伴们 切入正题 Treap的结构 ...
- Splay伸展树学习笔记
Splay伸展树 有篇Splay入门必看文章 —— CSDN链接 经典引文 空间效率:O(n) 时间效率:O(log n)插入.查找.删除 创造者:Daniel Sleator 和 Robert Ta ...
随机推荐
- 深入浅出TCP与IP协议笔记
TCP/IP 4层结构:应用层 传输层 网络层 链路层 探索过程问题:一个主机的数据要经过哪些过程才到达对方的主机上 一组电信号就是一个数据包,一个数据包称为一帧,制定这个规则的就是以太网协议 ...
- 解决springboot+vue+mybatis中,将后台数据分页显示在前台,并且根据页码自动跳转对应页码信息
文章目录 先看效果 1.要考虑的问题,对数据进行分页查询 2.前端和后台的交互 先看效果 1.要考虑的问题,对数据进行分页查询 mapper文件这样写 从每次开始查询的位置,到每页展示的条数, < ...
- 创建Vue工程常用的命令
创建一个vue项目的步骤 1.创建一个名称为myapp的工程 vue init webpack myapp 2.进入工程目录 cd myapp 3.安装 vue-router npm install ...
- 再有人说synchronized是重量级锁,就把这篇文章扔给他看
synchronized作为Java程序员最常用同步工具,很多人却对它的用法和实现原理一知半解,以至于还有不少人认为synchronized是重量级锁,性能较差,尽量少用. 但不可否认的是synchr ...
- 即兴小探华为开源行业领先大数据虚拟化引擎openLooKeng
@ 目录 概述 定义 背景 特点 架构 关键技术 应用场景 安装 单台部署 集群部署 命令行接口 连接器 MySQL连接器 ClickHouse连接器 概述 定义 openLooKeng 官网地址 h ...
- ES6 学习笔记(一)let、const与作用域
一.let命令 1.1用法 1.1.1 let类似于var,但所声明的变量只在let命令所在的代码块有效. 如: { let a = 10 var b = 20 } console.log(b) co ...
- VUE学习2
目录分析 public目录 index.html是起始的html文件 # 这是关键 <div id="app"></div> src目录 main.js是V ...
- 从 QFramework 重新开始
自从上一篇博文写完后,就进入了繁忙工作状态,直到最近才开始有一点空闲时间. 这次繁忙的状态从 2022 年 10 月 11 日 持续到 2022 年 11 月 5 日. 主要的工作就是 QFramew ...
- Jmeter——请求响应内容乱码解决办法
前段时间,换过一次设备,重新下载了Jmeter.有一次在编写脚本时,响应内容中的中文一直显示乱码. 遇到乱码不要慌,肯定是有办法来解决的.具体解决办法,可以参考之前的博文,Jmeter--BeanSh ...
- webpack中 hash chunkhash
hash一般是结合CDN缓存来使用,通过webpack构建之后,生成对应文件名自动带上对应的MD5值.如果文件内容发生改变的话,那么对应文件hash值也会改变,对应的HTML引用的URL地址也会改变, ...