
PyTorch 自定义数据集
准备数据
准备 COCO128 数据集,其是 COCO train2017 前 128 个数据。按 YOLOv5 组织的目录:
$ tree ~/datasets/coco128 -L 2

/home/john/datasets/coco128

├── images

│   └── train2017

│       ├── ...

│       └── 000000000650.jpg

├── labels

│   └── train2017

│       ├── ...

│       └── 000000000650.txt

├── LICENSE

└── README.txt
定义 Dataset
torch.utils.data.Dataset 是一个数据集的抽象类。自定义数据集时,需继承 Dataset 并覆盖如下方法:
__len__:len(dataset)获取数据集大小。__getitem__:dataset[i]访问第i个数据。
详见:
自定义实现 YOLOv5 数据集的例子:
import os

from pathlib import Path

from typing import Any, Callable, Optional, Tuple

import numpy as np

import torch

import torchvision

from PIL import Image

class YOLOv5(torchvision.datasets.vision.VisionDataset):

  def __init__(

    self,

    root: str,

    name: str,

    transform: Optional[Callable] = None,

    target_transform: Optional[Callable] = None,

    transforms: Optional[Callable] = None,

  ) -> None:

    super(YOLOv5, self).__init__(root, transforms, transform, target_transform)

    images_dir = Path(root) / 'images' / name

    labels_dir = Path(root) / 'labels' / name

    self.images = [n for n in images_dir.iterdir()]

    self.labels = []

    for image in self.images:

      base, _ = os.path.splitext(os.path.basename(image))

      label = labels_dir / f'{base}.txt'

      self.labels.append(label if label.exists() else None)

  def __getitem__(self, idx: int) -> Tuple[Any, Any]:

    img = Image.open(self.images[idx]).convert('RGB')

    label_file = self.labels[idx]

    if label_file is not None:  # found

      with open(label_file, 'r') as f:

        labels = [x.split() for x in f.read().strip().splitlines()]

        labels = np.array(labels, dtype=np.float32)

    else:  # missing

      labels = np.zeros((0, 5), dtype=np.float32)

    boxes = []

    classes = []

    for label in labels:

      x, y, w, h = label[1:]

      boxes.append([

        (x - w/2) * img.width,

        (y - h/2) * img.height,

        (x + w/2) * img.width,

        (y + h/2) * img.height])

      classes.append(label[0])

    target = {}

    target["boxes"] = torch.as_tensor(boxes, dtype=torch.float32)

    target["labels"] = torch.as_tensor(classes, dtype=torch.int64)

    if self.transforms is not None:

      img, target = self.transforms(img, target)

    return img, target

  def __len__(self) -> int:

    return len(self.images)
以上实现,继承了 VisionDataset 子类。其 __getitem__ 返回了:
- image: PIL Image, 大小为
(H, W) - target:
dict, 含以下字段:boxes(FloatTensor[N, 4]): 真实标注框[x1, y1, x2, y2],x范围[0,W],y范围[0,H]labels(Int64Tensor[N]): 上述标注框的类别标识
读取 Dataset
dataset = YOLOv5(Path.home() / 'datasets/coco128', 'train2017')

print(f'dataset: {len(dataset)}')

print(f'dataset[0]: {dataset[0]}')
输出:
dataset: 128

dataset[0]: (<PIL.Image.Image image mode=RGB size=640x480 at 0x7F6F9464ADF0>, {'boxes': tensor([[249.7296, 200.5402, 460.5399, 249.1901],

        [448.1702, 363.7198, 471.1501, 406.2300],

        ...

        [  0.0000, 188.8901, 172.6400, 280.9003]]), 'labels': tensor([44, 51, 51, 51, 51, 44, 44, 44, 44, 44, 45, 45, 45, 45, 45, 45, 45, 45,

        45, 50, 50, 50, 51, 51, 60, 42, 44, 45, 45, 45, 50, 51, 51, 51, 51, 51,

        51, 44, 50, 50, 50, 45])})
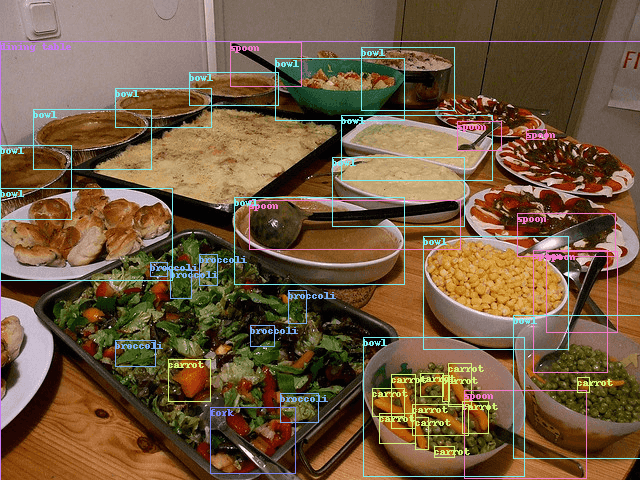
预览:
使用 DataLoader
训练需要批量提取数据,可以使用 DataLoader :
dataset = YOLOv5(Path.home() / 'datasets/coco128', 'train2017',

  transform=torchvision.transforms.Compose([

    torchvision.transforms.ToTensor()

  ]))

dataloader = DataLoader(dataset, batch_size=64, shuffle=True,

                        collate_fn=lambda batch: tuple(zip(*batch)))

for batch_i, (images, targets) in enumerate(dataloader):

  print(f'batch {batch_i}, images {len(images)}, targets {len(targets)}')

  print(f'  images[0]: shape={images[0].shape}')

  print(f'  targets[0]: {targets[0]}')
输出:
batch 0, images 64, targets 64

  images[0]: shape=torch.Size([3, 480, 640])

  targets[0]: {'boxes': tensor([[249.7296, 200.5402, 460.5399, 249.1901],

        [448.1702, 363.7198, 471.1501, 406.2300],

        ...

        [  0.0000, 188.8901, 172.6400, 280.9003]]), 'labels': tensor([44, 51, 51, 51, 51, 44, 44, 44, 44, 44, 45, 45, 45, 45, 45, 45, 45, 45,

        45, 50, 50, 50, 51, 51, 60, 42, 44, 45, 45, 45, 50, 51, 51, 51, 51, 51,

        51, 44, 50, 50, 50, 45])}

batch 1, images 64, targets 64

  images[0]: shape=torch.Size([3, 248, 640])

  targets[0]: {'boxes': tensor([[337.9299, 167.8500, 378.6999, 191.3100],

        [383.5398, 148.4501, 452.6598, 191.4701],

        [467.9299, 149.9001, 540.8099, 193.2401],

        [196.3898, 142.7200, 271.6896, 190.0999],

        [134.3901, 154.5799, 193.9299, 189.1699],

        [ 89.5299, 162.1901, 124.3798, 188.3301],

        [  1.6701, 154.9299,  56.8400, 188.3700]]), 'labels': tensor([20, 20, 20, 20, 20, 20, 20])}
源码
参考
APIs:
GoCoding 个人实践的经验分享,可关注公众号!
PyTorch 自定义数据集的更多相关文章
- [转载]pytorch自定义数据集
为什么要定义Datasets: PyTorch提供了一个工具函数torch.utils.data.DataLoader.通过这个类,我们在准备mini-batch的时候可以多线程并行处理,这样可以加快 ...
- Pytorch划分数据集的方法
之前用过sklearn提供的划分数据集的函数,觉得超级方便.但是在使用TensorFlow和Pytorch的时候一直找不到类似的功能,之前搜索的关键字都是"pytorch split dat ...
- pytorch加载语音类自定义数据集
pytorch对一下常用的公开数据集有很方便的API接口,但是当我们需要使用自己的数据集训练神经网络时,就需要自定义数据集,在pytorch中,提供了一些类,方便我们定义自己的数据集合 torch.u ...
- MMDetection 快速开始,训练自定义数据集
本文将快速引导使用 MMDetection ,记录了实践中需注意的一些问题. 环境准备 基础环境 Nvidia 显卡的主机 Ubuntu 18.04 系统安装,可见 制作 USB 启动盘,及系统安装 ...
- Scaled-YOLOv4 快速开始,训练自定义数据集
代码: https://github.com/ikuokuo/start-scaled-yolov4 Scaled-YOLOv4 代码: https://github.com/WongKinYiu/S ...
- torch_13_自定义数据集实战
1.将图片的路径和标签写入csv文件并实现读取 # 创建一个文件,包含image,存放方式:label pokemeon\\mew\\0001.jpg,0 def load_csv(self,file ...
- Tensorflow2 自定义数据集图片完成图片分类任务
对于自定义数据集的图片任务,通用流程一般分为以下几个步骤: Load data Train-Val-Test Build model Transfer Learning 其中大部分精力会花在数据的准备 ...
- Pytorch自定义数据库
1)前言 虽然torchvision.datasets中已经封装了好多通用的数据集,但是我们在使用Pytorch做深度学习任务的时候,会面临着自定义数据库来满足自己的任务需要.如我们要训练一个人脸关键 ...
- [炼丹术]YOLOv5训练自定义数据集
YOLOv5训练自定义数据 一.开始之前的准备工作 克隆 repo 并在Python>=3.6.0环境中安装requirements.txt,包括PyTorch>=1.7.模型和数据集会从 ...
随机推荐
- 菜鸟初学Linux——Ubuntu系统中,用root权限进行复制粘贴操作
long long ago,积累了一些Linux的小知识,拿出来分享一下,希望以后能够在工作上带来一些帮助. 方法一 第一步:打开终端,在命令行里输入sudo nautilus 第二步:输入你的用 ...
- centos 7.6安装WeADMIN ITOSS步骤
0.升级系统并安装必要的软件 yum -y update yum -y install wget unzip nmap 1.下载JDK jdk下载地址:http://www.oracle.com/te ...
- 织梦(DedeCms)的安全问题解决办法
网上大家也看到DEDECMS这套程序,虽然便捷草根站长的快速建站,但安全问题也是非常多的.DEDE官方也在很久之前就已经不再对这套系统进行什么版本升级了,最多就是一些补丁修复: 好,废话不多说,下面整 ...
- C++多元组tuple使用方法?你熟悉吗?快来看看吧
- 《C++ Primer》Chapter 7 [类]
前言 在C++中,我们使用类定义自己得数据类型/通过定义新的类型来反应待解决的题的各种概念,是我们更容易编写.调试和修改程序. 我们需要主要关注数据抽象的重要性.数据抽象能帮助我们将对象的具体实现与对 ...
- UVA 796 - Critical Links 无向图字典序输出桥
题目:传送门 题意:给你一个无向图,你需要找出里面的桥,并把所有桥按字典序输出 这一道题就是用无向图求桥的模板就可以了. 我一直错就是因为我在输入路径的时候少考虑一点 错误代码+原因: 1 #incl ...
- C#之抛异常
using System; namespace Demo { class Program { static void Main(string[] args) { try { BLLLayer(); } ...
- ES中文分词器安装以及自定义配置
之前我们创建索引,查询数据,都是使用的默认的分词器,分词效果不太理想,会把text的字段分成一个一个汉字,然后搜索的时候也会把搜索的句子进行分词,所以这里就需要更加智能的分词器IK分词器了. ik分词 ...
- keras BatchNormalization 之坑
任务简述:最近做一个图像分类的任务, 一开始拿vgg跑一个baseline,输出看起来很正常: 随后,我尝试其他的一些经典的模型架构,比如resnet50, xception,但训练输出显示明显异常: ...
- codeforces 7B
B. Memory Manager time limit per test 1 second memory limit per test 64 megabytes input standard inp ...