
docker 部署 zookeeper+kafka 集群
主机三台
172.16.100.61
172.16.100.62
172.16.100.63
Docker 版本 当前最新版
# 部署zk有2种方法
## 注意 \后不要跟空格
一 . 端口映射
172.16.100.61 执行
docker run -tid --name=zk- \

--restart=always \

--privileged=true \

-p : \

-p : \

-p : \

-e ZOO_MY_ID= \

-e ZOO_SERVERS=server.="0.0.0.0:2888:3888 server.2=172.16.100.62:2888:3888 server.3=172.16.100.63:2888:3888" \

-v /data/kafka_cluster/zookeeper/data:/data \

zookeeper:latest
172.16.100.62 执行
docker run -tid --name=zk- \

--restart=always \

--privileged=true \

-p : \

-p : \

-p : \

-e ZOO_MY_ID= \

-e ZOO_SERVERS=server.="172.16.100.61:2888:3888 server.2=0.0.0.0:2888:3888 server.3=172.16.100.63:2888:3888" \

-v /data/kafka_cluster/zookeeper/data:/data \

zookeeper:latest
172.16.100.63 执行
docker run -tid --name=zk- \

--restart=always \

--privileged=true \

-p : \

-p : \

-p : \

-e ZOO_MY_ID= \

-e ZOO_SERVERS=server.="172.16.100.61:2888:3888 server.2=172.16.100.62:2888:3888 server.3=0.0.0.0:2888:3888" \

-v /data/kafka_cluster/zookeeper/data:/data \
zookeeper:latest
#查看集群状态
docker exec -it zk- bash ./bin/zkServer.sh status
二.直接走宿主机IP
每台机器都执行一次,只需要修改 ZOO_MY_ID 即可 只要ZOO_SERVERS 和你的ID一致即可
docker run -tid --name=zk- \

--restart=always \

--privileged=true \

--net=host \

-e ZOO_MY_ID= \

-e ZOO_SERVERS=server.="172.16.100.61:2888:3888 server.2=172.16.100.62:2888:3888 server.3=172.16.100.63:2888:3888" \

-v /data/kafka_cluster/zookeeper/data:/data \

zookeeper:latest
### 上述zk检查过后没有问题就可以进行下一步了 ###
解析主机名
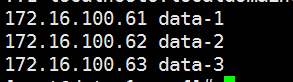
注意: kafka-logs-data-1 是主机的名字 如果你的主机是xxx 那这里应该改为kafka-logs-xxx
同时我映射了本地的hosts到容器里,所有容器获取到的主机名就是宿主机的名字
在61执行
docker run -itd --name=kafka \

--restart=always \

--net=host \

--privileged=true \

-v /etc/hosts:/etc/hosts \

-v /data/kafka_cluster/kafka/data:/kafka/kafka-logs-data- \

-v /data/kafka_cluster/kafka/logs:/opt/kafka/logs \

-e KAFKA_ADVERTISED_HOST_NAME=172.16.100.61 \

-e HOST_IP=172.16.100.61 \

-e KAFKA_ADVERTISED_PORT= \

-e KAFKA_ZOOKEEPER_CONNECT=172.16.100.61:,172.16.100.62:,172.16.100.63: \

-e KAFKA_BROKER_ID= \

-e KAFKA_HEAP_OPTS="-Xmx8196M -Xms8196M" \

wurstmeister/kafka:0.10.1.1
在62执行
docker run -itd --name=kafka \

--restart=always \

--net=host \

--privileged=true \

-v /etc/hosts:/etc/hosts \

-v /data/kafka_cluster/kafka/data:/kafka/kafka-logs-data- \

-v /data/kafka_cluster/kafka/logs:/opt/kafka/logs \

-e KAFKA_ADVERTISED_HOST_NAME=172.16.100.62 \

-e HOST_IP=172.16.100.62 \

-e KAFKA_ADVERTISED_PORT= \

-e KAFKA_ZOOKEEPER_CONNECT=172.16.100.61:,172.16.100.62:,172.16.100.63: \

-e KAFKA_BROKER_ID= \

-e KAFKA_HEAP_OPTS="-Xmx8196M -Xms8196M" \

wurstmeister/kafka:0.10.1.1
在63执行
docker run -itd --name=kafka \

--restart=always \

--net=host \

--privileged=true \

-v /etc/hosts:/etc/hosts \

-v /data/kafka_cluster/kafka/data:/kafka/kafka-logs-data- \

-v /data/kafka_cluster/kafka/logs:/opt/kafka/logs \

-e KAFKA_ADVERTISED_HOST_NAME=172.16.100.63 \

-e HOST_IP=172.16.100.63 \

-e KAFKA_ADVERTISED_PORT= \

-e KAFKA_ZOOKEEPER_CONNECT=172.16.100.61:,172.16.100.62:,172.16.100.63: \

-e KAFKA_BROKER_ID= \

-e KAFKA_HEAP_OPTS="-Xmx8196M -Xms8196M" \

wurstmeister/kafka:0.10.1.1
##创建topic test
#订阅
docker exec -it kafka bash /opt/kafka/bin/kafka-console-consumer.sh --bootstrap-server 172.16.100.61:9092,172.16.100.62:9092,172.16.100.63:9092 --topic test --from-beginning
#发送消息
docker exec -it kafka bash /opt/kafka/bin/kafka-console-producer.sh --broker-list 172.16.100.61:9092,172.16.100.62:9092,172.16.100.63:9092 --topic test
docker 部署 zookeeper+kafka 集群的更多相关文章
- Docker搭建Zookeeper&Kafka集群
最近在学习Kafka,准备测试集群状态的时候感觉无论是开三台虚拟机或者在一台虚拟机开辟三个不同的端口号都太麻烦了(嗯..主要是懒). 环境准备 一台可以上网且有CentOS7虚拟机的电脑 为什么使用虚 ...
- 在kubernetes上部署zookeeper,kafka集群
本文采用网上镜像:mirrorgooglecontainers/kubernetes-zookeeper:1.0-3.4.10 准备共享存储:nfs,glusterfs,seaweed或其他,并在no ...
- Linux Centos7 环境搭建Docker部署Zookeeper分布式集群服务实战
Zookeeper完全分布式集群服务 准备好3台服务器: [x]A-> centos-helios:192.168.19.1 [x]B-> centos-hestia:192.168.19 ...
- Zookeeper+Kafka集群部署(转)
Zookeeper+Kafka集群部署 主机规划: 10.200.3.85 Kafka+ZooKeeper 10.200.3.86 Kafka+ZooKeeper 10.200.3.87 Kaf ...
- Zookeeper+Kafka集群部署
Zookeeper+Kafka集群部署 主机规划: 10.200.3.85 Kafka+ZooKeeper 10.200.3.86 Kafka+ZooKeeper 10.200.3.87 Kaf ...
- zookeeper+kafka集群安装之二
zookeeper+kafka集群安装之二 此为上一篇文章的续篇, kafka安装需要依赖zookeeper, 本文与上一篇文章都是真正分布式安装配置, 可以直接用于生产环境. zookeeper安装 ...
- 搭建zookeeper+kafka集群
搭建zookeeper+kafka集群 一.环境及准备 集群环境: 软件版本: 部署前操作: 关闭防火墙,关闭selinux(生产环境按需关闭或打开) 同步服务器时间,选择公网ntpd服务器或 ...
- Docker 部署 RocketMQ Dledger 集群模式( 版本v4.7.0)
文章转载自:http://www.mydlq.club/article/97/ 系统环境: 系统版本:CentOS 7.8 RocketMQ 版本:4.7.0 Docker 版本:19.03.13 一 ...
- zookeeper+kafka集群安装之一
zookeeper+kafka集群安装之一 准备3台虚拟机, 系统是RHEL64服务版. 1) 每台机器配置如下: $ cat /etc/hosts ... # zookeeper hostnames ...
随机推荐
- [CEOI2017]Building Bridges
题目 斜率优化思博题,不想写了 之后就一直\(95\)了,于是靠肮脏的打表 就是更新了一下凸壳上二分斜率的写法,非常清爽好写 就当是挂个板子了 #include<algorithm> #i ...
- [USACO08JAN]Running
嘟嘟嘟 这很显然是一道dp题. 令dp[i][j]表示第 i 分钟末,疲劳度为 j 是的最大跑步距离,则 dp[i][0] = max(dp[i - 1][0], max(dp[i - j][j])) ...
- virtualbox+vagrant学习-2(command cli)-26-vagrant share命令
Share share命令初始化了一个vagrant share会话,允许你与世界上任何一个人共享vagrant环境,允许在几乎任何网络环境中直接在vagrant环境中进行协作. 你可以在本博客的vi ...
- mongodb的学习-4-使用 MongoDB shell 来连接 Mongodb 服务
执行启动操作后,mongodb 在输出一些必要信息后不会输出任何信息,之后就等待连接的建立,当连接被建立后,就会开始打印日志信息. 使用 MongoDB shell 来连接 Mongodb 服务 标准 ...
- 利用grep命令查找字符串分析log文件的一次实践
需求场景: 我需要分析一个服务器访问日志,分析百度蜘蛛这个月对求索网页面的抓取情况. 分析问题: 我的一个access.log文件大小有35M,不可能直接通过打开查看.我需要过滤掉一些没有的信息,只保 ...
- 常用命令 tcl & shell
TCL 常用命令: 1. 当前时间 [exec date +%m%d_%H%M] (实际是调用shell命令 date),比如在 icc 中保存cell 时可以用:save_mw_cel ...
- ls: Call From hdoop2/192.168.18.87 to hdoop2:8020 failed on connection exception: java.net.ConnectException: 拒绝连接; For more details see
场景: 预发环境中,同事已经搭建了一套hadoop集群,由于版本与所需不符,所以需要替换版本 问题描述: 在配置文件都准确的情况下,启动hadoop,出现以下报错: 启动之前初始化: 初始化目录 ...
- 2018年秋季学期《C语言程序设计I》教学过程及学期总结
一学期下来,问题很多,思考也很多,需要整理.总结,好的经验要形成规律,不好的地方要提示警醒. 教学过程小结: C语言程序设计I-第一周教学 C语言程序设计I-第三周教学 C语言程序设计I-第四周教学 ...
- java学习笔记-JavaWeb篇二
JavaWEB篇二 45 HttpSession概述46 HttpSession的生命周期 47 HttpSession常用方法示例48 HttpSessionURL重写 49 HttpSession ...
- spark机制理解(一)
一 基本术语 Application: 基于Spark的用用户程序,包含了Driver程序和集群上的Executor. Driver Program: 运行行main函数并且新建SparkCont ...