
Python爬虫学习——1.爬虫入门
HTTP和HTTPS
HTTP协议(HyperText Transfer Protocol,超文本传输协议):是一种发布和接收 HTML页面的方法。
HTTPS(Hypertext Transfer Protocol over Secure Socket Layer)简单讲是HTTP的安全版,在HTTP下加入SSL层。
SSL(Secure Sockets Layer 安全套接层)主要用于Web的安全传输协议,在传输层对网络连接进行加密,保障在Internet上数据传输的安全。
HTTP的端口号为80,HTTPS的端口号为443
HTTP请求方式
- get请求:从服务器上获取指定页面信息
特点:比较便捷
缺点:不安全,参数的长度有限制
- post请求:向服务器提交数据并获取页面信息
特点:比较安全,数据整体没有限制,通常用来向HTTP服务器提交量比较大的数据(比如请求中包含许多参数或者文件上传操作等)
当发送网络请求时(需要带一定的数据给服务器,不带数据也可以),会看到请求头:request header和客户端返回数据的相应:response
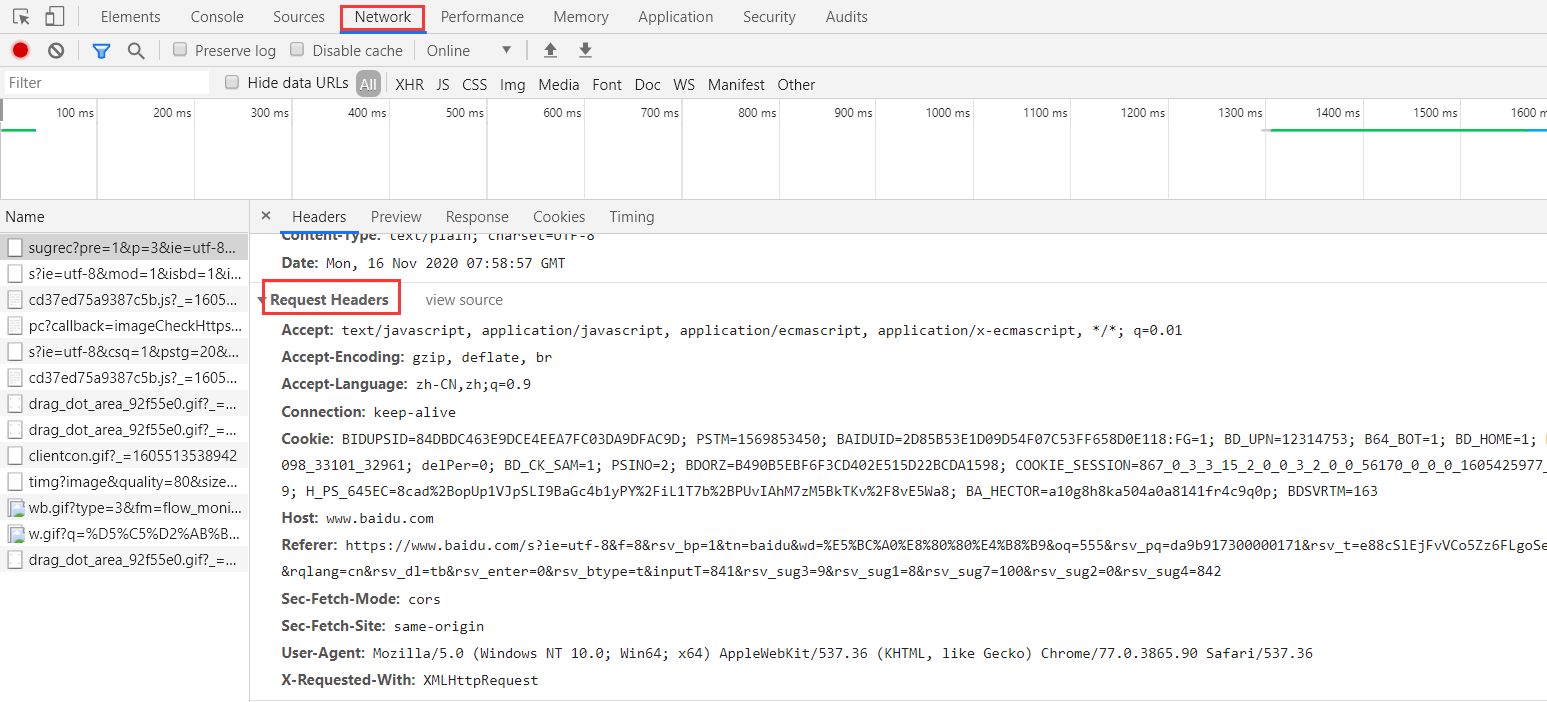
request headers包含信息:
- Accept:文本的格式
- Accept-Encoding:编码格式
- Connection:长链接/短链接
- Cookie:验证用的信息
- Host:域名
- Referer:标志从那个页面跳转过来的
- User-Agent:浏览器和用户的信息
爬虫入门
1. 什么是爬虫?
使用代码模拟用户,批量的发送网络请求,批量的获取数据。
2. 爬虫的价值?
买卖数据(高端的领域价格昂贵!!);数据分析;流量;......
3. 爬虫的合法性?
灰色产业(没有法律明确规定是否违法)。
4. 爬虫可以爬取所有东西吗?
不可以。爬虫只能怕去到用户所能访问到的信息。如腾讯视频vip用户可以爬取vip视频,普通用户只可爬取非vip的视频。
5. 爬虫的分类?
- 通用爬虫:使用搜索引擎
- 优势:开放性,速度快
- 劣势:目标不明确,返回内容大多用户不需要,不清楚用户的需求
- 聚焦爬虫!!!
- 优势:目标明确,能够精准捕捉用户需求,返回的内容固定
6. 爬虫的工作原理 ?
(1)确认你抓取目标的url是哪一个
(2)使用Python代码发送网络请求来获取数据
(3)解析获取到的数据(精确数据)
(4)数据持久化(将数据存储在本地)
学习课程:B站《廖雪峰爬虫》
Python爬虫学习——1.爬虫入门的更多相关文章
- Python 3 Anaconda 下爬虫学习与爬虫实践 (1)
环境python 3 anaconda pip 以及各种库 1.requests库的使用 主要是如何获得一个网页信息 重点是 r=requests.get("https://www.goog ...
- python库学习笔记——爬虫常用的BeautifulSoup的介绍
1. 开启Beautiful Soup 之旅 在这里先分享官方文档链接,不过内容是有些多,也不够条理,在此本文章做一下整理方便大家参考. 官方文档 2. 创建 Beautiful Soup 对象 首先 ...
- Python爬虫学习二------爬虫基本原理
爬虫是什么?爬虫其实就是获取网页的内容经过解析来获得有用数据并将数据存储到数据库中的程序. 基本步骤: 1.获取网页的内容,通过构造请求给服务器端,让服务器端认为是真正的浏览器在请求,于是返回响应.p ...
- Python 3 Anaconda 下爬虫学习与爬虫实践 (2)
下面研究如何让<html>内容更加“友好”的显示 之前略微接触的prettify能为显示增加换行符,提高可阅读性,用法如下: import requests from bs4 import ...
- Scrapy爬虫学习笔记 - 爬虫基础知识
一.正则表达式 二.深度和广度优先 三.爬虫去重策略
- python爬虫学习 —— 总目录
开篇 作为一个C党,接触python之后学习了爬虫. 和AC算法题的快感类似,从网络上爬取各种数据也很有意思. 准备写一系列文章,整理一下学习历程,也给后来者提供一点便利. 我是目录 听说你叫爬虫 - ...
- python爬虫学习(1) —— 从urllib说起
0. 前言 如果你从来没有接触过爬虫,刚开始的时候可能会有些许吃力 因为我不会从头到尾把所有知识点都说一遍,很多文章主要是记录我自己写的一些爬虫 所以建议先学习一下cuiqingcai大神的 Pyth ...
- Python实战:Python爬虫学习教程,获取电影排行榜
Python应用现在如火如荼,应用范围很广.因其效率高开发迅速的优势,快速进入编程语言排行榜前几名.本系列文章致力于可以全面系统的介绍Python语言开发知识和相关知识总结.希望大家能够快速入门并学习 ...
- 《Python爬虫学习系列教程》学习笔记
http://cuiqingcai.com/1052.html 大家好哈,我呢最近在学习Python爬虫,感觉非常有意思,真的让生活可以方便很多.学习过程中我把一些学习的笔记总结下来,还记录了一些自己 ...
随机推荐
- 尝试用面向对象思维理解Vue组件
什么是组件 用面向对象的思维去理解Vue组件,可以将所有的事物都抽象为对象,而类或者说是组件,都具有属性和操作. 如抽取人类为组件,其基本的属性有姓名.年龄.国籍:基本的方法有吃饭.睡觉.跑步等. & ...
- 初探 Redis 客户端 Lettuce:真香!
一.Lettuce 是啥? 一次技术讨论会上,大家说起 Redis 的 Java 客户端哪家强,我第一时间毫不犹豫地喊出 "Jedis, YES!" "Jedis 可是官 ...
- 关于vector.size()的一些常见错误总结
1. 问题引入 通过查看[https://www.cplusplus.com/reference/vector/vector/] 的vector.size()说明,即 member type defi ...
- WPF教程一:创建Hello world来理解XAML的内容及编译
在实际的WPF开发中遇到很多再用Winform写法来写WPF的开发人员,很多时候项目进度延期.出现非必要的BUG等等.大多是因为开发人员虽然是再写WPF. 但是没有好好的学过WPF,就导致无法发挥出W ...
- Selenium启动Chrome浏览器提示“请停用以开发者模式运行的扩展程序”的解决办法
安装了python selenium,运行下面代码: 1 from selenium import webdriver 2 3 browser = webdriver.Chrome() 4 brows ...
- NOIP模拟赛T3 斐波那契
1.题目 求 \[\sum_{i=1}^n \sum_{j=1}^m \gcd(F_i,F_j) \] 其中 \(F_k\) 表示斐波那契数列的第 \(k\) 项,对 \(10^9 + 7\) 取模. ...
- celery task异步任务
业务端后台:通过python manage运行 运行用例时,用python manage运行时会卡,影响效率 celery task 本身自己也是个服务,异步处理case 异步:小明去给我买个东西,我 ...
- PYTHON matplotlib入门
'''作为线性图的替代,可以通过向 plot() 函数添加格式字符串来显示离散值. 可以使用以下格式化字符. 字符 描述 '-' 实线样式 '--' 短横线样式 '-.' 点划线样式 ':' 虚线样式 ...
- 三、k8s集群可用性验证与调参(第一章、k8s高可用集群安装)
作者:北京小远 出处:http://www.cnblogs.com/bj-xy/ 参考课程:Kubernetes全栈架构师(电脑端购买优惠) 文档禁止转载,转载需标明出处,否则保留追究法律责任的权利! ...
- python函数的坑
一.默认参数的坑,如果你的默认参数指向的是可变的数据类型,那么你无论调用多少次这个默认参数,都是同一个. def func(a,list=[]): list.append(a) return list ...