
MapReduce06 MapReduce工作机制
5 MapReduce工作机制(重点)
5.1 MapTask工作机制
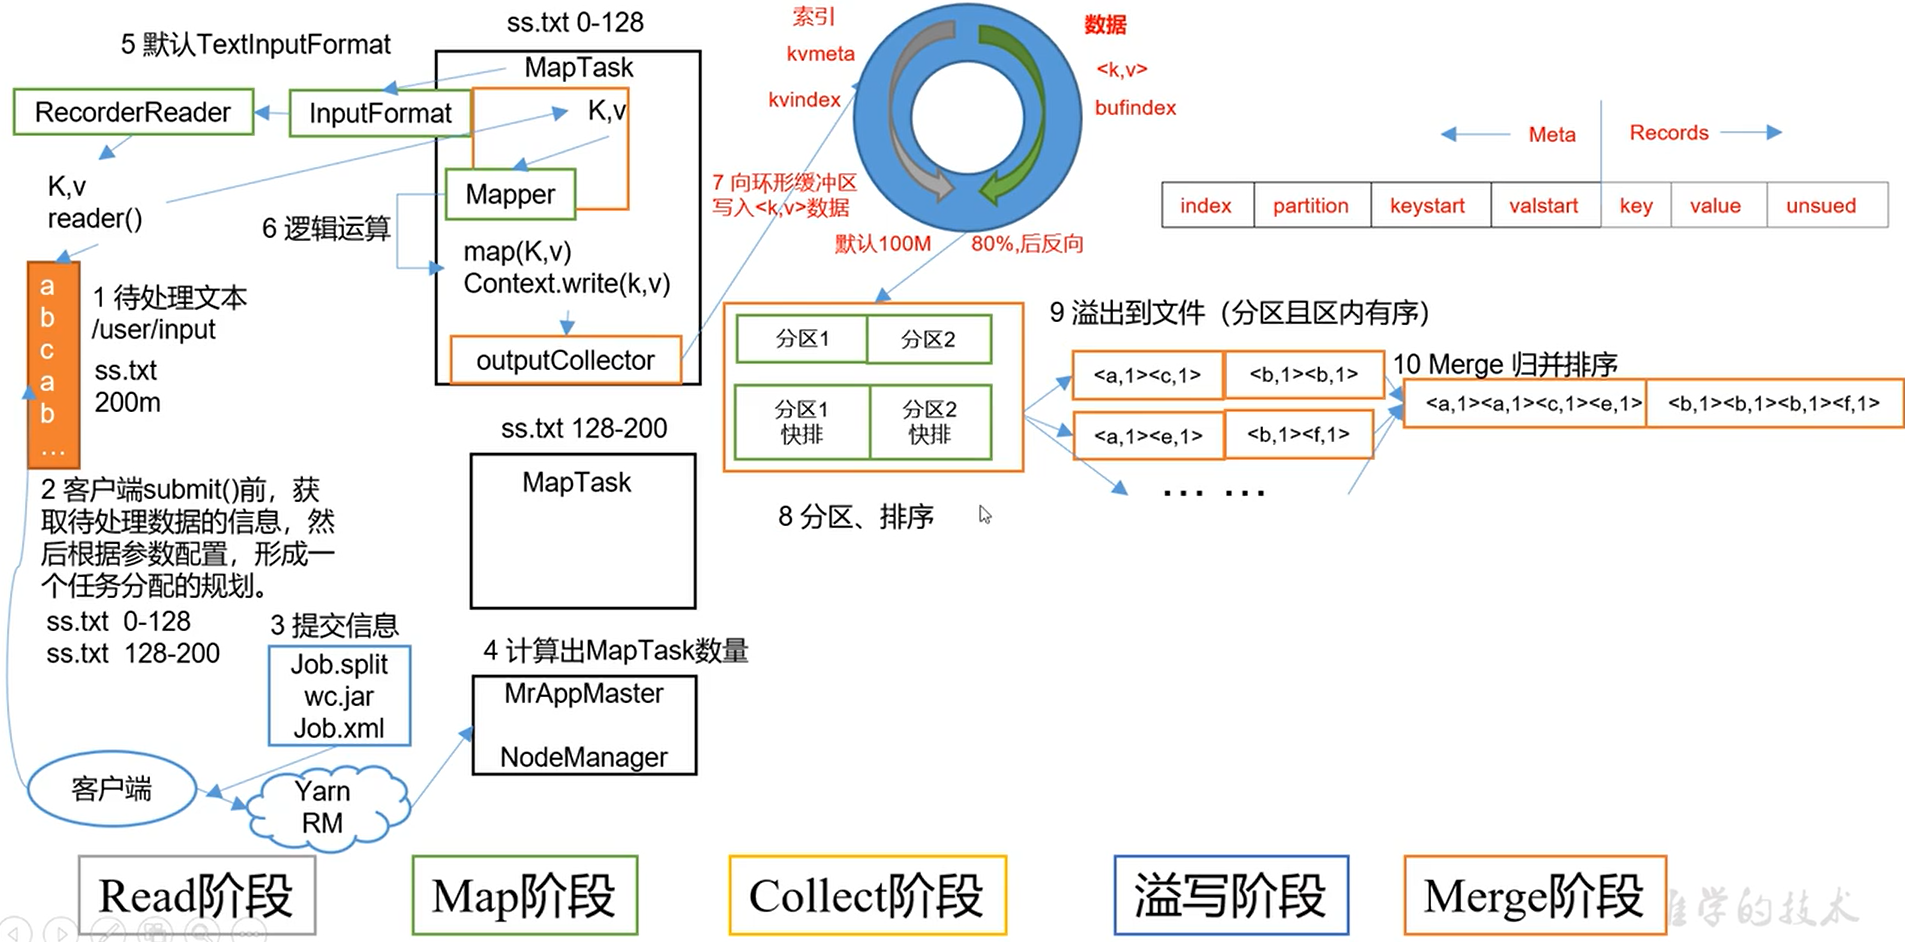
Read阶段
主要是Job的提交流程
1.切片划分
2.提交给Yarn
Job.split 切片信息
wc.jar 集群模式会提交,本地模式不会提交
Job.xml 配置信息
3.Yarn开启NodeManager(单个节点服务器资源老大) AppMaster(单个任务运行的老大) AppMaster开启对应的MapTask进入Map阶段
4.由InputFormat读取数据,默认TextInputFormat,读完之后返回给map,进入用户自己写的Mapper。一个MapTask产生一个文件
5.2 ReduceTask工作机制
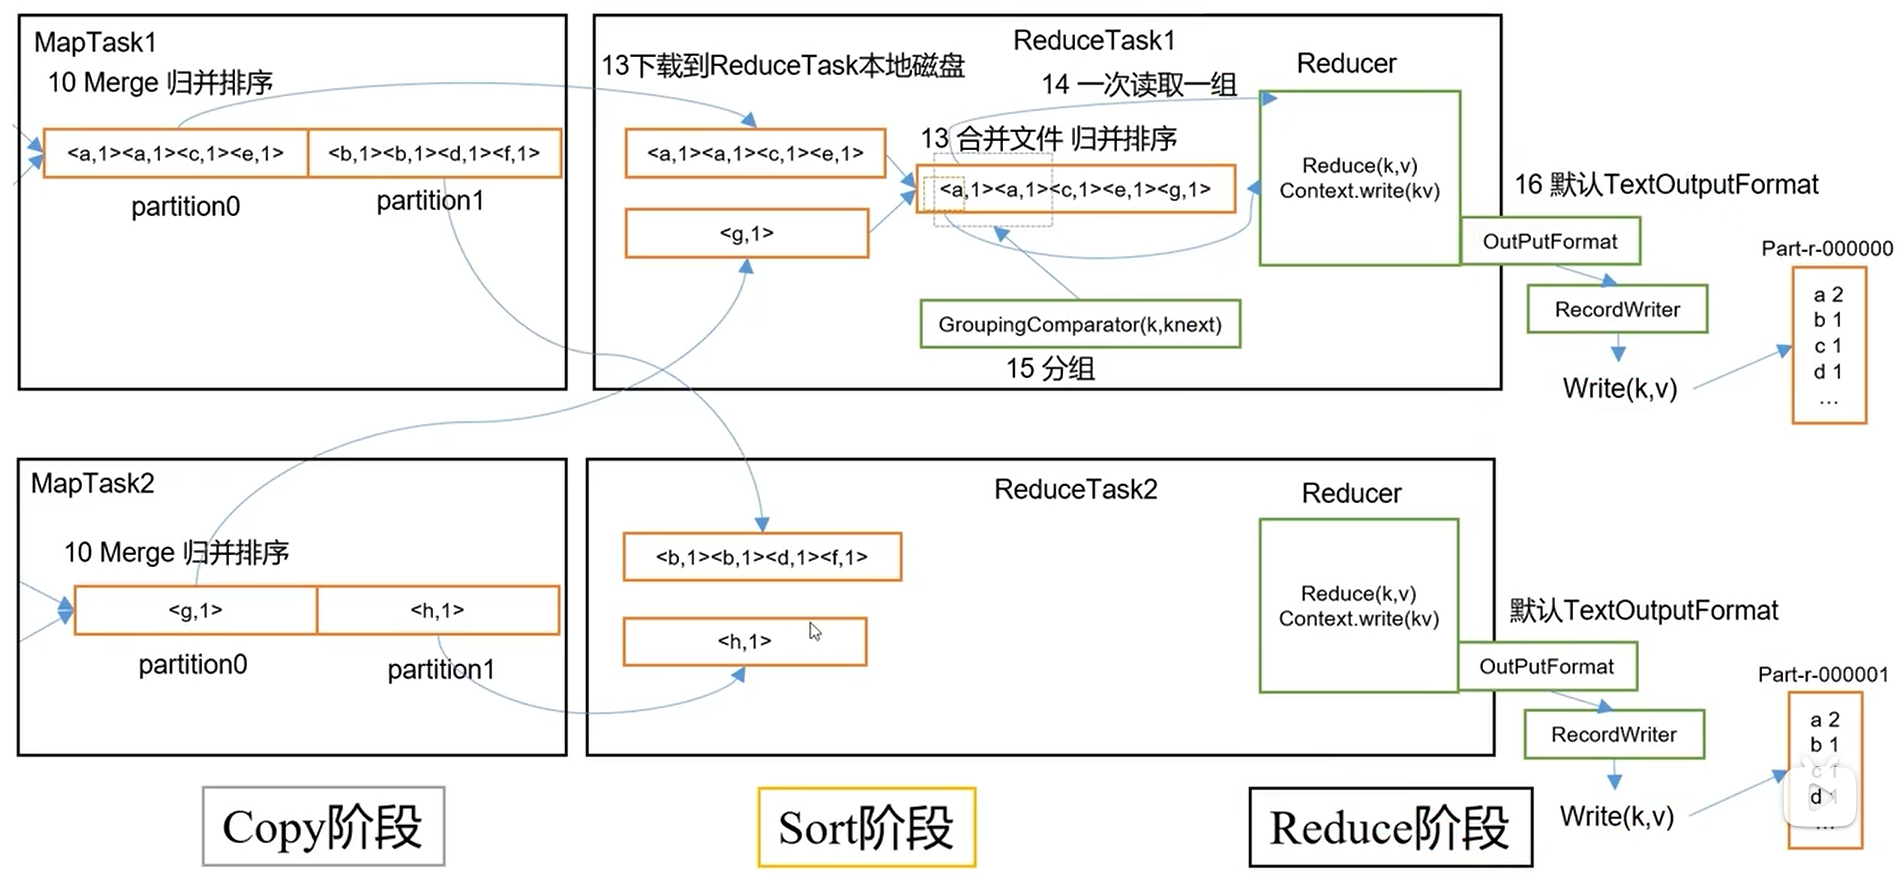
ReduceTask主动去抓取数据
5.3 ReduceTask并行度决定机制
MapTask并行度由切片个数决定,切片个数由输入文件和切片规则决定。
computeSplitSize(Math.max(minSize,Math.min(maxSize,blocksize)))
ReduceTask并行度由谁决定?
手动设置ReduceTask数量
//设置ReduceTasks的个数

job.setNumReduceTasks(5);
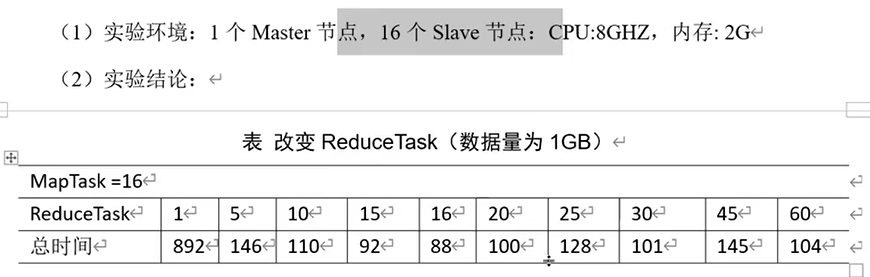
测试ReduceTask多少合适
注意事项
1.ReduceTask=0,表示没有Reduce阶段,输出文件个数和Map个数一致。
2.ReduceTask默认值就是1,所以输出文件个数为一个。
3.如果数据分布不均匀,就有可能在Reduce阶段产生数据倾斜(如136 1亿个,其他1个)
4.ReduceTask数量并不是任意设置,还要考虑业务逻辑需求,有些情况下,需要计算全局汇总结果,就只能有1个ReduceTask。
5.具体多少个ReduceTask,需要根据集群性能而定。
6.如果分区数不是1,但是ReduceTask为1,是否执行分区过程。答案是:不执行分区过程。因为在MapTask的源码中,执行分区的前提是先判断ReduceNum个数是否大于1。不大于1肯定不执行。
MapReduce06 MapReduce工作机制的更多相关文章
- hadoop MapReduce 工作机制
摸索了将近一个月的hadoop , 在centos上配了一个伪分布式的环境,又折腾了一把hadoop eclipse plugin,最后终于实现了在windows上编写MapReduce程序,在cen ...
- MapReduce工作机制——Word Count实例(一)
MapReduce工作机制--Word Count实例(一) MapReduce的思想是分布式计算,也就是分而治之,并行计算提高速度. 编程思想 首先,要将数据抽象为键值对的形式,map函数输入键值对 ...
- hadoop知识点总结(一)hadoop架构以及mapreduce工作机制
1,为什么需要hadoop 数据分析者面临的问题 数据日趋庞大,读写都出现性能瓶颈: 用户的应用和分析结果,对实时性和响应时间要求越来越高: 使用的模型越来越复杂,计算量指数级上升. 期待的解决方案 ...
- 浅谈MapReduce工作机制
1.MapTask工作机制 整个map阶段流程大体如上图所示.简单概述:input File通过getSplits被逻辑切分为多个split文件,通通过RecordReader(默认使用lineRec ...
- [hadoop读书笔记] 第五章 MapReduce工作机制
P205 MapReduce的两种运行机制 第一种:经典的MR运行机制 - MR 1 可以通过一个简单的方法调用来运行MR作业:Job对象上的submit().也可以调用waitForCompleti ...
- MapReduce工作机制
MapReduce是什么? MapReduce是一种分布式计算模型,由Google提出,主要用于搜索领域,MapReduce程序本质上是并行运行的,因此可以解决海量数据的计算问题. MapReduce ...
- yarn/mapreduce工作机制及mapreduce客户端代码编写
首先需要知道的就是在老版本的hadoop中是没有yarn的,mapreduce既负责资源分配又负责业务逻辑处理.为了解耦,把资源分配这块抽了出来,形成了yarn,这样不仅mapreudce可以用yar ...
- 图文详解MapReduce工作机制
job提交阶段 1.准备好待处理文本. 2.客户端submit()前,获取待处理数据的信息,然后根据参数配置,形成一个任务分配的规划. 3.客户端向Yarn请求创建MrAppMaster并提交切片等相 ...
- MapReduce的工作机制
<Hadoop权威指南>中的MapReduce工作机制和Shuffle: 框架 Hadoop2.x引入了一种新的执行机制MapRedcue 2.这种新的机制建议在Yarn的系统上,目前用于 ...
随机推荐
- MyBatis源码分析(七):动态代理(Mybatis核心机制)
一.动态代理 动态代理是一种比较高级的代理模式,它的典型应用就是Spring AOP. 在传统的动态代理模式中,客户端通过ProxySubject调用RealSubject类的request( )方法 ...
- fatal error: sqlite3.h: No such file or directory
编译带有sqlite3的数据库c语言程序时,出现fatal error: sqlite3.h: No such file or directory,找不到头文件的问题.应该是是系统没有安装函数库. 在 ...
- 最近公共祖先(lca)与树上叉分
lca的定义不在过多解释, 代码如下: inline void bfs() { queue<int>q; deep[s]=1;q.push(s); while(!q.empty()) { ...
- pku 2425 A Chess Game (SG)
题意: 给一个由N个点组成的一张有向图,不存在环.点的编号是0~N-1. 然后给出M个棋子所在的位置(点的编号)[一个点上可同时有多个棋子]. 每人每次可移动M个棋子中的一个棋子一步,移动方向是有向边 ...
- 聊了聊宏内核和微内核,并吹了一波 Linux
看这里!!!https://mp.weixin.qq.com/s?__biz=MzI0ODk2NDIyMQ==&mid=2247494048&idx=1&sn=cacfc6a4 ...
- 为什么IDEA不推荐你使用@Autowired ?
@Autowired注解相信每个Spring开发者都不陌生了!在DD的Spring Boot基础教程和Spring Cloud基础教程中也都经常会出现. 但是当我们使用IDEA写代码的时候,经常会发现 ...
- pycharm基本使用与破解
一.pycharm基本使用 pycharm这款ide软件虽然功能强大,但正因为他的强大,所以小白在刚使用这款软件时上手会有点难度,今天我们就来介绍一下ptcharm的基本使用. 1.基本配置 我们安装 ...
- EF Core 小技巧:迁移已经应用到数据库,如何进行迁移回退操作?
场景描述:项目中存在两个迁移 Teacher 和 TeachingPlan ,TeachingPlan 在 Teacher 之后创建,并且已经执行 dotnet ef database update ...
- Linux usb 4. Device 详解
文章目录 1. 简介 2. Platform Layer 2.1 Platform Device 2.2 Platform Driver 3. UDC/Gadget Layer 3.1 Gadget ...
- java中将double保留两位小数,将double保留两位小数并转换成String
将Double类型的数据保留2位小数: Double a = 3.566; BigDecimal bd = new BigDecimal(a); Double d = bd.setScale(2, B ...