
[转]SparkSQL – 有必要坐下来聊聊Join
转载自网易范欣欣http://hbasefly.com
Join背景介绍
Join是数据库查询永远绕不开的话题,传统查询SQL技术总体可以分为简单操作(过滤操作-where、排序操作-limit等),聚合操作-groupBy等以及Join操作等。其中Join操作是其中最复杂、代价最大的操作类型,也是OLAP场景中使用相对较多的操作。因此很有必要聊聊这个话题。
另外,从业务层面来讲,用户在数仓建设的时候也会涉及Join使用的问题。通常情况下,数据仓库中的表一般会分为”低层次表”和“高层次表”。
所谓”低层次表”,就是数据源导入数仓之后直接生成的表,单表列值较少,一般可以明显归为维度表或者事实表,表和表之间大多存在外健依赖,所以查询起来会遇到大量Join运算,查询效率相对比较差。而“高层次表”是在”低层次表”的基础上加工转换而来,通常做法是使用SQL语句将需要Join的表预先进行合并形成“宽表”,在宽表上的查询因为不需要执行大量Join因而效率相对较高,很明显,宽表缺点是数据会有大量冗余,而且生成相对比较滞后,查询结果可能并不及时。
因此,为了获得实效性更高的查询结果,大多数场景还是需要进行复杂的Join操作。Join操作之所以复杂,不仅仅因为通常情况下其时间空间复杂度高,更重要的是它有很多算法,在不同场景下需要选择特定算法才能获得最好的优化效果。关系型数据库也有关于Join的各种用法,姜承尧大神之前由浅入深地介绍过MySQL Join的各种算法以及调优方案(关注公众号InsideMySQL并回复join可以查看相关文章)。本文接下来会介绍SparkSQL所支持的几种常见的Join算法以及其适用场景。
Join常见分类以及基本实现机制
当前SparkSQL支持三种Join算法-shuffle hash join、broadcast hash join以及sort merge join。其中前两者归根到底都属于hash join,只不过在hash join之前需要先shuffle还是先broadcast。其实,这些算法并不是什么新鲜玩意,都是数据库几十年前的老古董了(参考),只不过换上了分布式的皮而已。不过话说回来,SparkSQL/Hive…等等,所有这些大数据技术哪一样不是来自于传统数据库技术,什么语法解析AST、基于规则优化(CRO)、基于代价优化(CBO)、列存,都来自于传统数据库。就拿shuffle hash join和broadcast hash join来说,hash join算法就来自于传统数据库,而shuffle和broadcast是大数据的皮,两者一结合就成了大数据的算法了。因此可以这样说,大数据的根就是传统数据库,传统数据库人才可以很快的转型到大数据。好吧,这些都是闲篇。
继续来看技术,既然hash join是’内核’,那就刨出来看看,看完把’皮’再分析一下。
Hash Join
先来看看这样一条SQL语句:select * from order,item where item.id = order.i_id,很简单一个Join节点,参与join的两张表是item和order,join key分别是item.id以及order.i_id。现在假设这个Join采用的是hash join算法,整个过程会经历三步:
1. 确定Build Table以及Probe Table:这个概念比较重要,Build Table使用join key构建Hash Table,而Probe Table使用join key进行探测,探测成功就可以join在一起。通常情况下,小表会作为Build Table,大表作为Probe Table。此事例中item为Build Table,order为Probe Table。
2. 构建Hash Table:依次读取Build Table(item)的数据,对于每一行数据根据join key(item.id)进行hash,hash到对应的Bucket,生成hash table中的一条记录。数据缓存在内存中,如果内存放不下需要dump到外存。
3. 探测:再依次扫描Probe Table(order)的数据,使用相同的hash函数映射Hash Table中的记录,映射成功之后再检查join条件(item.id = order.i_id),如果匹配成功就可以将两者join在一起。
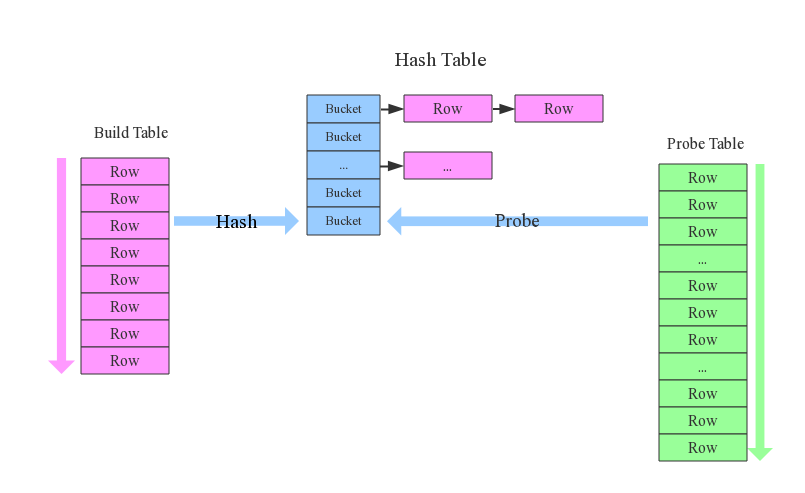
基本流程可以参考上图,这里有两个小问题需要关注:
1. hash join性能如何?很显然,hash join基本都只扫描两表一次,可以认为o(a+b),较之最极端的笛卡尔集运算a*b,不知甩了多少条街
2. 为什么Build Table选择小表?道理很简单,因为构建的Hash Table最好能全部加载在内存,效率最高;这也决定了hash join算法只适合至少一个小表的join场景,对于两个大表的join场景并不适用;
上文说过,hash join是传统数据库中的单机join算法,在分布式环境下需要经过一定的分布式改造,说到底就是尽可能利用分布式计算资源进行并行化计算,提高总体效率。hash join分布式改造一般有两种经典方案:
1. broadcast hash join:将其中一张小表广播分发到另一张大表所在的分区节点上,分别并发地与其上的分区记录进行hash join。broadcast适用于小表很小,可以直接广播的场景。
2. shuffler hash join:一旦小表数据量较大,此时就不再适合进行广播分发。这种情况下,可以根据join key相同必然分区相同的原理,将两张表分别按照join key进行重新组织分区,这样就可以将join分而治之,划分为很多小join,充分利用集群资源并行化。
Broadcast Hash Join
如下图所示,broadcast hash join可以分为两步:
1. broadcast阶段:将小表广播分发到大表所在的所有主机。广播算法可以有很多,最简单的是先发给driver,driver再统一分发给所有executor;要不就是基于bittorrete的p2p思路;
2. hash join阶段:在每个executor上执行单机版hash join,小表映射,大表试探;

SparkSQL规定broadcast hash join执行的基本条件为被广播小表必须小于参数spark.sql.autoBroadcastJoinThreshold,默认为10M。
Shuffle Hash Join
在大数据条件下如果一张表很小,执行join操作最优的选择无疑是broadcast hash join,效率最高。但是一旦小表数据量增大,广播所需内存、带宽等资源必然就会太大,broadcast hash join就不再是最优方案。此时可以按照join key进行分区,根据key相同必然分区相同的原理,就可以将大表join分而治之,划分为很多小表的join,充分利用集群资源并行化。如下图所示,shuffle hash join也可以分为两步:
1. shuffle阶段:分别将两个表按照join key进行分区,将相同join key的记录重分布到同一节点,两张表的数据会被重分布到集群中所有节点。这个过程称为shuffle
2. hash join阶段:每个分区节点上的数据单独执行单机hash join算法。
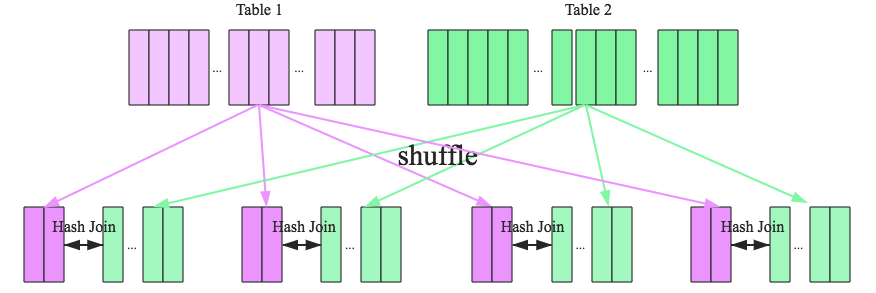
看到这里,可以初步总结出来如果两张小表join可以直接使用单机版hash join;如果一张大表join一张极小表,可以选择broadcast hash join算法;而如果是一张大表join一张小表,则可以选择shuffle hash join算法;那如果是两张大表进行join呢?
Sort-Merge Join
SparkSQL对两张大表join采用了全新的算法-sort-merge join,如下图所示,整个过程分为三个步骤:
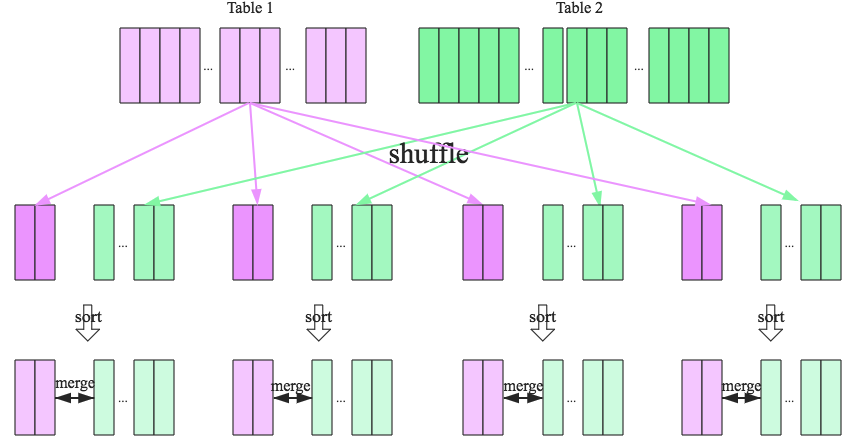
1. shuffle阶段:将两张大表根据join key进行重新分区,两张表数据会分布到整个集群,以便分布式并行处理
2. sort阶段:对单个分区节点的两表数据,分别进行排序
3. merge阶段:对排好序的两张分区表数据执行join操作。join操作很简单,分别遍历两个有序序列,碰到相同join key就merge输出,否则取更小一边,见下图示意:
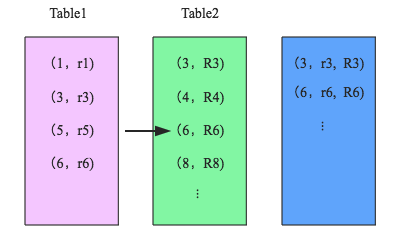
仔细分析的话会发现,sort-merge join的代价并不比shuffle hash join小,反而是多了很多。那为什么SparkSQL还会在两张大表的场景下选择使用sort-merge join算法呢?这和Spark的shuffle实现有关,目前spark的shuffle实现都适用sort-based shuffle算法,因此在经过shuffle之后partition数据都是按照key排序的。因此理论上可以认为数据经过shuffle之后是不需要sort的,可以直接merge。
经过上文的分析,可以明确每种Join算法都有自己的适用场景,数据仓库设计时最好避免大表与大表的join查询,SparkSQL也可以根据内存资源、带宽资源适量将参数spark.sql.autoBroadcastJoinThreshold调大,让更多join实际执行为broadcast hash join。
[转]SparkSQL – 有必要坐下来聊聊Join的更多相关文章
- SparkSQL大数据实战:揭开Join的神秘面纱
本文来自 网易云社区 . Join操作是数据库和大数据计算中的高级特性,大多数场景都需要进行复杂的Join操作,本文从原理层面介绍了SparkSQL支持的常见Join算法及其适用场景. Join背景介 ...
- supervisor、pm2、forever坐下来聊聊
supervisor 是开发环境用.或者用nodemon,node-dev 代替了supervisor 和 nodemon,它和coffeescript兼容最好. forever 管理多个站点,每个站 ...
- SparkSQL的3种Join实现
引言 Join是SQL语句中的常用操作,良好的表结构能够将数据分散在不同的表中,使其符合某种范式,减少表冗余.更新容错等.而建立表和表之间关系的最佳方式就是Join操作. 对于Spark来说有3中Jo ...
- Spark SQL中的几种join
1.小表对大表(broadcast join) 将小表的数据分发到每个节点上,供大表使用.executor存储小表的全部数据,一定程度上牺牲了空间,换取shuffle操作大量的耗时,这在SparkSQ ...
- Spark SQL 之 Join 实现
原文地址:Spark SQL 之 Join 实现 Spark SQL 之 Join 实现 涂小刚 2017-07-19 217标签: spark , 数据库 Join作为SQL中一个重要语法特性,几乎 ...
- Spark第一个应用程序
首先要对源码进行编译,生成对应hadoop版本的spark开发程序jar包,上篇已经写了具体的过程,这里不再赘述. 在安装spark的机器上,下载eclipse-java-x86_64版本,将spar ...
- 用ndp部署storm应用
本文由作者余宝虹授权网易云社区发布. 使用户ndp部署一个Java应用大家都非常熟悉的,但是看到某些同学用非常繁琐的方式部署storm应用的时候,我觉得很有必要整一个帮助教程,ndp帮助文档里面没有, ...
- Apache 流框架 Flink,Spark Streaming,Storm对比分析(1)
此文已由作者岳猛授权网易云社区发布. 欢迎访问网易云社区,了解更多网易技术产品运营经验. 1.Flink架构及特性分析 Flink是个相当早的项目,开始于2008年,但只在最近才得到注意.Flink是 ...
- sparksql的三种join实现
join 是sql语句中的常用操作,良好的表结构能够将数据分散在不同的表中,使其符合某种范式,减少表冗余,更新容错等.而建立表和表之间关系的最佳方式就是Join操作. sparksql作为大数据领域的 ...
随机推荐
- ubuntu13.10更新sources.list
步骤: 1>设置网络连接方式,NAT 2>自动获取ip address 10.0.2.15 3>更新源soureces.list soureces.list deb http://m ...
- [CMake笔记] CMake向解决方案添加源文件兼头文件
回顾 在上一篇笔记里总结的时候说到,aux_source_directory这个函数在添加源码文件时,是不会把头文件添加进去的,这里就介经一下另外一个方法,也是我一直使用的. 添加文件*.cpp与*. ...
- python 网络爬虫(三)
一.网站地图爬虫 在一个简单的爬虫中,我们将使用实例网站 robots.txt 文件中发现的网站地图来下载所有网站,为了解析网站地图,我们将会使用一个简单的正则表达式,从<loc>标签中提 ...
- Liunx 如何查看80端口被哪个程序所占用
场景:启服务时一直报80端口被占用 解决方: 1.首先查看下 80 端口的使用情况 netstat -anp|grep 80 查看80端口被被占用的PID 2.根据这个PID 来查看被哪个程序在使用 ...
- SSH和screen服务
SSH是一种能够以安全的方式提供远程登录的协议,目前远程管理的首选方式,sshd是基于SSH协议开发的一款远程管理服务程序,在Linux系统中需要部署sshd服务程序才能使用SSH协议来进行远程管理, ...
- PromQL操作符
PromQL操作符 使用PromQL除了能够方便的按照查询和过滤时间序列以外,PromQL还支持丰富的操作符,用户可以使用这些操作符对进一步的对事件序列进行二次加工.这些操作符包括:数学运算符,逻辑运 ...
- 联想电脑硬盘保护系统EDU8.0.1iso安装
管理306机房4年了,15年我带领的第一批学生参加吉林省职业院校技能大赛的时候,领导把这个机房交给我负责.那个时候这个机房的机器是全校的顶配,30台DELL16G内存,2T硬盘,I7处理器,后面是6组 ...
- Oracle笔记--PL/SQL(Procedure Language & Structured Query Language)
1.PL/SQL是一种高级数据库程序设计语言,专门用于在各种环境下对Oracle数据库进行访问.该语言集成于数据库服务器中,所以PL/SQL代码可以对数据进行快速高效的处理. 2.PL/SQL是对SQ ...
- Day9 - G - Doing Homework HDU - 1074
有n个任务,每个任务有一个截止时间,超过截止时间一天,要扣一个分.求如何安排任务,使得扣的分数最少.Input有多组测试数据.第一行一个整数表示测试数据的组数第一行一个整数n(1<=n<= ...
- 「Luogu2264」情书
传送门 Luogu 解题思路 字符串模拟SB题,STL随便搞. 详情见代码. 细节注意事项 STL总得会吧. 参考代码 #include <algorithm> #include < ...