
02.Scrapy-Demo
Scrapy入门实战
采集目标:采集西祠网的IP代理 包括 IP PORT
1. 新建项目
scrapy startproject xicidailiSpider

# scrapy 新建项目  项目名
2. 创建爬虫
scrapy genspider xicidaili xicidaili.com

# scrapy 产生爬虫  爬虫名字   网站域名

# 注意:爬虫名字一定不能与项目名字一致!

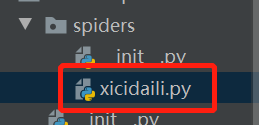
可以看到,在项目的spiders下得到了一个爬虫文件
解释爬虫文件
import scrapy # 导入scrapy

# 创建爬虫类 并且继承自scrapy.Spider --> 爬虫最基础的类

# 另外几个类都是继承自这个类

class XicidailiSpider(scrapy.Spider):

    #爬虫名字 --> 必须唯一

    name = 'xicidaili'

    # 允许采集的域名

    allowed_domains = ['xicidaili.com']

    # 开始采集的网站

    start_urls = ['http://xicidaili.com/']

	# 解析响应数据 提取数据 或者网址等 response就是网页源码

    def parse(self, response):

        pass
3. 分析网址
提取数据
- 正则表达式(基础 必回 难掌握)
- XPath --> 从HTML中国提取数据语法
- CSS --> 从HTML中国提取数据语法
response.xpath("xpath语法").get()
get() 是得到一个元素
getall() 是多个元素
class XicidailiSpider(scrapy.Spider):

    name = 'xicidaili'

    allowed_domains = ['xicidaili.com']

    start_urls = ['https://www.xicidaili.com/nn/']

    # start_urls = [f'https://www.xicidaili.com/nn/{page}' for page in range(1,3685)]

    def parse(self, response):

        # 提取数据

        # response.xpath("//tr/td[2]/text()")

        selectors = response.xpath("//tr")

        for selector in selectors:

            ip = selector.xpath("./td[2]/text()").get() # . 在当前节点下继续选择

            port = selector.xpath("./td[3]/text()").get()

            # ip = selector.xpath("./td[2]/text()").extract_first()  # 与get等价

            # port = selector.xpath("./td[3]/text()").extract_first()

            print(ip,port)
4. 运行爬虫
scrapy crawl 爬虫名字
		# 翻页操作

        next_page = response.xpath('//a[@class="next_page"]/@href').get()

        if next_page:

            print(next_page)

            # 拼接网址

            next_url = response.urljoin(next_page)

            yield scrapy.Request(next_url,callback=self.parse) # yield 生成器

# Request() 发送请求 类似requests.get()

# callback 是回调函数 将发出去的请求得到的响应还交给自己(self.parse)处理

# 注意:回调函数不要写() 只写方法名字
02.Scrapy-Demo的更多相关文章
- c#&.NET3.0高级程序设计-02 Enum Demo
Enum 实例 using System; using System.Collections.Generic; public class MyClass { enum EmpType ...
- scrapy爬取58同城二手房问题与对策
测试环境: win10,单机爬取,scrapy1.5.0,python3.6.4,mongodb,Robo 3T 其他准备: 代理池:测试环境就没有用搭建的flask抓代理,因为我找到的几个免费网站有 ...
- 爬虫——scrapy框架
Scrapy是一个异步处理框架,是纯Python实现的爬虫框架,其架构清晰,模块之间的耦合程度低,可拓展性强,可以灵活完成各种需求.我们只需要定制几个模块就可以轻松实现一个爬虫. 1.架构 Scra ...
- 05 爬虫之scrapy
一 scrapy框架简介 01 什么是scrapy: Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架,非常出名,非常强悍.所谓的框架就是一个已经被集成了各种功能(高性能异步下载,队 ...
- py库: scrapy (深坑未填)
scrapy 一个快速高级的屏幕爬取及网页采集框架 http://scrapy.org/ 官网 https://docs.scrapy.org/en/latest/ Scrapy1.4文档 http: ...
- 萌新学习Python爬取B站弹幕+R语言分词demo说明
代码地址如下:http://www.demodashi.com/demo/11578.html 一.写在前面 之前在简书首页看到了Python爬虫的介绍,于是就想着爬取B站弹幕并绘制词云,因此有了这样 ...
- Scrapy 概览笔记
本项目代码可参考 imzhizi/myspider: a scrapy demo with elasticsearch 虚拟环境的创建 建议爬虫项目都创建虚拟环境 虚拟环境在 Python 项目中真的 ...
- Python Scrapy 实战
Python Scrapy 什么是爬虫? 网络爬虫(英语:web crawler),也叫网络蜘蛛(spider),是一种用来自动浏览万维网的网络机器人.其目的一般为编纂网络索引. Python 爬虫 ...
- Scrapy--1安装和运行
1.Scrapy安装问题 一开始是按照官方文档上直接用pip安装的,创建项目的时候并没有报错, 然而在运行 scrapy crawl dmoz 的时候错误百粗/(ㄒoㄒ)/~~比如: ImportEr ...
- python3高级编程
1. SMTP发送邮件 internet相关协议: http:网页访问相关,httplib,urllib,xmlrpclib ftp:文件传输相关, ftplib, urllib nntp:新闻和帖子 ...
随机推荐
- 这个Maven依赖的问题,你敢说你没遇到过
Maven 依赖没处理好的话经常会导致发生一些问题,非常烦.今天给大家分享一个依赖相关的问题,说不定你之前就遇到过. 问题背景 有个 ES 搜索的项目,刚开始还是好好的状态,过了一段时间,然后就发现启 ...
- MongoDB学习(一) 安装与基本使用
链接:https://pan.baidu.com/s/1ogTDFJg3ZZc0CyzaTeswWg 提取码:2k0p 安装 // 将压缩包解压到指定目录 [bigdata@linux backup] ...
- Rocket - debug - Example: Triggers
https://mp.weixin.qq.com/s/zPNyrBOhsytkRrZTDTEvpw 介绍riscv-debug的使用实例:配置Triggers功能. 1. Trigger Trigge ...
- Rocket - tilelink - RegionReplicator
https://mp.weixin.qq.com/s/XZVCdt50tM6lavchGm9GRg 简单介绍RegionReplicator的实现. 1. 基本介绍 根据mask ...
- 居然还有人这样解说mybatis运行原理
目录 Mybatis基本认识 动态代理 JDK实现 CGLIB动态代理 总结 反射 Configuration对象作用 映射器结构 sqlsession执行流程(源码跟踪) Executor Stat ...
- Java实现 LeetCode 654 最大二叉树(递归)
654. 最大二叉树 给定一个不含重复元素的整数数组.一个以此数组构建的最大二叉树定义如下: 二叉树的根是数组中的最大元素. 左子树是通过数组中最大值左边部分构造出的最大二叉树. 右子树是通过数组中最 ...
- Java实现 LeetCode 214 最短回文串
214. 最短回文串 给定一个字符串 s,你可以通过在字符串前面添加字符将其转换为回文串.找到并返回可以用这种方式转换的最短回文串. 示例 1: 输入: "aacecaaa" 输出 ...
- Java实现最大流量问题
1 问题描述 何为最大流量问题? 给定一个有向图,并为每一个顶点设定编号为0~n,现在求取从顶点0(PS:也可以称为源点)到顶点n(PS:也可以称为汇点)后,顶点n能够接收的最大流量.图中每条边的权值 ...
- Python学习之斐波那契数列实现篇
描述 一个斐波那契序列,F(0) = 0, F(1) = 1, F(n) = F(n-1) + F(n-2) (n>=2),根据n的值,计算斐波那契数F(n),其中0≤n≤1000. 输入 输入 ...
- 移除VS解决方案中的TFS版本控制
项目每次会弹出提示 正在打开的解决方案已绑定到以下 Azure DevOps Server 上的源代码管理: xxxxx.是否要联系此服务器以尝试启用源代码管理集成? 移除VS解决方案中的TFS版本控 ...