
爬虫——scrapy框架
Scrapy是一个异步处理框架,是纯Python实现的爬虫框架,其架构清晰,模块之间的耦合程度低,可拓展性强,可以灵活完成各种需求。我们只需要定制几个模块就可以轻松实现一个爬虫。
1.架构

Scrapy Engine,引擎,负责整个系统的数据流处理、触发事务,是整个框架的核心。
Item,项目,它定义了爬取结果的数据结构,爬取的数据会被赋值成Item对象。
Scheduler,调度器,接受引擎发送过来的请求,并将其加入到队列之中,在引擎再次请求时将请求提供给引擎。
Downloader,下载器,下载网页内容,并将网页内容返回给爬虫。
Sprider,爬虫,其内定义了爬取逻辑和网页的解析规则,它主要负责解析响应并生成提取结果的新的请求。
Item Pipeline,项目管道,负责处理由爬虫从网页中提取的项目,它的主要任务是清洗、验证和存储数据。
Downloader Middlewares,下载器中间件,位于引擎和下载器直接的钩子框架,主要处理引擎与下载器之间的请求和响应。
Spider Middle,爬虫中间件,位于引擎和爬虫之间的钩子框架,主要处理爬虫输入的响应和输出的结果及新请求。
2.数据流
Scrapy中的数据流由引擎控制,数据流的过程如下:
(1)scrapy engine打开一个网站,找到该网站的Sprider,并向该Sprider请求第一个需要爬取的URL。
3.创建项目
在pycharm的终端Terminal : scrapy startproject tutorial ,
然后在pycharm打开该项目得到如下目录:
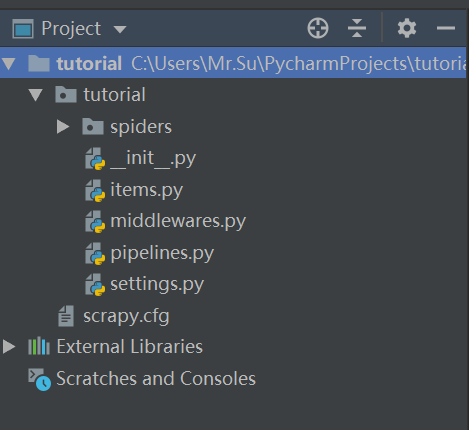
- scrapy.cfg: 项目的配置文件
- tutorial/items.py: 项目中的item文件,定义数据结构。
- tutorial/pipelines.py: 项目中的pipelines文件,数据存储,操作数据。
- tutorial/settings.py: 项目的设置文件。
- tutorial/spiders/: 放置spider代码的目录。
4.创建Spider
spider是自己定义的类,Scrapy用它来抓取内容。并解析抓取的结果。不过这个类必须继承Scrapy提供的Spider类scrapy.Sprider,还要定义Spider的名称和起始请求。
命令行创建spider :  scrapy genspider quotes quotes.toscrape.com

# -*- coding: utf- -*-

import scrapy

class QuotesSpider(scrapy.Spider):

    name = 'quotes' #用来区分不同的Spider

    allowed_domains = ['quotes.toscrape.com'] #允许爬取的域名

    start_urls = ['http://quotes.toscrape.com/'] #spider启动时爬取的url列表

    def parse(self, response):#负责解析返回的响应、提取数据或者进一步生成要处理的请求。
        #response是爬取start_url的结果
pass
4.创建item
item需要继承scrapy.Item类,并且定义类型为scrapy.Field的字段。假设我们需要获取的内容是name、age、 sex。
修改item.py如下:
# -*- coding: utf- -*-

# Define here the models for your scraped items

#保存和爬取数据的容器

# See documentation in:

# https://doc.scrapy.org/en/latest/topics/items.html

import scrapy

class QuoteItem(scrapy.Item):

    # define the fields for your item here like:

    name = scrapy.Field()

    age = scrapy.Field()

    sex = scrapy.Field()

    pass
scrapy demo:爬取http://quotes.toscrape.com/的author、text、tags,并保存为json、csv文件。
items.py
# -*- coding: utf-8 -*-

# Define here the models for your scraped items
#保存和爬取数据的容器
# See documentation in:
# https://doc.scrapy.org/en/latest/topics/items.html

import scrapy

class QuoteItem(scrapy.Item):
    # define the fields for your item here like:
    text = scrapy.Field()
    author = scrapy.Field()
    # tags = scrapy.Field()
    pass
spirders/quotes.py
# -*- coding: utf- -*-

import scrapy

from tutorial.items import QuoteItem

class QuotesSpider(scrapy.Spider):

    name = 'quotes' #用来区分不同的Spider

    allowed_domains = ['quotes.toscrape.com'] #允许爬取的域名

    start_urls = ['http://quotes.toscrape.com/'] #spider启动时爬取的url列表

    def parse(self, response): #负责解析返回的响应、提取数据或者进一步生成要处理的请求

        #数据提取

       quotes = response.css('.quote') #选择所有的quote

       for quote in quotes:

           item = QuoteItem()  #.text::text  表示选择class=text的节点的正文内容

           item['text'] = quote.css('.text::text').extract_first()  #获取节点的内容:.text::text表示获取其内容text

           item['author'] = quote.css('.author::text').extract_first()# .extract_first表示获取其正文的第一个元素

           #item['tags'] = quote.css('.tags::text').extract_first()

           yield item

       next = response.css('.pager .next a::attr("href")').extract_first() #获取下一个需要爬取的页面

       url = response.urljoin(next)#urljoin()将相对url构造成一个绝对url

       yield scrapy.Request(url=url,callback = self.parse) #回调函数

命令行运行: scrapy   crawl   quotes
执行完成后,我们可以在命令行查看运行结果,但是如何把执行结果保存为json文件或者csv文件呢?
scrapy支持多种格式输出:
scrapy crawl quotes -o quotes.json
scrapy crawl quotes -o quotes.csv
#运行成功后,项目根目录里会自动生成json和csv文件。
爬虫——scrapy框架的更多相关文章
- python爬虫scrapy框架——人工识别登录知乎倒立文字验证码和数字英文验证码(2)
操作环境:python3 在上一文中python爬虫scrapy框架--人工识别知乎登录知乎倒立文字验证码和数字英文验证码(1)我们已经介绍了用Requests库来登录知乎,本文如果看不懂可以先看之前 ...
- 爬虫scrapy框架之CrawlSpider
爬虫scrapy框架之CrawlSpider 引入 提问:如果想要通过爬虫程序去爬取全站数据的话,有几种实现方法? 方法一:基于Scrapy框架中的Spider的递归爬取进行实现(Request模 ...
- 安装爬虫 scrapy 框架前提条件
安装爬虫 scrapy 框架前提条件 (不然 会 报错) pip install pypiwin32
- 爬虫Ⅱ:scrapy框架
爬虫Ⅱ:scrapy框架 step5: Scrapy框架初识 Scrapy框架的使用 pySpider 什么是框架: 就是一个具有很强通用性且集成了很多功能的项目模板(可以被应用在各种需求中) scr ...
- Python爬虫Scrapy框架入门(2)
本文是跟着大神博客,尝试从网站上爬一堆东西,一堆你懂得的东西 附上原创链接: http://www.cnblogs.com/qiyeboy/p/5428240.html 基本思路是,查看网页元素,填写 ...
- 爬虫Scrapy框架运用----房天下二手房数据采集
在许多电商和互联网金融的公司为了更好地服务用户,他们需要爬虫工程师对用户的行为数据进行搜集.分析和整合,为人们的行为选择提供更多的参考依据,去服务于人们的行为方式,甚至影响人们的生活方式.我们的scr ...
- 自己动手实现爬虫scrapy框架思路汇总
这里先简要温习下爬虫实际操作: cd ~/Desktop/spider scrapy startproject lastspider # 创建爬虫工程 cd lastspider/ # 进入工程 sc ...
- 爬虫--Scrapy框架课程介绍
Scrapy框架课程介绍: 框架的简介和基础使用 持久化存储 代理和cookie 日志等级和请求传参 CrawlSpider 基于redis的分布式爬虫 一scrapy框架的简介和基础使用 a) ...
- 爬虫--Scrapy框架的基本使用
流程框架 安装Scrapy: (1)在pycharm里直接就可以进行安装Scrapy (2)若在conda里安装scrapy,需要进入cmd里输入指令conda install scrapy ...
- Python网咯爬虫 — Scrapy框架应用
Scrapy框架 Scrapy是一个高级的爬虫框架,它不仅包括了爬虫的特征,还可以方便地将爬虫数据保存到CSV.Json等文件中. Scrapy用途广泛,可以用于数据挖掘.监测 ...
随机推荐
- 搭建windows测试环境的步骤
步骤:1.JDK安装 2.配置好JDK环境变量3.Tomcat安装4.将war包放在Tomcat的发布目录中webapps中,5.conf>server.xml里面设置默认解压,unpackW ...
- Hadoop2.7.6_01_部署
1. 主机规划 主机名称 外网IP 内网IP 操作系统 备注 安装软件 mini01 10.0.0.11 172.16.1.11 CentOS 7.4 ssh port:22 Hadoop [Name ...
- ubuntu集群下ssh配置总结
最重要的前提就是:集群中的所有机器的用户名和用户组必须一样 一般做法都是在每台机器上新建用户组和用户名. 比如:sudo addgroup sparks 新建用户组sparks: sudo addus ...
- [Java] SpringMVC工作原理之四:MultipartResolver
MultipartResolver 用于处理文件上传,当收到请求时 DispatcherServlet 的 checkMultipart() 方法会调用 MultipartResolver 的 isM ...
- VS code常用的几个插件
VScode是一个我最近才开始用的编辑器,在此列几个自己在用的插件,以备换机时的需要. auto close tagbeautify css/sass/scss/lessone dark themes ...
- nginx学习笔记(二)
tail -f /var/log/nginx/access.log 查看nginx访问日志 安装ab压测工具 连接限制只有公有云才能测出,虚拟机只能测请求限制 添加用户 覆盖用户 新增用户 文件是配置 ...
- 数据库 schema含义
数据库Schema有两种含义,一种是概念上的Schema,指的是一组DDL语句集,该语句集完整地描述了数据库的结构.还有一种是物理上的Schema,指的是数据库中的一个名字空间,它包含一组表.视图和存 ...
- centos7下kubernetes(3。部署kubernetes)
环境:三个centos7 K8s2是Master;K8s1是node1:K8s3是node2 官方文档:https://kubernetes.io/docs/setup/independent/ins ...
- 转://Window下安装Oracle ASM单实例数据库
之前做的Oracle ASM实验都是基于Linux或者Unix操作系统的,最近想试试如何在Windows环境下使用Oracle ASM.本文介绍如何在windows下创建裸设备,并创建ASM磁盘组以及 ...
- 【PHP】最详细PHP从入门到精通(一)——想学习PHP的朋友们福利来了!
PHP从入门到精通 (一)PHP简介和基本知识 PHP(外文名:PHP: Hypertext Preprocessor,中文名:“超文本预处理器”)是一种通用开源脚本语言.语法吸收了C语言.Java ...