
走近RDD
RDD(Resilient Distributed Datasets)弹性分布式数据集。RDD可以看成是一个简单的"数组",对其进行操作也只需要调用有限的"数组"中的方法即可,但它与一般数组的区别在于:RDD是分布式存储,可以跟好的利用现有的云数据平台,并在内存中进行。此处的弹性指的是数据的存储方式,及数据在节点中进行存储的时候,既可以使用内存也可以使用磁盘。此外,RDD还具有很强的容错性,在spark运行计算的过程中,不会因为某个节点错误而使得整个任务失败;不通节点中并发运行的数据,如果在某个节点发生错误时,RDD会自动将其在不同的节点中重试。
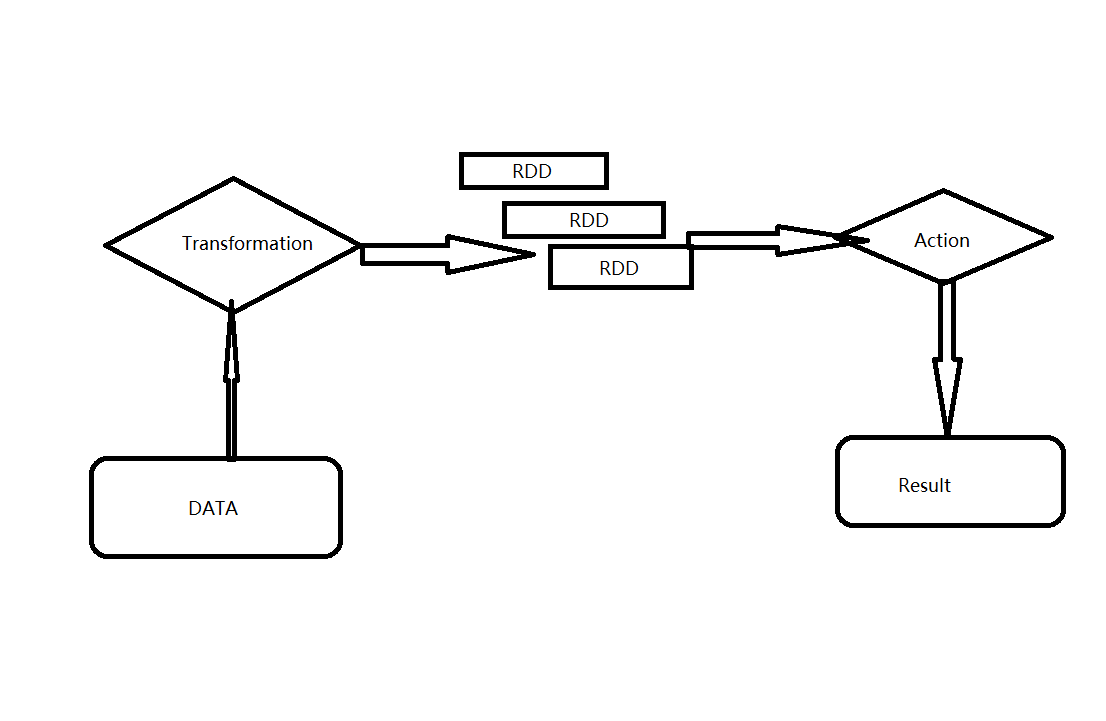
RDD一大特性是延迟计算,即一个完整的RDD运行任务被分成2部分:Transformation和Action。
Transformation用于对RDD的创建。在spark中,RDD只能使用Transformation来创建,同时Transformation还提供了大量的操作方法。RDD还可以利用Transformation来生成新的RDD,这样可以在有限的内存空间中生成竟可能多的数据对象。无论发生了多少次Transformation,此时,在RDD中真正数据计算运行的操作Action都没真正的开始运行。

Action是数据的执行部分,其也提供了大量的方法去执行数据的计算操作部分。

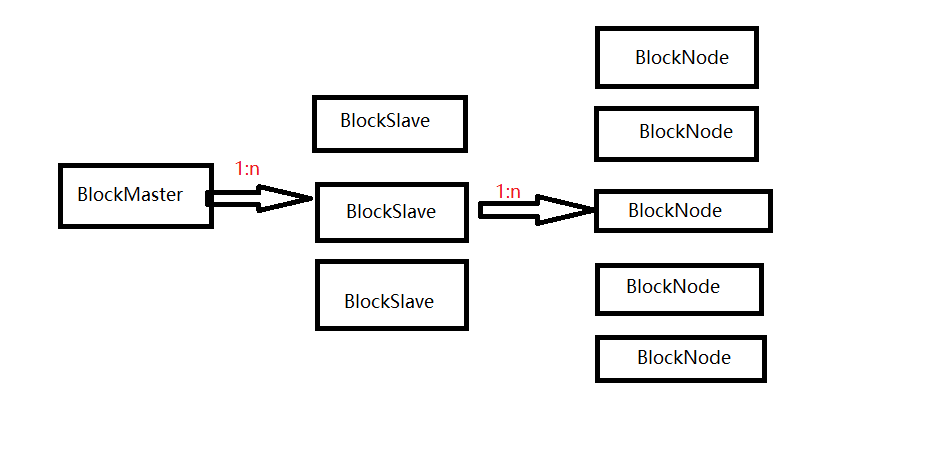
RDD可以将其看成一个分布在不同节点中的分布式数据集,并将数据以数据块(Block)的形式存储在各个节点的计算机中。每个BlockMaster管理着若干个BlockSlave,而每个BlockSlave又管理着若干个BlockNode。当BlockSlave获得了每个Node节点的地址,又会反向向BlockMaster注册每个Node的基本信息,这样就形成了分层管理。
RDD依赖

import org.apache.spark.{SparkConf, SparkContext}

object test {

  def main(args: Array[String]): Unit = {

    val conf=new SparkConf().setMaster("local").setAppName("test")

    val sc=new SparkContext(conf)

    val arr=sc.parallelize(Array(,,,,,,,))//parallelize将内存数据读入Spark系统中,作为整体数据集

    val result=arr.aggregate()(math.max(_,_),_+_)//_+_ 对传递的第一个方法的结果集进行进一步处理

    println(result)

  }

}
结果为8
import org.apache.spark.{SparkConf, SparkContext}

object test {

  def main(args: Array[String]): Unit = {

    val conf=new SparkConf().setMaster("local").setAppName("test")

    val sc=new SparkContext(conf)

    val arr=sc.parallelize(Array("abd","hello world","hello sb"))//parallelize将内存数据读入Spark系统中,作为整体数据集

    val result=arr.aggregate("")((value,word)=>value+word,_+_)//_+_ 对传递的第一个方法的结果集进行进一步处理

    println(result)

  }

}
结果为abdhello worldhello sb
3、cache是将数据内容计算并保存在计算节点的内存中
4、cartesion是用于对不同的数组进行笛卡尔操作,要求是数组的长度必须相同
import org.apache.spark.{SparkConf, SparkContext}

object test {

  def main(args: Array[String]): Unit = {

    val conf=new SparkConf().setMaster("local").setAppName("test")

    val sc=new SparkContext(conf)

    val arr1=sc.parallelize(Array(,,,))//parallelize将内存数据读入Spark系统中,作为整体数据集

    val arr2=sc.parallelize(Array(,,,))

    val res=arr1.cartesian(arr2)

    res.foreach(print)

  }

}
结果:(1,4)(1,3)(1,2)(1,1)(2,4)(2,3)(2,2)(2,1)(3,4)(3,3)(3,2)(3,1)(4,4)(4,3)(4,2)(4,1)
5、Coalesce是将已经存储的数据重新分片后再进行存储(repartition与Coalesce类似)
import org.apache.spark.{SparkConf, SparkContext}

object test {

  def main(args: Array[String]): Unit = {

    val conf=new SparkConf().setMaster("local").setAppName("test")

    val sc=new SparkContext(conf)

    val arr1=sc.parallelize(Array(,,,,,))//parallelize将内存数据读入Spark系统中,作为整体数据集

    val arr2=arr1.coalesce(,true)

    val res1=arr1.aggregate()(math.max(_,_),_+_)

    println(res1)

    val res2=arr2.aggregate()(math.max(_,_),_+_)

    println(res2)

  }

}
结果为6 11
6、countByValue是计算数据集中某个数据出现的个数,并将其以map的形式返回
7、countByKey是计算数据集中元数据键值对key出现的个数
import org.apache.spark.{SparkConf, SparkContext}

object test {

  def main(args: Array[String]): Unit = {

    val conf=new SparkConf().setMaster("local").setAppName("test")

    val sc=new SparkContext(conf)

    val arr1=sc.parallelize(Array((,"a"),(,'b'),(,'c'),(,'d'),(,'a')))//parallelize将内存数据读入Spark系统中,作为整体数据集

    val res1=arr1.countByValue()

    res1.foreach(println)

    val res2=arr1.countByKey()

    res2.foreach(println)

  }

}

//结果:((1,c),1)

((,a),)

((,a),)

((,d),)

((,b),)

(,)

(,)
8、filter是对数据集进行过滤
9、flatMap是对RDD中的数据进行整体操作的一个特殊方法,其在定义时就是针对数据集进行操作
10、map可以对RDD中的数据集进行逐个操作,其与flatmap不同得是,flatmap是将数据集中的数据作为一个整体去处理,之后再对其中的数据做计算,而map则直接对数据集中的数据做单独的处理
11、groupBy是将传入的数据进行分组
12、keyBy是为数据集中的每个个体数据添加一个key,从而形成键值对
13、reduce同时对2个数据进行处理,主要是对传入的数据进行合并处理
14、sortBy是对已有的RDD进行重新排序
import org.apache.spark.{SparkConf, SparkContext}

object test {

  def main(args: Array[String]): Unit = {

    val conf=new SparkConf().setMaster("local").setAppName("test")

    val sc=new SparkContext(conf)

    val arr1=sc.parallelize(Array((,"a"),(,"c"),(,"b"),(,"x"),(,"f")))//parallelize将内存数据读入Spark系统中,作为整体数据集

    val res1=arr1.sortBy(word=>word._1,true)

    val res2=arr1.sortBy(word=>word._2,true)

    res1.foreach(println)

    res2.foreach(println)

  }

}
15、zip可以将若干个RDD压缩成一个新的RDD
走近RDD的更多相关文章
- Spark RDD 核心总结
摘要: 1.RDD的五大属性 1.1 partitions(分区) 1.2 partitioner(分区方法) 1.3 dependencies(依赖关系) 1.4 compute(获取分区迭代列表) ...
- Spark笔记:复杂RDD的API的理解(下)
本篇接着谈谈那些稍微复杂的API. 1) flatMapValues:针对Pair RDD中的每个值应用一个返回迭代器的函数,然后对返回的每个元素都生成一个对应原键的键值对记录 这个方法我最开始接 ...
- Spark笔记:复杂RDD的API的理解(上)
本篇接着讲解RDD的API,讲解那些不是很容易理解的API,同时本篇文章还将展示如何将外部的函数引入到RDD的API里使用,最后通过对RDD的API深入学习,我们还讲讲一些和RDD开发相关的scala ...
- Spark笔记:RDD基本操作(下)
上一篇里我提到可以把RDD当作一个数组,这样我们在学习spark的API时候很多问题就能很好理解了.上篇文章里的API也都是基于RDD是数组的数据模型而进行操作的. Spark是一个计算框架,是对ma ...
- Spark笔记:RDD基本操作(上)
本文主要是讲解spark里RDD的基础操作.RDD是spark特有的数据模型,谈到RDD就会提到什么弹性分布式数据集,什么有向无环图,本文暂时不去展开这些高深概念,在阅读本文时候,大家可以就把RDD当 ...
- Spark核心——RDD
Spark中最核心的概念为RDD(Resilient Distributed DataSets)中文为:弹性分布式数据集,RDD为对分布式内存对象的 抽象它表示一个被分区不可变且能并行操作的数据集:R ...
- 【原】Learning Spark (Python版) 学习笔记(一)----RDD 基本概念与命令
<Learning Spark>这本书算是Spark入门的必读书了,中文版是<Spark快速大数据分析>,不过豆瓣书评很有意思的是,英文原版评分7.4,评论都说入门而已深入不足 ...
- Spark Rdd coalesce()方法和repartition()方法
在Spark的Rdd中,Rdd是分区的. 有时候需要重新设置Rdd的分区数量,比如Rdd的分区中,Rdd分区比较多,但是每个Rdd的数据量比较小,需要设置一个比较合理的分区.或者需要把Rdd的分区数量 ...
- RDD/Dataset/DataFrame互转
1.RDD -> Dataset val ds = rdd.toDS() 2.RDD -> DataFrame val df = spark.read.json(rdd) 3.Datase ...
随机推荐
- ASP.NET WebAPI Get和Post 传参总结
这里我使用Jquery 来发起异步请求实现数据调用. 继续使用上一文章中的示例,添加一个index.html页面,添加对jquery的引用. 一.无参数Get请求 一般的get请求我们可以使用jque ...
- ES6字符串扩展
前面的话 字符串是编程中重要的数据类型,只有熟练掌握字符串操作才能更高效地开发程序.JS字符串的特性总是落后于其它语言,例如,直到 ES5 中字符串才获得了 trim() 方法.而 ES6 则继续添加 ...
- javascript基础知识3#引用类
引用类 引用类型的只是引用类型的一个实例,在ecmascript当中,引用类型是一种数据结构用于将数据和功能组织在一起,也常被称做类. object类型 构造函数[var o = new object ...
- 移动Web学习笔记(第1天)-bootstrap框架的使用
移动web前言 移动web : 移动端手机浏览器或者微信里面浏览的网页 移动APP : 手机上需要下载安装的应用程序 1. 移动web介绍 1.1 3 天 响应式开发 一套代码运行多个终端 优点:开发 ...
- [vijos NOIP模拟题]天神下凡 贪心+搜索
样例: 考试的时候没时间打了,随便敲了敲就交上去了,没想到竟然编译错误,忘定义n了23333 自己测了测能骗20分hhhh 考虑每个圆对答案的贡献,当一个圆被小圆内切的时候,分成了两半,对答案的贡献就 ...
- 米扑科技的开源项目:sitemap-php 自动生成网站地图
米扑科技旗下的产品,近期正在做SEO网站优化,其中子需求之一是调研实现了网站地图(sitemap.xml) 封装简化了许多功能模块,现在分享出来,源代码可在Github上下载,有简单的示例. Gith ...
- Session获取不到的情况及解决办法(源码解析)
本博客是自己在学习和工作途中的积累与总结,仅供自己参考,也欢迎大家转载,转载时请注明出处,请尊重他人努力成果,谢谢. 1. 当有连个sessionFactory时,容易产生获取不到session的情况 ...
- Linux学习总结(九)—— CentOS常用软件安装:中文输入法、Chrome
中文输入法 切换到root用户,运行以下命令: yum install "@Chinese Support" 按照提示,一路Yes等待安装完成.安装完成后点击左上角System - ...
- ThinkPHP5 封装邮件发送服务(可带附件)
1.Composer 安装 phpmailer composer require phpmailer/phpmailer 2.ThinkPHP 中封装邮件服务类 我把它封装在扩展目录 extend/M ...
- 【Hadoop】NameNode
一.背景介绍 当数据集的大小超过一台独立的物理计算机的存储能力时,就有必要对它进行分区(partition)并存储到多台单独的计算机上.管理网络中跨多台计算机存储的文件系统称为分布式文件系统(dist ...