
Centos7单机部署ELK
一、 简介
1.1 介绍
ELK是三个开源工具组成,简单解释如下:
Elasticsearch是个开源分布式搜索引擎,它的特点有:分布式,零配置,自动发现,索引自动分片,索引副本机制,restful风格接口,多数据源,自动搜索负载等。
Logstash是一个完全开源的工具,它可以对你的日志进行收集、过滤,并将其存储供以后使用(如,搜索)。
Kibana 也是一个开源和免费的工具,它可以为 Logstash 和 ElasticSearch 提供的日志分析友好的 Web 界面,可以帮助您汇总、分析和搜索重要数据日志。
1.2 场景分析
日志主要包括系统日志、应用程序日志和安全日志等等。运维人员和开发人员可以通过日志了解服务器软硬件信息、检查配置过程中的错误及错误发生的原因。经常分析日志可以了解服务器的负荷,性能安全性,从而及时采取措施纠正错误。
通常,日志被分散的储存不同的设备上。如果你管理数十上百台服务器,你还在使用依次登录每台机器的传统方法查阅日志。这样是不是感觉很繁琐和效率低下。当务之急我们使用集中化的日志管理,例如:开源的syslog,将所有服务器上的日志收集汇总。
集中化管理日志后,日志的统计和检索又成为一件比较麻烦的事情,一般我们使用grep、awk和wc等Linux命令能实现检索和统计,但是对于要求更高的查询、排序和统计等要求和庞大的机器数量依然使用这样的方法难免有点力不从心。
这里采用开源实时日志分析ELK平台能够完美的解决我们上述的问题,当然也还有别的平台或者工具可以使用,这里只讨论ELK,官方网站:https://www.elastic.co
二、安装Elasticsearch
2.1 安装jdk
# java -version

java version "1.8.0_121"

Java(TM) SE Runtime Environment (build 1.8.0_121-b13)

Java HotSpot(TM) 64-Bit Server VM (build 25.121-b13, mixed mode)
2.2 安装Elasticsearch
# tar -zxvf elasticsearch-5.6.3.tar.gz

# mv elasticsearch-5.6.3 /data/elasticsearch

# cd elasticsearch/config/

# 备份配置文件

# cp elasticsearch.yml elasticsearch.yml.bak
编辑配置文件
# cat elasticsearch.yml | grep -v ^#

cluster.name: elk-application

node.name: node-1

path.data: /data/elasticsearch/data

path.logs: /data/elasticsearch/logs

network.host: 172.16.220.248

http.port: 9200

discovery.zen.ping.unicast.hosts: ["node-1"]

discovery.zen.minimum_master_nodes: 1
添加elasticsearch用户,不能使用root启动
# groupadd -g 1008 elasticsearch

# useradd -g 1008 -u 1008 elasticsearch

# chown -R elasticsearch:elasticsearch /data/elasticsearch/
修改sysctl.conf文件
# vim /etc/sysctl.conf

vm.max_map_count = 262144

# sysctl -p
修改/etc/security/limits.conf文件,修改打开文件句柄
*               soft    nofile          100000

*               hard    nofile          100000

*               soft    nproc           100000

*               hard    nproc           100000
添加hosts文件
# vim /etc/hosts

172.16.220.248 node-1
启动
# su -s elasticsearch

# cd /data/elasticsearch/bin

# ./elasticearch &
查看是否启动
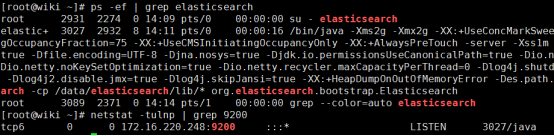
简单的curl测试
# curl http://172.16.220.248:9200

三、安装Logstash和filebeat
filebeat用于在各个服务器上获取数据,发送到logstash上,再由logstash处理数据。
3.1 安装logstash
# tar -zxvf logstash-5.6.3.tar.gz

# mv logstash-5.6.3 /data/logstash
3.2 安装filebeat
下载filebeat并启动,通过它来监听数据源文件的新增内容经过logstash处理后上传到es里面
# tar -zxvf filebeat-5.6.3-linux-x86_64.tar.gz

# mv filebeat-5.6.3-linux-x86_64 /data/filebeat

# cd /data/filebeat

# cp filebeat.yml filebeat.yml.bak
编辑filebeat.yml文件
filebeat.prospectors:

- input_type: log

  paths:

    - /var/log/message-log  # 测试本机的一个log文件

output.logstash:

  hosts: ["172.16.220.248:5044"]
启动filebeat服务
# cd /data/filebeat

# ./filebeat &
查看启动,filebeat没有监听端口,主要看日志和进程
# tialf logs/filebeat

# ps -ef | grep filebeat
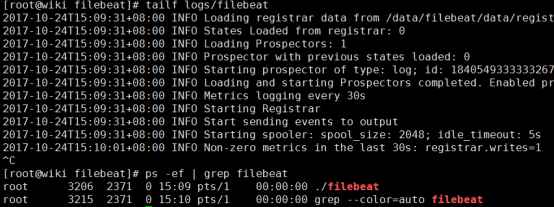
filebeat监听的文件记录信息在/data/filebeat/data/registry
新建一个本地文件message-log,可以取几条本机系统的messages文件
3.3 启动logstash
最后新建一个logstash的启动指定test.conf配置文件,内容如下:
input {

    beats {

      port => "5044"

    }

}

output {

   elasticsearch {

   hosts => "172.16.220.248:9200"

  }

  stdout { codec => rubydebug }   # 这是将输出打印在屏幕上,可以注释掉

}
Logstash默认有input、filter、output三个区域,一般最少需要配置input和output即可!
logstash的本身默认的logstash.yml配置文件选择不修改即可!
简单测试一下logstash不指定配置文件启动
# cd /data/filebeat/bin

# ./logstash -e 'input { stdin {} } output {stdout {} }'
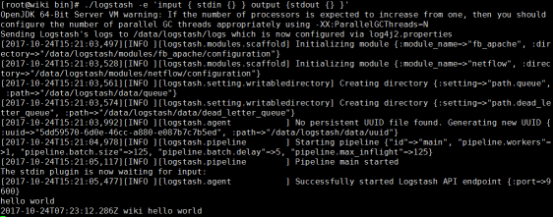
我们手动输入 hello world,它也会输出 hello world
指定配置文件启动logstash
# ./logstash -f ../config/test.conf &
查看5044端口和9600端口是否开启

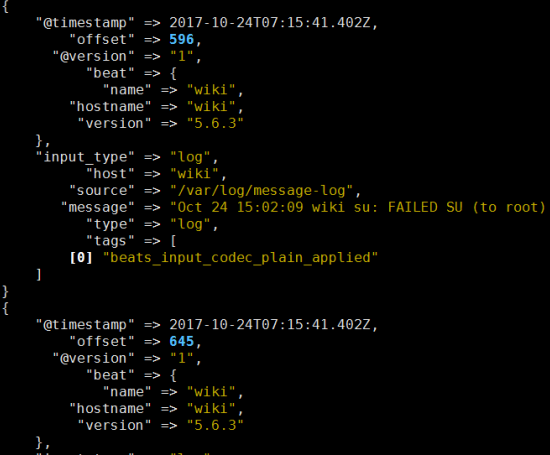
等待一会后应该会出现如下信息输出,这也就是test.conf里面最后一行定义输出到屏幕上
四、安装kibana
# tar -zxvf kibana-5.6.3-linux-x86_64.tar.gz

# mv kibana-5.6.3-linux-x86_64 /data/kinbana

# cd /data/kinbana/config/

# cp kibana.yml kibana.yml.bak
编辑kibana.yml配置文件
# vim kibana.yml

server.port: 5601

server.host: "172.16.220.248"

elasticsearch.url: "http://172.16.220.248:9200"
启动kinbana
# cd /data/kibana/bin

# ./kibana &
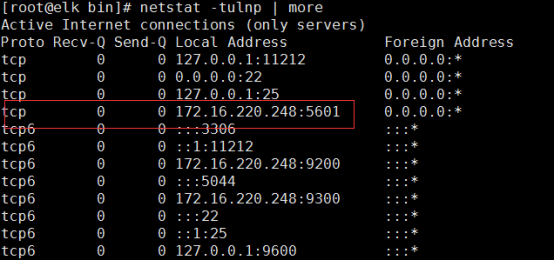
查看端口
浏览器登入查看

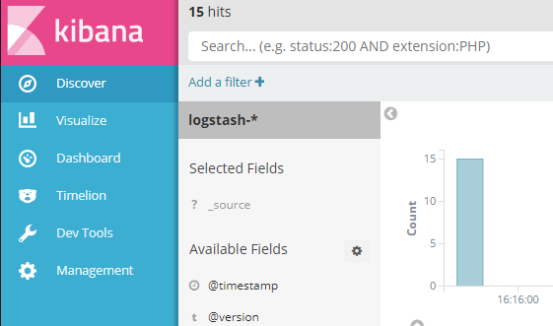
点击create按钮后,然后点击上面的discover按钮,注意如果没数据的话,注意看看导入的时间@timestamp和现在的时间对比一下,kibana默认只显示最近15分钟的数据,如果超出15分钟请选择适当的时间,从kibana可以看到messages-log里面的15条数据都正常导入了。这就也完成我们的实现的第一个效果。但是这仅仅是把流程跑通了,接下来我们需要做的事情还有更多。注意只能先导入数据到es后才能在kibana创建索引。
五、获取Nginx access日志
Nginx日志格式在logstash的grok里面默认是没有的,需要我们手动配置,可以通过http://grokdebug.herokuapp.com/ 在线工具来判断配置是否正确。
5.1 在nginx服务器上安装filebeat
服务器: 172.16.200.160
# tar -zxvf filebeat-5.6.3-linux-x86_64.tar.gz

# mv filebeat-5.6.3-linux-x86_64 /data/filebeat

# cd /data/filebeat

# cp filebeat.yml filebeat.yml.bak
修改filebeat配置文件
# cat filebeat.yml | grep -v ^$ | grep -v ^# | grep -v "#"

filebeat.prospectors:

- input_type: log

  paths:

    - /data/nginx/logs/160_access.log

   document_type: nginx_access

output.logstash:

  hosts: ["172.16.220.248:5044"]
启动filebeat
# ./filebeat &
5.2 重新配置logstash启动配置文件
nginx日志格式,根据业务要求,我们这做了一些修改,比如增加cookie等,修改access.log日志时间格式等,这个会在另外的博客中写出来,会给出链接的。
Nginx日志格式
log_format main

                '[$time_local] - $remote_addr:$remote_port - $upstream_addr $upstream_status $upstream_response_time - '

                '"$request" $status $bytes_sent $request_time '

                '"$http_referer" - "$http_user_agent" - '

                '"$customerTag_cookie" - "$ym_cookie" - "$http_cookie" '

                '"$http_x_forwarded_for"';

# 这里只是我们自己的格式,各位可以根据自己要求增删
grok使用表达式
可能我理解不是很到位,写的也比较复杂,我会把匹配对应项一一写出来,大家可以自己理解,然后为自己的项目配置
%{SYSLOG5424SD} - %{IPV4:clientip}:%{NUMBER:clientport} - %{IPV4:hostip}:%{NUMBER:itemport} %{INT:upstream_status} %{NUMBER:response_time} - \"%{WORD:method} %{URIPATHPARAM:request} HTTP/%{NUMBER:http_version}\" %{INT:status} %{INT:body_bytes_sent} %{NUMBER:request_time} %{QS:url} - %{QS:user_agent} - %{QS:customerTag} - %{QS:ym_traffic_session_id} - %{QS:all_cookies} %{IPV4:realip}
grok匹配说明
%{SYSLOG5424SD}
|
时间格式 |
%{IPV4:clientip}
|
获取ip,clientip是自己命名的 |
%{NUMBER:clientport}
|
NUMBER匹配数字 |
%{INT:upstream_status}
|
INT整形 |
%{WORD:method}
|
WORD单词 |
%{URIPATHPARAM:request}
|
获取请求内容request |
%{QS:url}
|
QS可以获取一段字符串 |
修改logstash启动配置文件
input {

    beats {

      port => "5044"

    }

}

filter {

    if [type] == "nginx_access" {

    grok {

        match => {"message" => "%{SYSLOG5424SD} - %{IPV4:clientip}:%{NUMBER:clientport} - %{IPV4:hostip}:%{NUMBER:itemport} %{INT:upstream_status} %{NUMBER:response_time} - \"%{WORD:method} %{URIPATHPARAM:request} HTTP/%{NUMBER:http_version}\" %{INT:status} %{INT:body_bytes_sent} %{NUMBER:request_time} %{QS:url} - %{QS:user_agent} - %{QS:customerTag} - %{QS:ym_traffic_session_id} - %{QS:all_cookies} %{IPV4:realip}"}

      }

    mutate {

       remove_field => "message"   # 把message字段去掉,它会将上面单项获取的信息做个汇总,这样就重复了

    }

  }

}

output {

   elasticsearch {

   hosts => "172.16.220.248:9200"

  }

#stdout { codec => rubydebug }

}
测试一下配置文件
./logstash -t -f ../config/logstash.conf

重启logstash
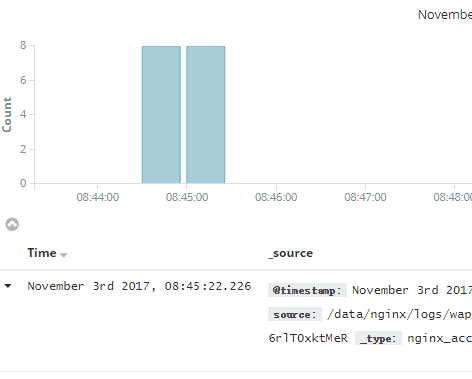
不出问题elasticsearch 和kibana中就会有数据了
Centos7单机部署ELK的更多相关文章
- Centos7单机部署ELK+x-pack
ELK分布式框架作为现在大数据时代分析日志的常为大家使用.现在我们就记录下单机Centos7部署ELK的过程和遇到的问题. 系统要求:Centos7(内核3.5及以上,2核4G) elk版本:6.2. ...
- centos7.5部署ELk
第1章 环境规划 1.1 ELK介绍 ELK是ElasticSerach.Logstash.Kibana三款产品名称的首字母集合,用于日志的搜集和搜索. Elasticsearc ...
- 单机部署 ELK
对于一个体量不大的系统,运行在单机上的 ELK 就足以胜任日志的处理任务了.本文介绍如何在单台服务器上安装并配置 ELK(elalasticsearch + logstash + kibana),并最 ...
- Linux下单机部署ELK日志收集、分析环境
一.ELK简介 ELK是elastic 公司旗下三款产品ElasticSearch .Logstash .Kibana的首字母组合,主要用于日志收集.分析与报表展示. ELK Stack包含:Elas ...
- 最新Centos7.6 部署ELK日志分析系统
下载elasticsearch 创建elk用户并授权 useradd elk chown -R elk:elk /home/elk/elasticsearch chown -R elk:elk /ho ...
- CentOS7单机部署lamp环境和apache虚拟主机
(1)apache介绍 apache : httpd.apache.org 软件包:httpd 端口服务:80/tcp(http) 443/tcp(https,http+ssl) 配置文件: /etc ...
- Hadoop2-认识Hadoop大数据处理架构-单机部署
一.Hadoop原理介绍 1.请参考原理篇:Hadoop1-认识Hadoop大数据处理架构 二.centos7单机部署hadoop 前期准备 1.创建用户 [root@web3 ~]# useradd ...
- Hadoop生态圈-CentOs7.5单机部署ClickHouse
Hadoop生态圈-CentOs7.5单机部署ClickHouse 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 到了新的公司,认识了新的同事,生产环境也得你去适应新的集群环境,我 ...
- linux单机部署kafka(filebeat+elk组合)
filebeat+elk组合之kafka单机部署 准备: kafka下载链接地址:http://kafka.apache.org/downloads.html 在这里下载kafka_2.12-2.10 ...
随机推荐
- LeetCode 845——数组中的最长山脉
1. 题目 2. 解答 2.1 方法一 left 数组表示当前元素左边比当前元素小的元素个数,right 数组数组表示当前元素右边比当前元素小的元素个数.在山脉的中间 B[i] 处,其左边和右边肯定都 ...
- NO.1:自学python之路------Hello world、判断、循环
引言 人工智能如今越来越贴近生活,在这里将记录我自学python与tensorflow的过程.编程使用IDE:visual studio 2017,python版本3.6.4,tensorflow版本 ...
- Django 使用 Celery 实现异步任务
对于网站来说,给用户一个较好的体验是很重要的事情,其中最重要的指标就是网站的浏览速度.因此服务端要从各个方面对网站性能进行优化,比如可采用CDN加载一些公共静态文件,如js和css:合并css或者js ...
- 【转】SWFUpload 官方说明文档(2.5.0版)
原文出自:http://www.runoob.com/w3cnote/swfupload-document.html SWFUpload使用指南请查阅:http://www.w3cschool.cc/ ...
- 关于《数据结构》课本KMP算法的理解
数据结构课上讲的KMP算法和我在ACM中学习的KMP算法是有区别的,这里我对课本上的KMP算法给出我的一些想法. 原理和之前的KMP是一样的https://www.cnblogs.com/wkfvaw ...
- Split the Number(思维)
You are given an integer x. Your task is to split the number x into exactly n strictly positive inte ...
- ASP.NET MVC5 学习系列之视图
一.视图约定 当创建一个项目模版时,可以注意到,项目以一种非常具体的方式包含了一个结构化的Views目录.在每一个控制器的View文件夹中,每一个操作方法都有一个同名的视图文件与其对应.(约定大于配置 ...
- CodeForces Round #527 (Div3) D1. Great Vova Wall (Version 1)
http://codeforces.com/contest/1092/problem/D1 Vova's family is building the Great Vova Wall (named b ...
- (九) 使用Jmeter 做分布式压测 ;
在使用Jmeter进行性能测试时,如果并发数比较大(比如最近项目需要支持1000并发),单台电脑的配置(CPU和内存)可能无法支持,这时可以使用Jmeter提供的分布式测试的功能. 一.Jmeter分 ...
- C++11 锁 lock
转自:https://www.cnblogs.com/diegodu/p/7099300.html 互斥(Mutex: Mutual Exclusion) 下面的代码中两个线程连续的往int_set中 ...