
Spark SQL利器:cacheTable/uncacheTable





Spark SQL利器:cacheTable/uncacheTable的更多相关文章
- Spark SQL利器:cacheTable/uncacheTable【转】
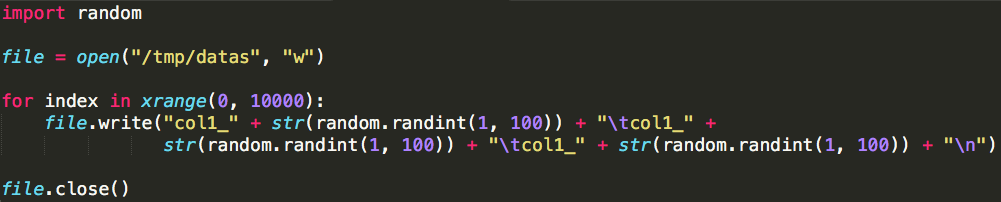
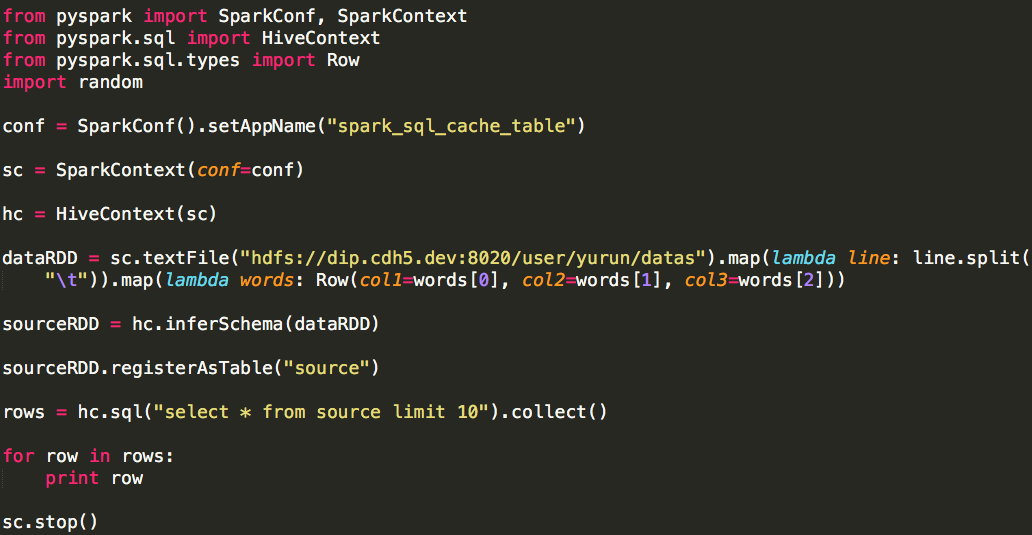
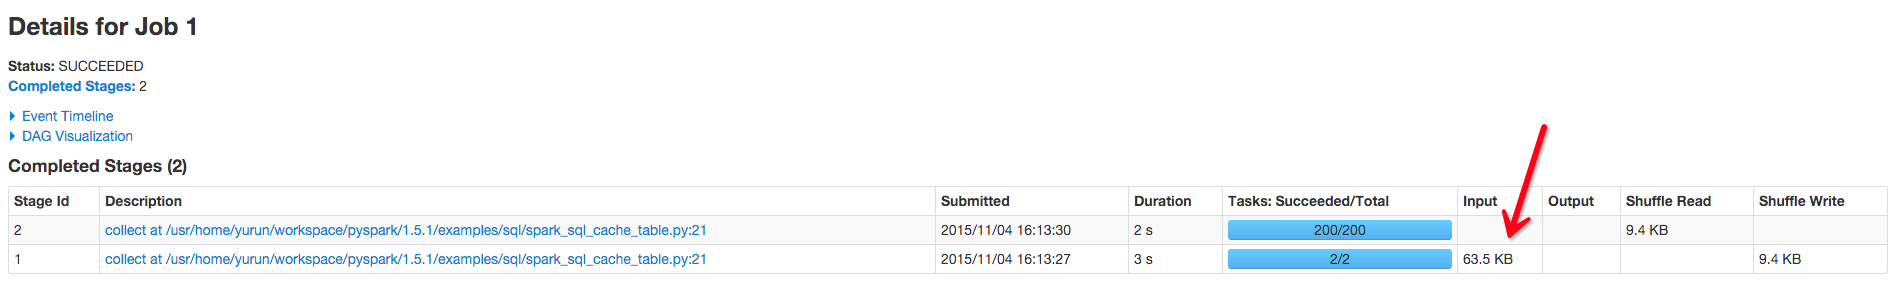
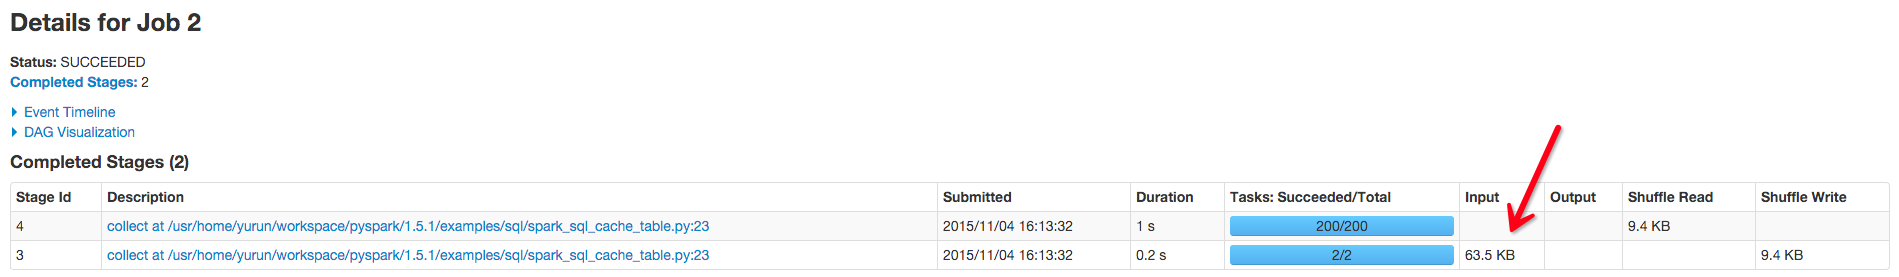
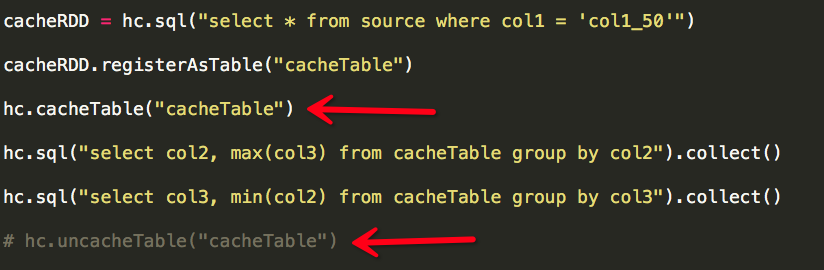
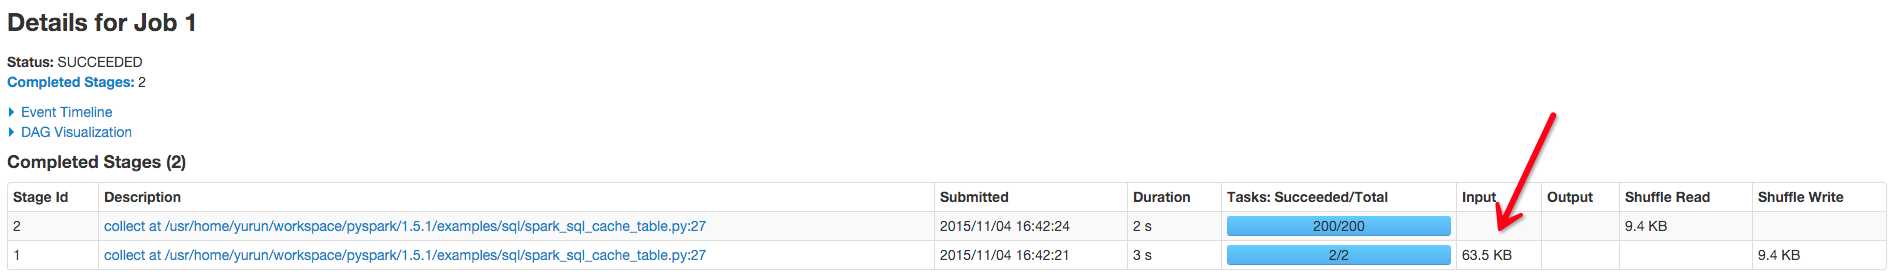
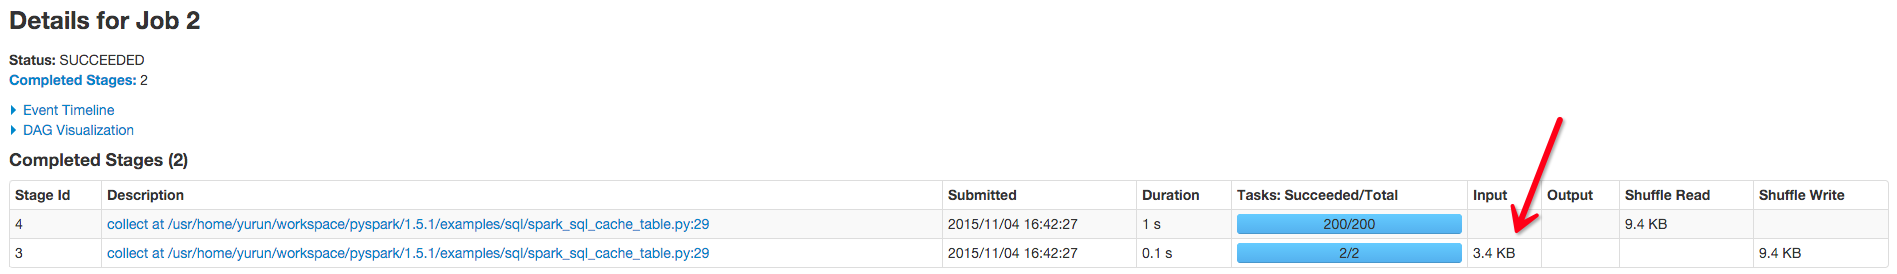
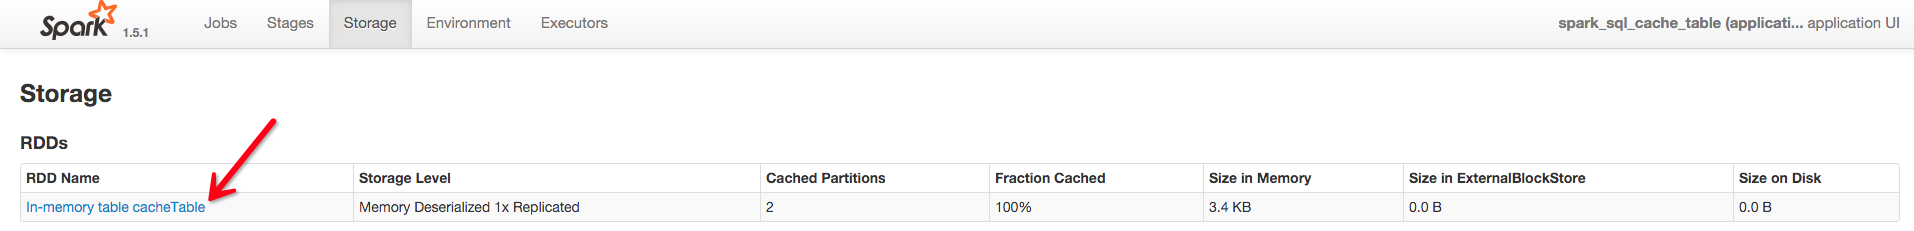
转自:http://www.cnblogs.com/yurunmiao/p/4936583.html Spark相对于Hadoop MapReduce有一个很显著的特性就是“迭代计算”(作为一个Map ...
- Spark 官方文档(5)——Spark SQL,DataFrames和Datasets 指南
Spark版本:1.6.2 概览 Spark SQL用于处理结构化数据,与Spark RDD API不同,它提供更多关于数据结构信息和计算任务运行信息的接口,Spark SQL内部使用这些额外的信息完 ...
- Spark SQL 官方文档-中文翻译
Spark SQL 官方文档-中文翻译 Spark版本:Spark 1.5.2 转载请注明出处:http://www.cnblogs.com/BYRans/ 1 概述(Overview) 2 Data ...
- Spark SQL 之 Performance Tuning & Distributed SQL Engine
Spark SQL 之 Performance Tuning & Distributed SQL Engine 转载请注明出处:http://www.cnblogs.com/BYRans/ 缓 ...
- spark sql cache
1.几种缓存数据的方法 例如有一张hive表叫做activity 1.CACHE TABLE //缓存全表 sqlContext.sql("CACHE TABLE activity" ...
- Spark SQL 初步
已经Spark Submit 2013哪里有介绍Spark SQL.就在很多人都介绍Catalyst查询优化框架.经过一年的发展后,.今年Spark Submit 2014在.Databricks放弃 ...
- Spark SQL笔记——技术点汇总
目录 概述 原理 组成 执行流程 性能 API 应用程序模板 通用读写方法 RDD转为DataFrame Parquet文件数据源 JSON文件数据源 Hive数据源 数据库JDBC数据源 DataF ...
- Apache Spark 2.2.0 中文文档 - Spark SQL, DataFrames and Datasets Guide | ApacheCN
Spark SQL, DataFrames and Datasets Guide Overview SQL Datasets and DataFrames 开始入门 起始点: SparkSession ...
- Spark SQL官方文档阅读--待完善
1,DataFrame是一个将数据格式化为列形式的分布式容器,类似于一个关系型数据库表. 编程入口:SQLContext 2,SQLContext由SparkContext对象创建 也可创建一个功能更 ...
随机推荐
- SQL中存储过程的例子
导读:sql存储是数据库操作过程中比较重要的一个环节,对于一些初学者来说也是比较抽象难理解的,本文我将通过几个实例来解析数据库中的sql存储过程,这样就将抽象的事物形象化,比较容易理解. 例1: cr ...
- 总结如何实现Android浮动层,主要是dialog的使用
自定义一个类继承自Dialog类,然后在构造方法中,定义这个dialog的布局和一些初始化信息. 查看源码打印? 01 public class MenuDialog extends Dialog { ...
- github上建站和使用markdown写文章
积累了那么久,终于成功搭建了github上的个人网站.虽然方法有点巧妙.不是还是建成了 同时学会用markdown写基本的文章.感觉还可以.附带我的github上的静态页面网站的网址:http://z ...
- Handler 原理分析和使用(二)
在上篇 Handler 原理分析和使用(一)中,介绍了一个使用Handler的一个简单而又常见的例子,这里还有一个例子,当然和上一篇的例子截然不同,也是比较常见的,实例如下. import andro ...
- fmt:formatDate标签的输出格式
http://blog.csdn.net/lidawei201/article/details/7197834
- ERROR ITMS-90167: "No .app bundles found in the package"
http://stackoverflow.com/questions/37838487/error-itms-90167-no-app-bundles-found-in-the-package 简单说 ...
- JSP三个指令及9个内置对象
注:本文编写方便自己以后用到时查阅 三大指令:include. page.taglib include指令: 作用: 在当前页面用于包含其他页面 语法: <%@include file=&qu ...
- C++拷贝构造函数详解 转
一. 什么是拷贝构造函数 首先对于普通类型的对象来说,它们之间的复制是很简单的,例如: [c-sharp] view plaincopy int a = 100; int b = a; 而类对象与普通 ...
- Ajax and JSON
Ajax (核心是XMLHttpRequest对象) 1.XMLHttpRequest对象: request=new XMLHttpRequest() 支持Firefox opera Safari ...
- FileStream读写文件流
用FileStream 读取文件流并显示给文件内容 string p = @"C:\Users\Administrator\Desktop\1.txt"; FileStream f ...